
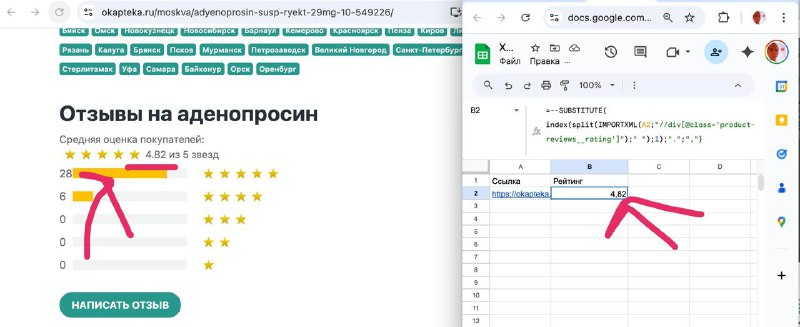
Друзья, привет! Некоторые сайты можно парсить прямо из Google Таблиц с помощью
IMPORTXML.Задача
Из страницы:
https://okapteka.ru/moskva/adyenoprosin-susp-ryekt-29mg-10-549226/
нужно достать рейтинг товара (например, 4.82 из 5 звезд).
В коде страницы нужный элемент выглядит так:
<div class="product-reviews__rating">4.82 из 5 звезд</div>
🧠 XPath-запрос
Чтобы достать эти данные, используем XPath:
//div[@class='product-reviews__rating']
Разбираем:
1.
// - ищем в любом месте документа2.
div - тип элемента, который ищем3.
[@class='product-reviews__rating'] - фильтруем: берём только те div, где атрибут class равен "product-reviews__rating"Формула в Google Таблицах
=--SUBSTITUTE(INDEX(
  SPLIT(IMPORTXML(A2;"//div[@class='product-reviews__rating']");" ");
1);
".";",")
Формула пошагово:
1.
IMPORTXML - тянет содержимое <div> (например, "4.82 из 5 звезд")2.
SPLIT(...;" ") - разбивает по пробелам - {"4.82" \ "из" \ "5" \ "звезд"}3.
INDEX(...;1) - берёт первое значение - "4.82"
4. SUBSTITUTE(...;".";",") - заменяет точку на запятую (для русской локали)5.
VALUE(...) или --(...) - превращает текст "4,82" в число 4,82📌 В итоге в ячейке вы получите чистое число
4,82, готовое для расчётов, фильтрации и красивых дашбордов.Задавайте вопросы в нашем чате: @google_spreadsheets_chat