داستان فوق العاده جذاب و مهم auto instrumentation رو جدی بگیرید
تصور کنید سرویس شما کلی http call به سرویس های مختلف داخلی و خارجی میزنه، این http callها ممکنه توسط یک یا چند تابع محدود در سرویس شما اتفاق نیفته و ممکنه توسط تعداد زیاد و متنوعی از توابع و متدهای سرویس شما اتفاق بیفته. شما چطور میخواید متوجه بشید که وضعیت هر http call چیه؟ آدرس های مختلفی که بهشون درخواست میزنید چه پاسخی میدن؟ برای هر آدرس میانگین response time چقدره؟
احتمالا کاری که میکنید اضافه کردن یه سری metric هست که توسط اون metricها به این آمار برسید.
حالا اگه سرویس شما خیلی بزرگ باشه و از روز اول براش metric ننوشته باشید چی؟ چطور این موارد رو بررسی می کنید؟ کار خیلی سختیه که بخواید خودتون یه سری metric اضافه کنید.
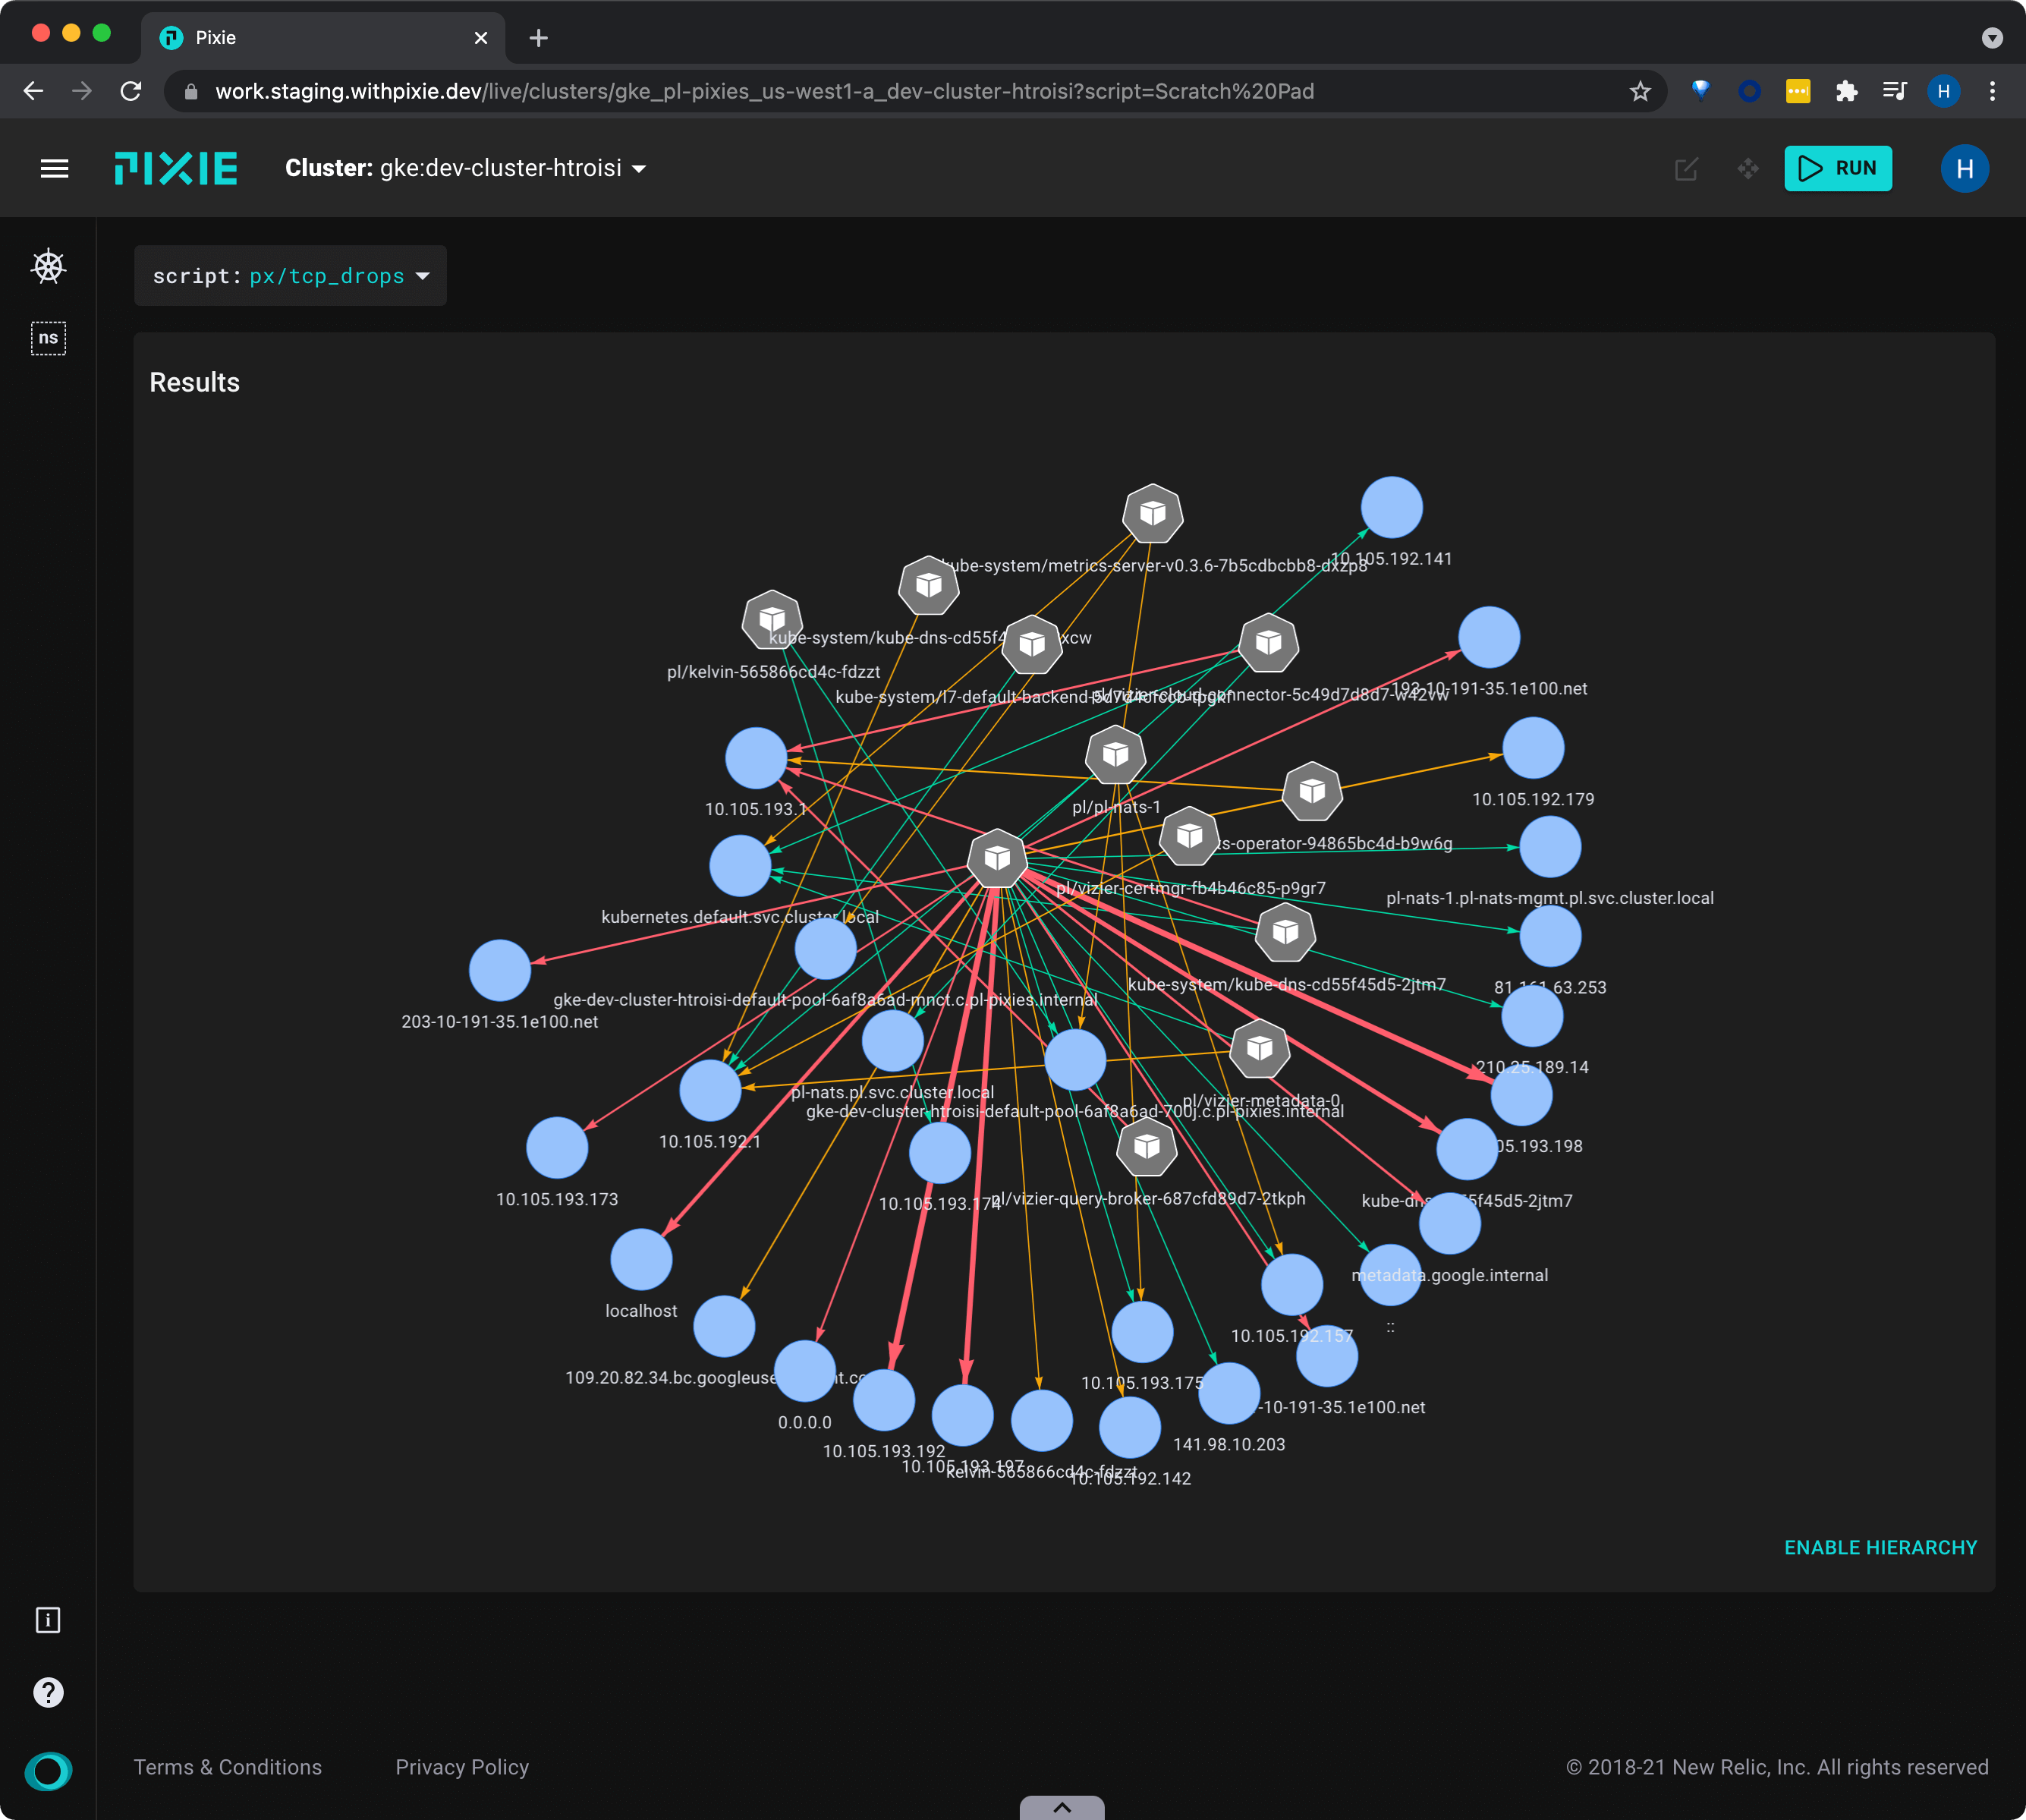
مثلا این تصویر بصورت real time آمار tcp drops رو نشون میده.
مفهوم auto instrumentation خیلی به شما کمک میکنه که بدون اینکه خودتون درگیر نوشتن یه سری کد برای observable کردن سیستم بشید، بصورت خودکار یه سری آمار و ارقام و metric در اختیار شما قرار بگیره که وضعیت سرویس رو بررسی کنید.
این آمار و ارقام فقط در مورد http reqeust نیست، میتونه در مورد dns queries باشه، میتونه در مورد service map باشه که ارتباط سرویس های مختلف شما با همدیگه رو بصورت real-time نشون بده، میتونه در مورد database queries باشه و غیره.
در چند سال اخیر به لطف ebpf ابزارهای مختلفی تو این زمینه توسعه داده شده که من لینک چند تاشون رو اینجا میذارم برید بررسی کنید.
https://github.com/cilium/hubble/
https://github.com/grafana/beyla
https://github.com/coroot/coroot
https://docs.px.dev/tutorials/pixie-101/network-monitoring/
@gocasts
#monitoring #ebpf #observability
Post #333
3.78K
- 👍 25
- 🔥 2