
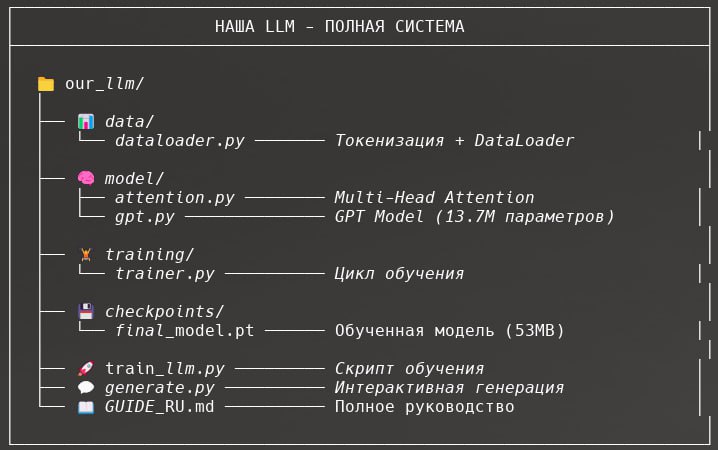
Нет, не чтобы конкурировать с OpenAI - это было бы тупо.
А чтобы наконец понять, как эта хуйня работает изнутри.
Почему это важно
Когда ты используешь Claude или GPT как чёрный ящик - ты не понимаешь, почему модель выдаёт именно такой результат.
Почему галлюцинирует. Почему на один промпт отвечает огонь, а на другой - полную дичь. Почему temperature 0.7 работает лучше чем 1.0.
Когда собираешь сам - начинаешь видеть:
1/ Attention (механизм внимания) - почему модель "смотрит" на определённые токены, а другие игнорит
2/ Temperature - это буквально деление логитов на число, никакой магии
3/ Почему контекст ограничен - не жадность OpenAI, а квадратичная сложность attention
4/ Как модель учится - просто предсказывает следующий токен, всё
Что я сделал
Взял книгу Sebastian Raschka "Build a Large Language Model (From Scratch)" и прошёл первые 5 глав:
- Token и Position Embeddings
- Multi-Head Causal Self-Attention
- Transformer блоки с Layer Norm
- Feed-Forward сети с GELU
- Генерация текста (greedy, temperature, top-k)
Обучил на небольшом тексте (20K символов). За 20 эпох loss упал с 10.5 до 2.7. Модель начала генерить связные предложения.
Весь код - ~600 строк Python.
Как начать
pip install torch tiktoken
Минимальная модель - 13M параметров. Обучается на CPU за час.
Дальше можно увеличить до 124M (как GPT-2), обучить на своих данных, сделать fine-tuning под классификацию или чат-бот.
Итого
Понимание LLM изнутри - это конкурентное преимущество. Не потому что ты будешь делать свои модели для прода. А потому что будешь лучше использовать чужие.
Когда видишь, что "магия" GPT - это матричные умножения и softmax, всё становится понятнее. И ты перестаёшь быть юзером, который тыкает в API наугад или верит в искуственный интеллект)