TGViewer
Channel Public Channel
Full-time nerd

Full-time nerd

@ftbore

Эмиграция, IT, финансы и путешествия
Subscribers
610
Photos
1.6K
Videos
46
Links
472

Showing posts older than #2122 · Back to latest

Older Posts 15 shown
Post #2119 269
Кроме Gemma 4 31B и 26B-A4B, Alibaba выпустила Dense Qwen3.6-27B и Mixture of Experts Qwen3.6-35B-A3B, разделяющие на текущий момент топ среди моделей размером ± 30 миллиардов параметров.

И наконец можно сказать, что модели, обладающие хоть какой-то адекватностью, влезают в память обычного игрового ПК с 16Gb видео + 32Gb обычной памяти.

Причём влезают вместе с большим контекстом - в случае с MoE Qwen, с запасом влезает 262144 токенов, а в случае с dense - 120000 токенов (но dense на 27B и умнее значительно) при квантизации Q6.

Можно уже задавать вопросы по среднего размера пет-проекту и так далее, you name it.

При подключении в VS Code через Cline "втупую" с помощью LM Studio работает не очень быстро, но работает. Наверняка можно выжать больше токенов, но мне не очень хочется инвестировать время в это.

А ещё у Qwen нормально работают размышления "из коробки", в отличие от Gemma

Вообще, у всех этих локальных моделей вайб каких-то выживальщиков:
"Наконсервирую моделей на случай апокалипсиса, а там видно будет", "Вот наступит апокалипсис, я запущу свой дизель-генератор и буду задавать Gemma свои вопросики"

Реальных причин для их использования в реальной жизни нет, если вы не занимаетесь опасной\преступной\покрытой NDA\какой-нибудь журналистской деятельностью и крайне боитесь утечек памяти.

Ну или вы запускаете uncensored-версии и пишете highly-personalized секс-рассказы в параллель с изготовлением нелегальных субстанций, бог вам судья😐
  • 👍 10
  • 🤯 2
Post #2118 278
Full-time nerd Я не успел привыкнуть к Opus 4.6, как вышел Opus 4.7 Как обычно - быстрее, выше, сильнее, контекстнее, кибербезопаснее, умнее. Для разработчиков внедрили новый уровень контроля рассуждений xhigh (между high и max) и бета-версию «бюджетов задач» в API для…
Claude выпустили postmortem по следам возмущений коммьюнити деградацией Opus 4.6

Postmortem - процедура детального анализа проблемы - "вскрытие\аутопсия", букв. "после смерти"

Anthropic выявила три независимые причины.

Первая — 4 марта уровень рассуждений по умолчанию был снижен с high до medium для сокращения задержек, что сделало модель менее «умной»; изменение откатили 7 апреля.

Вторая — 26 марта появился баг в оптимизации кэширования: вместо однократной очистки истории рассуждений после часа простоя сессии это происходило на каждом шагу, из-за чего Claude «забывал» контекст, повторялся и делал странные вызовы инструментов; исправлено 10 апреля .

Третья — 16 апреля в системный промпт добавили ограничение на длину ответов (≤25 слов между вызовами инструментов, ≤100 слов итого), что снизило качество написания кода на 3%; откатили 20 апреля.

Это прошло мимо кодревью, юнит-тестов, e2e-тестов и догфудинга, потому что проявлялось только в «угасших» сессиях, которые, очевидно, никто внутри не тестировал.

Догфудинг (от англ. "eating your own dog food") — практика, когда сотрудники компании сами используют собственный продукт в реальных условиях, как обычные пользователи.
Ну вы поняли, пользователи - собаки, лол.

Итог предсказуем: три независимых изменения одновременно ухудшали продукт, пока пользователи месяц постили жалобы, а внутренние метрики «не воспроизводили проблему» .

В конце постмортема — традиционное «мы всё исправили, имплементируем новые процессы и очень-очень ценим ваш фидбэк», плюс символический сброс лимитов для подписчиков.

Оригинал оправданий на английском можно почитать тут
  • 👍 5
  • 😁 5
Post #2116 321
Я не успел привыкнуть к Opus 4.6, как вышел Opus 4.7

Как обычно - быстрее, выше, сильнее, контекстнее, кибербезопаснее, умнее.

Для разработчиков внедрили новый уровень контроля рассуждений xhigh (между high и max) и бета-версию «бюджетов задач» в API для лучшего управления расходом токенов.

В Claude Code появились команда /ultrareview для глубокого код-ревью и расширенный автоматический режим, позволяющий агенту работать с меньшим количеством прерываний.

Говорят, что Opus 4.7 воспринимает промпты гораздо буквальнее своих предшественников, старые инструкции и системные промпты рекомендуется переписать (я это не понял, если честно).

Цены остались на уровне версии 4.6 ($5 за миллион токенов на вход и $25 на выход)

Хочу Sonnet 4.7 в 5 раз дешевле, чем Opus 4.7

https://www.anthropic.com/news/claude-opus-4-7
  • 👍 7
  • 😁 4
  • ❤ 1
Post #2113 326
Пару недель назад Google выпустил новые модели семейства Gemma под номером 4.

Gemma - это семейство открытых небольших больших (что?) языковых моделей от Google. C неймингом там проблемы, и местами Gemma называется в некоторых продуктах Google Gemini.

Веса доступны и открыты, а значит всё доступно для локального запуска на своём железе. Модели доступны под лицензией Apache 2.0!

Проще всего понимать это так: модель можно свободно брать, запускать, менять и встраивать в свои продукты, включая коммерческие, если соблюдать несколько базовых условий лицензии.

Мне больше всего интересны в этом посте плотная модель на 31B и 26B A4B MoE.

Первая просто невероятно умна для своего размера.
На arena.ai в text-to-text рейтинге располагается выше Gemini-2.5 Pro и Opus 4.1, а также прям под claude-sonnet-4-5. Ну лучший бенчмарк, но тем не менее.

С более серьёзными бенчмарками пришлось покопаться, но путём объединения бенчмарков из карточек моделей Gemma 4, Qwen-3.5, GPT-4.1 вышло что-то наглядное (второе фото).

Gemma 4 31B на первом месте по MMLU среди перечисленных мной моделей, обходя даже GPT o1 и GPT-5 mini!

MMLU (Massive Multitask Language Understanding) — это один из самых популярных и авторитетных эталонных тестов (бенчмарков) для оценки возможностей больших языковых моделей.

Его основная задача — измерить, насколько модель «умная» и «эрудированная», проверяя её знания в самых разных дисциплинах, от начальной школы до профессионального уровня.


Из бенчмарков видно, что у модели, которая запускается на обычном ПК пользовательского пошиба, уровень знаний сравним с топовыми большими LLM прошлых поколений и текущими бесплатными моделями и превосходит OpenAI GPT-OSS-120B, предыдущую серьёзную опенсорсную модель от основных игроков рынка (не считая Китая).

Это не говоря уже о классической прекрасной поддержке русского языка у Gemma\Gemini моделей.

На моём ПК с 13600K/32Gb DDR5/4070 Ti S 16GB просто при запуске "в лоб" в LM Studio:

- 31B в квантизации Q6_K выдаёт ~3 ток\сек при хорошем качестве ответов (хотя замороченный вопрос по Python она сама не расколола на 100%) - пришлось подсказать.
- 26A4B в квантизации Q6_K выдаёт ~14.5 ток\сек. Ответы похуже, но тоже очень приличные.

Из нюансов - thinking режим в LM Studio включается для этой модели с проблемами (скорее не включается), хотя в Ai Studio у Гугла всё работает.

Google опять всех переиграл (это продлится пару недель).

Ну и имаджинируйте состояние российского AI - локальная модель значительно мощнее и адекватнее всех гигачатов и Алис.

Google AI Studio
LM Studio
Hugging Face
  • 👍 12
  • 🤯 1
Post #2109 351
Провёл предыдущую неделю в отпуске вместе с семьёй под Мюнхеном и, прежде чем вернуться к разному айтишному и ИИ-задротству, расскажу про небольшой практический совет, который может сэкономить пару десятков евро в автопутешествии в Австрию.

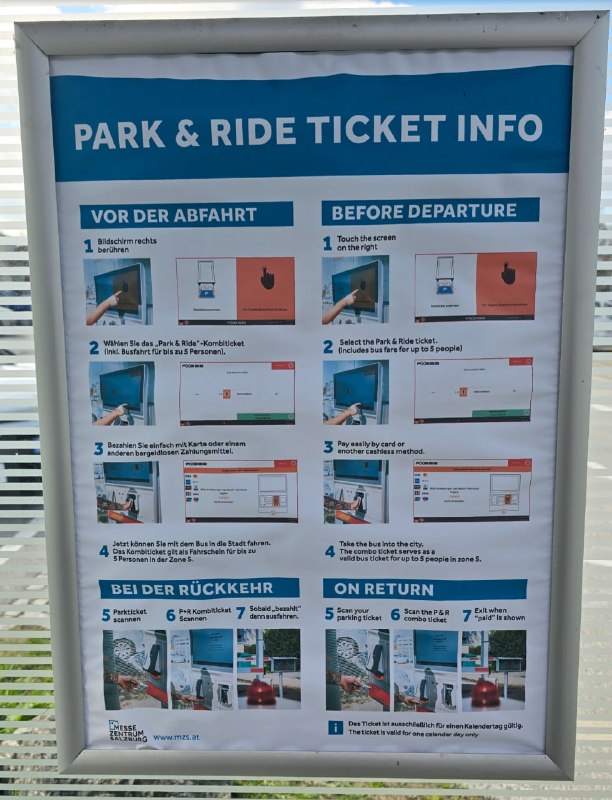
Если вы едете в австрийские города на машине большой компанией и хотите безболезненно скинуть машину и кататься по городу на общественном транспорте, то можно припарковать автомобиль на парковке Park&Ride.

Работает очень просто: где-то в удалении от центра есть большие парковки с обычной тарификацией, но с возможностью купить в паркомате Park&Ride ticket, который одновременно скидывает стоимость парковки до нуля и служит проездным на общественном транспорте по городу на компанию до 5 человек.

На примере нашей поездки в Зальцбург математика вышла такая:
— парковка стоила 21 евро;
— Park&Ride на 5 человек стоила 15 евро.

По итогу Park&Ride дала 100% скидки на парковку, и это вышло даже выгоднее просто парковки по фулпрайсу.
  • ❤ 10
  • 👍 6
Post #2108 374
Последнее напоминание о том, что в Мемминген когда-то летала Победа
  • 😢 15
Post #2107 400
Google представила TurboQuant

Все об этом пишут и я напишу.

Это алгоритм online vector quantization от Google Research в KV-cache больших языковых моделей и нет, он не сократит потребление памяти языковыми моделями В 6 ИЛИ В 8 РАЗ, УРА КРИЗИС ПАМЯТИ ЗАКОНЧИЛСЯ.

В реальности, всё не совсем так, конечно.


TurboQuant — это алгоритм online vector quantization, то есть квантования векторов “на лету”, который, по словам авторов, близок к теоретически оптимальному уровню искажений для разных битностей и размерностей.

KV-cache — это память, куда LLM складывает key и value тензоры уже обработанных токенов, чтобы при генерации следующего токена не пересчитывать всю историю заново; это сильно ускоряет autoregressive inference, но память такого кэша растёт вместе с длиной контекста и часто становится главным узким местом.

Когда модель обрабатывает токен, в каждом слое self-attention она создаёт key/value-представления и может сохранить их в кэше, чтобы на следующем шаге использовать старые K/V вместе с новым query вместо полного пересчёта прошлых токенов.

За счёт этого генерация становится быстрее, но кэш растёт со временем, а у long-context моделей именно KV-cache часто начинает упираться в RAM (объём и пропускная способность памяти - ПСП).

Проще говоря, weights отвечают за “знания” модели, а KV-cache — за “оперативную память разговора”. Статья на huggingface

Если перенести идею TurboQuant на условную gpt-oss-120B, главный эффект будет не в том, что модель станет “умнее”, а в том, что длинный контекст станет заметно дешевле по RAM, а декодирование — легче для ПСП.

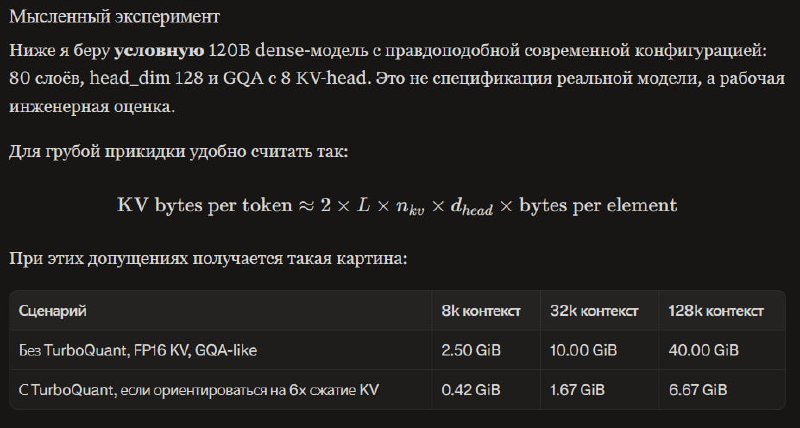
Я попросил GPT-5.4 потеоретизировать и посчитать выигрыш по потреблению памяти для разного размера контекста:

На 32k контексте одна сессия экономит примерно 8.33 GiB, а на 128k — примерно 33.33 GiB.

Простое следствие — длинный контекст становится реально обслуживаемым. Если без доработки 128k-контекст условной 120B-модели съедает около 40 GiB только на KV-cache, то с TurboQuant-подобным 6x сжатием потребление падает примерно до 6.67 GiB.

Это означает, что тот же GPU-бюджет можно потратить либо на более длинные диалоги, либо на большее число одновременных пользователей, либо на снижение риска Out of Memory при росте batch size.

Вишенка на торте - статья вышла почти год назад, а вот блогпост позавчера. Статья буквально вышла ещё до начала кризиса памяти!

И вот акции Micron упали, акции ещё каких-то производителей памяти тоже. Инвесторы читают новости с запозданием в год и делают вывод о том, что кризис памяти закончился. Многоуважаемые профильные аналитики тоже читают только статьи блогеров и всё?

В общем, ждём миллион токенов контекста как мейнстрим во всех SOTA-моделях и десяток миллионов у гугла (когда-нибудь). Дешёвую память не ждём

Blogpost от Google Research
  • 👍 10
  • 🤓 1
Post #2106 348
Про интернет в РФ и белые списки

Простите за токсичность, но я опять про то же самое:

Почти всё что пишут люди из РФ на Хабре и прочих площадках - это похоже просто на острый приступ самоуспокоения. "Да это дорого для них, да они не смогут, да они зассут, да дырочка останется, мы найдём обход" и так далее.

Это ни на чём не основанный копинг, больше ничего за этим нет.

На текущий момент белые списки вводятся почти бесплатно, это не глубокая фильтрация трафика и не "замедление", на которые нужны мощности и которые можно обойти так или иначе. Просто белые списки пока что сделаны относительно плохо - широкими диапазонами.

Мой прогноз выглядит так:

Со временем белые списки сделают шире, включат туда все важные банки, госуслуги и ежедневные сервисы, раскатают процедуру включения ресурсов (всякого рода бизнесов) в БС при выполнении ряда условий и регулярного налога "на суверенный интернет и поддержку белых списков", в зависимости от оборота, размера бизнеса или ещё чего-то. Ну и появится новый кнут для бизнеса - исключение из белого списка.

Да и при наличии политической воли можно вообще просто всё вырубить сразу и потом разбираться с последствиями, на самом деле

Немного про айтишные боли:

Библиотеки во всяких банках просто раскатают в зеркалах репозиториев. Тут что, никто не работал в Сбере во времена Alpha/Sigma и прочего со своим maven central? Опыт в России есть, проблемой это не будет.

Да, современные айтишники не могут жить без топовых нейронок, но китайский опенсорс пусть и отстаёт, но это отставание измеряется полугодом-годом, а не десятилетиями. Развернуть Qwen в суверенном ЦОД не будет проблемой для крупных компаний. А может быть мы увидим корпоративные рилсы вк клипы о том, что в Яндексе, вы представляете, дают каждый месяц 20 часов доступа к OpenAI и 5 гигов настоящего интернета

Ну и появится платный полулегальный выход в нормальный интернет за какую-то большую цену типа 1к зелёных

Я буду очень рад, если я ошибаюсь и хотелось бы через пару лет публично написать "был неправ, с интернетом в РФ всё супер"

Ваши мысли?
  • 😢 21
  • 💯 7
  • 👍 1
Post #2105 381
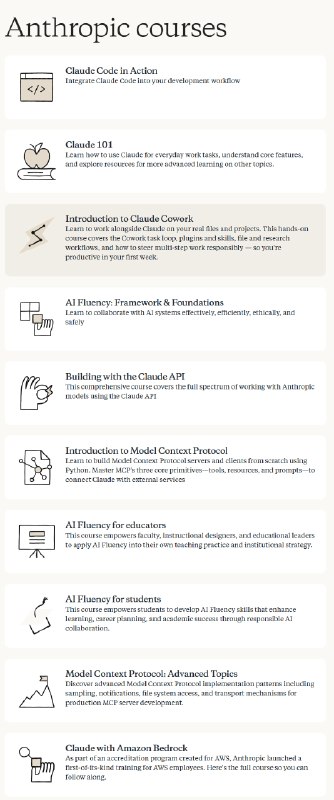
Если вам очень нравится проходить всякие курсы и получать сертификаты, то на skilljar есть целая пачка курсов по claude code и прочей агентской разработке от самих anthropic.

Курсы полностью бесплатные

Раньше инфоцыгане бы взяли с вас пару тысяч баксов за такой контент, хех

Возможно дают сертификаты, я тут не уверен, так как EPAM запартнёрился с Anthropic и нам доступен платный advanced курс, который точно даёт сертификат в конце.

https://anthropic.skilljar.com/
  • 👍 9
  • ❤ 2
Post #2104 436
  • 😁 27
  • 🤓 2
  • 👍 1
Post #2103 461
На фоне (после слов "на фоне" сразу есть ощущение прогрева, не правда ли?) сообщений о том, что в Москве и в РФ вообще Телеграм работает всё хуже, напоминаю, что есть мой замечательный webfeed.live, где вы можете читать свои любимые [Роскомнадзор], [Данные Удалены], [Нежелательная организация] и, конечно, канал Артемия Лебедева или что там популярно у любителей СВО

Там всё работает (если у вас не белый список, конечно)

А ещё я добавил светлую тему и исправил пару мелких багов

О Webfeed
Full-time Nerd
  • 👍 9
  • ❤ 2
Post #2102 393
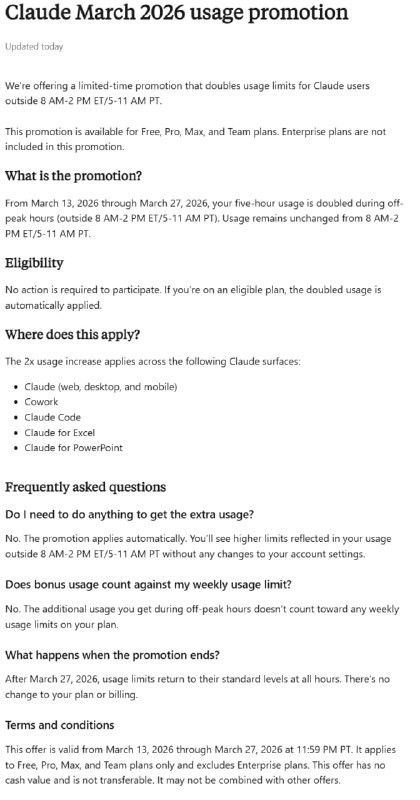
Claude увеличивает в два раза лимиты в токенах для подписчиков.

С 13 до 27 марта пятичасовой лимит увеличен в два раза в не-пиковые часы — 5-11 утра PT. Это 14:00-20:00 по центральноевропейскому времени и 16:00–22:00 по МСК.

Работает в Claude Code, Claude в целом и так далее.

Астрологи объявили (2) недели нейрослопа

https://support.claude.com/en/articles/14063676-claude-march-2026-usage-promotion
  • 👍 8
  • 🤓 2
Post #2101 334
Социальный LinkedIn рейтинг

Я, наверное, живу в своём мирке и не приспособлен к хэдхантинговому карго-культу на "Западе", но я только на днях узнал, что в LinkedIn есть т.н. SSI - Social Selling Index

Это буквально аналог социального рейтинга из сериала «Черное зеркало», где высокие баллы открывают двери к лучшим вакансиям

Суть метрики

LinkedIn математически оценивает, насколько эффективно вы продаете себя как специалиста на платформе. Если ваш индекс превышает сколько-то баллов, алгоритмы автоматически продвигают профиль в топ поисковой выдачи для эйчаров. Поговаривают, что для того, чтобы быть "успешным" нужно целиться в 60 баллов, 80 есть только у топовых инфлюенсеров, а 100 - недостижим.

Что внутри индекса?
Алгоритм выдаёт максимум по 25 баллов за каждое из четырех направлений вашей активности:
​
Создание личного бренда (максимально упакованный профиль с ключевыми словами и навыками).

Поиск нужных людей (я не понимаю, как это работает в реальности).

Взаимодействие с контентом (осмысленные комментарии и публикации, доказывающие вашу активность).

Построение связей (нетворкинг и высокий процент принятых от вас заявок).

По приведённому выше скриншоту видно, что с рейтингом у меня...не очень. Если бы это был гос.рейтинг, то наверное уже в метро бы не пускали

Зачем качать индекс?

Исключительно ради расширения личной воронки продаж + прокачанный рейтинг позволяет тратить меньше сил на поиск работы и заставляет рекрутеров конкурировать за вас. Ну а ещё прикольно когда циферки растут, геймификация. Я за эти циферки готов, конечно, тратить часы личного времени и писать в личку друзьям бессмыслицу (да, это тоже влияет)

Смотреть свой рейтинг тут:
https://www.linkedin.com/sales/ssi

UPD. Обновляется с задержкой в пару дней


Webfeed Telegram без VPN
Full-time nerd
  • 🤯 11
  • 👍 1
  • 🤔 1
Post #2098 451
Webfeed телеграма

Накодил ленту телеги в браузере, с любого устройства, откуда угодно, любые посты открытых каналов.

Встрейчате webfeed.live

Проект вышел не таким уж маленьким - я сильно парился о кэшировании и эффективности, хотя это, конечно, сплошной вайбкод - руками я бы это не взялся делать, тем более в такие сроки. God Bless Anthropic

Что это и зачем это нужно?

• Личная онлайн-лента каналов в ТГ - вы добавляете каналы - вы видите их посты
• Добавление канала по его id, например @durov или @ftbore
• Никакой авторизации
• Список ваших каналов, которые вы добавили к себе в ленту хранится только у вас в браузере и больше нигде
• Есть авто-рефреш раз в 60с, но его нужно включить.
• Лента не бесконечная - есть переключение по страницам. Ваш браузер не упадёт, даже если вы сидите с калькулятора
• Ступенчатая система кэширования постов - в браузере и у меня на бэке. Зачем? Ну я не хочу, чтобы t.me меня забанил
• Видны реакции под постами
• Можно скопировать ссылку и поделиться постом где-нибудь (по bluetooth, я не знаю)
• Ссылки в постах на другие посты в ТГ автоматом подменяются на ссылки в webfeed.live
• Как удобно, что структура ссылок выходит такая же, как у t.me. Можно даже заменить t.me в ссылке на пост в телеге на webfeed.live и...пост откроется!
• Как удобно (2), что при проблемах загрузки фото в настройках есть кнопочка, фиксящая это неудобство!
• Как удобно (3), что можно читать отдельный канал, просто написав webfeed.live/@channel_id
• Сервер в ЕС, а телеграм у нас тут не блокируют...

Из минусов:
• Мой канал не удаляется, лол. Вообще (а минус ли это?)
• Есть кучка маленьких шероховатостей и на текущий момент не работают папки каналов (хотя их и можно создавать) - первым делом сделаю такой апдейт
• Я не получаю за это никаких денег и рекламы там тоже нет. Там была бы кнопочка buy me a coffee и мб реклама (просто гугловый баннер) раз в 10\20 постов, но это бы лишило меня налогообложения по Закону Бэкхема, чего мне не нужно.
• Можно читать только открытые каналы (авторизации же нет, помните?)
• Некоторые стандартные реакции довольно...странно выглядят. Зато кастомные тоже работают.
• По умолчанию авто-обновление ленты не включено - меня не очень устраивает, как оно работает
• Пока только тёмная тема
• Нужно вставлять id канала и нет поиска. Но уж загуглите, это просто

Читайте свои любимые каналы, подписывайтесь на мой канал, ставьте лайки (пока можете)
  • 👍 18
  • ❤ 5
  • 😁 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →