
Google представила TurboQuant
Все об этом пишут и я напишу.
Это алгоритм online vector quantization от Google Research в KV-cache больших языковых моделей и нет, он не сократит потребление памяти языковыми моделями В 6 ИЛИ В 8 РАЗ, УРА КРИЗИС ПАМЯТИ ЗАКОНЧИЛСЯ.
В реальности, всё не совсем так, конечно.
TurboQuant — это алгоритм online vector quantization, то есть квантования векторов “на лету”, который, по словам авторов, близок к теоретически оптимальному уровню искажений для разных битностей и размерностей.
KV-cache — это память, куда LLM складывает key и value тензоры уже обработанных токенов, чтобы при генерации следующего токена не пересчитывать всю историю заново; это сильно ускоряет autoregressive inference, но память такого кэша растёт вместе с длиной контекста и часто становится главным узким местом.
Когда модель обрабатывает токен, в каждом слое self-attention она создаёт key/value-представления и может сохранить их в кэше, чтобы на следующем шаге использовать старые K/V вместе с новым query вместо полного пересчёта прошлых токенов.
За счёт этого генерация становится быстрее, но кэш растёт со временем, а у long-context моделей именно KV-cache часто начинает упираться в RAM (объём и пропускная способность памяти - ПСП).
Проще говоря, weights отвечают за “знания” модели, а KV-cache — за “оперативную память разговора”. Статья на huggingface
Если перенести идею TurboQuant на условную gpt-oss-120B, главный эффект будет не в том, что модель станет “умнее”, а в том, что длинный контекст станет заметно дешевле по RAM, а декодирование — легче для ПСП.
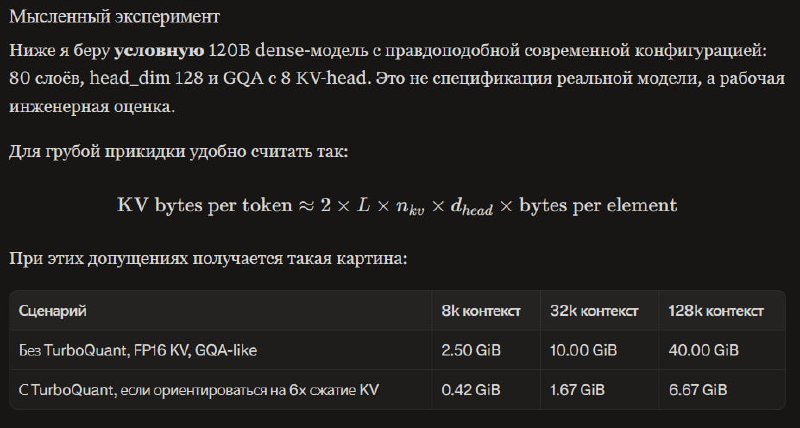
Я попросил GPT-5.4 потеоретизировать и посчитать выигрыш по потреблению памяти для разного размера контекста:
На 32k контексте одна сессия экономит примерно 8.33 GiB, а на 128k — примерно 33.33 GiB.
Простое следствие — длинный контекст становится реально обслуживаемым. Если без доработки 128k-контекст условной 120B-модели съедает около 40 GiB только на KV-cache, то с TurboQuant-подобным 6x сжатием потребление падает примерно до 6.67 GiB.
Это означает, что тот же GPU-бюджет можно потратить либо на более длинные диалоги, либо на большее число одновременных пользователей, либо на снижение риска Out of Memory при росте batch size.
Вишенка на торте - статья вышла почти год назад, а вот блогпост позавчера. Статья буквально вышла ещё до начала кризиса памяти!
И вот акции Micron упали, акции ещё каких-то производителей памяти тоже. Инвесторы читают новости с запозданием в год и делают вывод о том, что кризис памяти закончился. Многоуважаемые профильные аналитики тоже читают только статьи блогеров и всё?
В общем, ждём миллион токенов контекста как мейнстрим во всех SOTA-моделях и десяток миллионов у гугла (когда-нибудь). Дешёвую память не ждём
Blogpost от Google Research
Post #2107
400
- 👍 10
- 🤓 1