TGViewer
Channel Public Channel
Full-time nerd

Full-time nerd

@ftbore

Эмиграция, IT, финансы и путешествия
Subscribers
608
Photos
1.7K
Videos
46
Links
474

Showing posts older than #1782 · Back to latest

Older Posts 7 shown
Post #1778 410
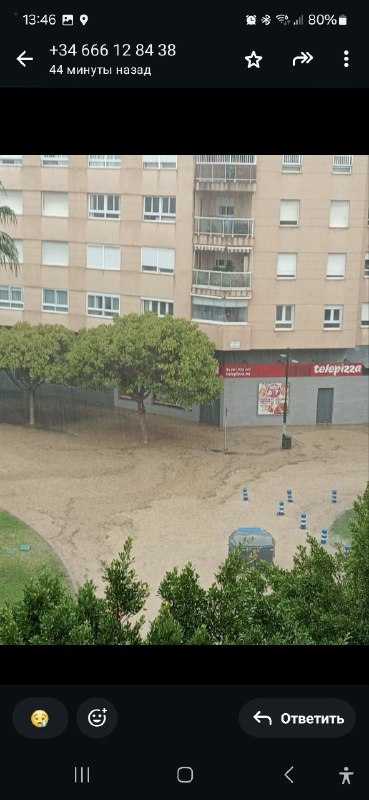
Мы очень вовремя уехали в отпуск, так как Малага выглядит сейчас вот так.

Очередная DANA пришла, теперь и к нам.

Объявили красный уровень опасности
  • 🤯 12
  • 😢 5
Post #1768 405
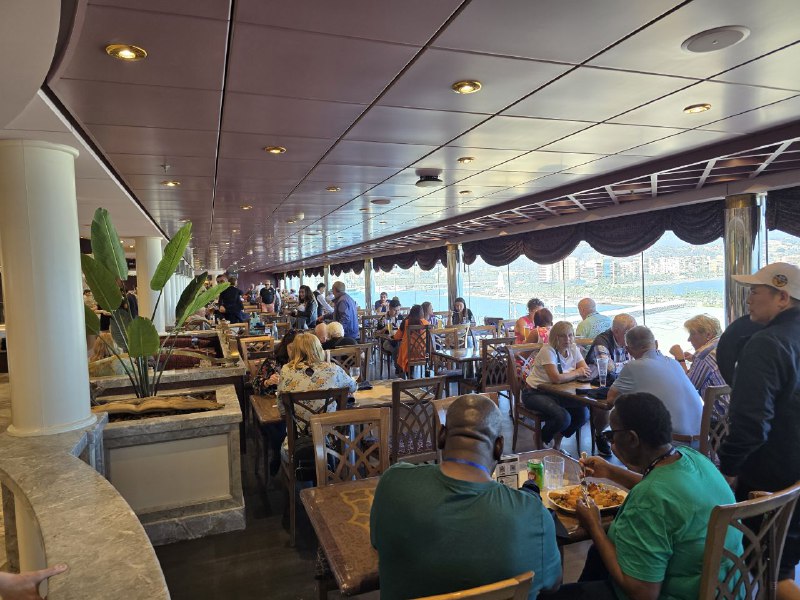
Пару дней назад у меня начался отпуск и мы взошли на борт корабля MSC Poesia.

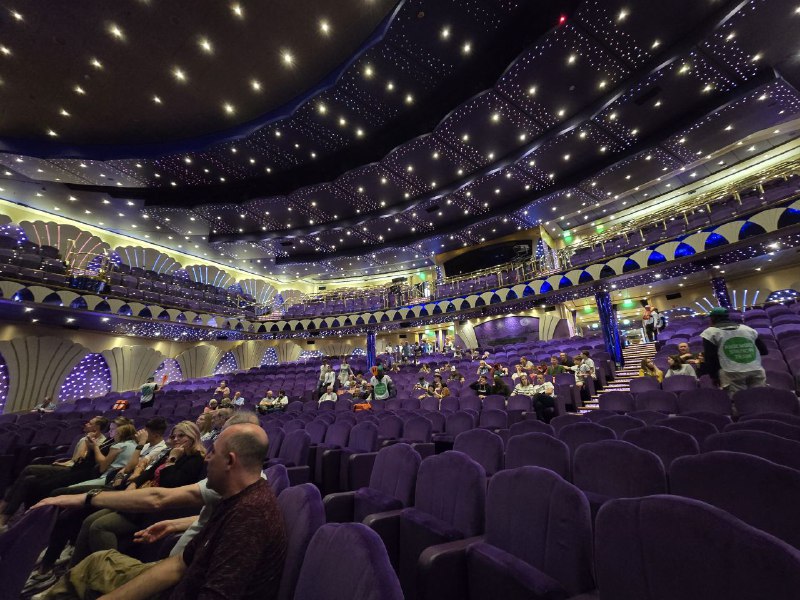
Круиз в этот раз совсем короткий и был встроен мной в путешествие как комбинация транспорта и нескольких ленивых All Inclusive дней - еда от пуза, сон, телевизор, шоу в театре, вот это всё.

Вышло очень удобно - корабль совершал очень длинное путешествие из другого полушария и практически в конце пути останавливался в Малаге. Там мы и сели на корабль, буквально дойдя пешком от метро.

Всего три ночи на корабле, последняя точка нашего маршрута - Генуя, откуда мы поедем в Милан, смотреть на дачу Соловьёва знаменитый собор.

Прямо сейчас мы остановились в единственной промежуточной точке нашего маршрута - Марселе, но:
1. Мне лень выходить
2. Я тут уже был
3. Короткая остановка
4. Ужасная погода с ливнем.

А вот корабль оказался намного лучше, чем я ожидал. А ждал я, что корабль 2010г спуска на воду будет уже сильно уставшим и нам не очень понравится. Однако все совсем не так.

Из интересного:
1. Корабль меньше тех, на которых я ездил раньше
2. Корабль сильнее качает
3. В несезон мало людей и корабль полупустой - это сильно влияет на удовольствие.
4. Всё ещё вкусная еда
5. На кораблях меньшего размера внезапно меньше развлечений
6. Корабль старше и потому иногда вибрация от двигателя очень сильно ощущается.

И все это великолепие вышло в 380€ на три дня за двоих с учётом всех сборов.
  • ❤ 12
  • 👍 4
Post #1767 838
Full-time nerd Пару недель назад ChatGPT advanced voice mode стал доступен в Европе. Да, это тот самый хайповый режим, в котором общение происходит с минимальной задержкой, вы с ассистентом друг друга перебиваете, можете поспорить и так далее. Забавно, что его анонс…
Ещё один сервис, кроме нормально работающего advanced voice mode, который лишний раз напомнил мне, что я живу в будущем - Google Notebook LM и его генерация нейроподкастов.

Работает просто - закидываешь любые sources количеством до 40 штук - текст, видео, аудио, просто ссылку на ютуб или сторонний сайт, нажимаешь кнопку Generate и получаешь на выходе подкаст с двумя ведущими - мужчиной и женщиной, которые погружают тебя в тему в формате подкаста!

Да, внутри всё происходит довольно очевидно - все твои sources транскрибируются, загоняются в контекстное окно Gemini 1.5, она (большая языковая модель) выдаёт текст с репликами по ролям, которые потом превращаются в звук.

Но какой результат на выходе! Это ощущается как полноценный подкаст специально для тебя. Ведущие перебивают друг-друга, поддакивают, задают вопросы, играют интонациями, угукают, шутят, смеются и вообще всячески прикидываются настоящими кожаными людьми.

Да, подкаст будет только на английском и с одними и теми же голосами каждый раз, но минус ли это? За пару генераций к голосам уже привыкаешь и воспринимаешь их как старые-знакомые.

Это прекрасный способ запихать в себя содержание какой-нибудь статьи "на ходу", когда нет возможности смотреть в экран.

При этом я вообще скормил ему полуторачасовое видео Школы Анализа Данных Яндекса на русском - получил вполне сносный подкастик, несущий в себе ключевые вещи из лекции.

Да, есть и минусы — Notebook LM в принципе имеет спорный интерфейс, альфа-версия генерации подкаста вообще приколочена туда на соплях - к примеру я просто не могу найти сгенерированный подкаст, если перезагрузил страницу и не скачал его заранее - его просто нет. Конечно, если я просто не там ищу - подскажите что я делаю не так.

Новые невероятные изменения стали происходить так быстро, что едва успеваешь за ними следить.

https://notebooklm.google.com/
  • 🤯 8
  • 👍 5
Post #1765 1.97K
Пару недель назад ChatGPT advanced voice mode стал доступен в Европе.

Да, это тот самый хайповый режим, в котором общение происходит с минимальной задержкой, вы с ассистентом друг друга перебиваете, можете поспорить и так далее.

Забавно, что его анонс в своё время был громким, а вот релиз - нет и потому люди наперебой записывали видео общения со старым режимом сразу после анонса и восторгались его "продвинутостью".

Но вот вчера наконец дошли руки пообщаться с ним полноценно. Вышел на прогулку, вставил наушники в уши и просто начал с ним разговаривать и это было...Просто потрясающе.

В течение всего отпущенного мне часа общения (да, доступен всего 1 час в день), меня не отпускало ощущение "будущего", в которое я наконец попал. Я просто попросил ассистента (на русском) рассказать мне тему, в которой я плавал и слушал его рассказ.

В процессе я его перебивал, просил вернуться на 15 секунд назад, углубиться в какой-то конкретный аспект, привести примеры на близкие мне темы, рассказать какие-то аспекты более глубоко и тому подобное. Даже просил выговаривать букву "р" почётче и говорить голосом пониже - всё работало!

Ощущал себя участником личного подкаста, который создан только для меня, но при этом я ещё и принимаю в нём участие.

Да, что там, я буквально ощущал себя Тони Старком, а ассистента - Джарвисом. Нужно бы попросить его себя так называть, кстати.

Ну а ещё этот режим идеально работает как переводчик - испаноязычная врач-ветеринар была шокирована качеством перевода
  • 🤯 22
  • 👍 9
Post #1764 527
Запускаем нейросети бесплатно самым простым способом.

Давайте поговорим о чём-то более применимом для большинства людей, а именно о локальном запуске (инференсе) больших языковых моделей (LLM). Для этого нужно всего лишь скачать LM Studio.

Если у вас есть компьютер с более-менее современной видеокартой, либо современный мак на M-процессоре, то вы можете сделать это с относительным комфортом, а если у вас старенькая печатная машинка, то тоже можете, но комфорта будем меньше.

Сможете развернуть у себя почти любую понравившуюся небольшую LLM и общаться с ней напрямую, бесплатно, без ограничений и даже без интернета, да ещё и в красивом и удобном интерфейсе с поддержкой markdown и хранения чатов.

Те, кто этим плотно интересуется, обычно про LM Studio давно знают, но нужно же с чего-то начинать тем, кто только вкатывается.

• Скачиваете LM Studio, запускаете на вашем ПК.
• Выбираете модель, которая влезет в память, на HuggingFace (в LM Studio встроен браузер по HuggingFace), желательно не беря очень агрессивную квантизацию весов (степень сжатия коэффициентов), от этого модели ощутимо тупеют.
• Общение происходит в стандартном чат-интерфейсе.

В последних версиях LM Studio добавили возможность работать как сервер, так что можно в рамках одной сети давать доступ до мощностей вашей тачки, на которой всё крутится, однако я этим не пользовался.

А вот такие результаты получились на моём конфиге с парочкой небольших моделей (i5 13600K, 32GB, 4070 ti super 16Gb), пояснения ниже:

• Gemma-2-27B Q6_K (c оффлоадом максимально возможного количества слоёв на GPU): 3.97 tok/sec, 824 tokens, 29.16s to first token.
• Gemma-2-27B Q6_K (без оффлоада на GPU): 2.01 tok/sec, 851 tokens, 18.14s to first token.
• Gemma-2-27B IQ4_XS (c полным оффлоадом на GPU): 4.94 tok/sec, 955 tokens, 72.68s to first token.
• Gemma-2-27B IQ4_XS (без оффлоада на GPU): 2.68 tok/sec, 1020 tokens, 11.48s to first token.
• Llama 3.1 8B Q8_0 (c полным оффлоадом на GPU): 54.86 tok/sec, 563 tokens, 0.60s to first token.
• Llama 3.1 8B Q8_0 (без оффлоада на GPU): 5.52 tok/sec, 646 tokens, 0.21s to first token.


Пояснения:
• Оффлоад на GPU, в контексте запуска LLM, означает перенос части вычислений с центрального процессора (CPU) на графический процессор (GPU).
Их архитектура хорошо подходит для параллельных вычислений, которые необходимы при работе с нейросетями. Перенос части операций на GPU позволяет значительно ускорить процесс инференса.
• Q6_K, IQ4_XS, Q8_0: Эти обозначения указывают на тип квантизации, использованный для уменьшения размера модели. Квантизация - это процесс уменьшения точности весов модели, что позволяет уменьшить её размер и требования к памяти, но может снизить качество генерации. Разные обозначения (Q6_K, IQ4_XS, Q8_0) соответствуют разным методам и уровням квантизации. Чем меньше число в обозначении (например, 4 в IQ4_XS меньше, чем 8 в Q8_0), тем сильнее квантизация и меньше размер модели, но потенциально хуже качество.

Как видите, GPU даёт неслабый прирост, особенно заметно ускорение на Llama 3.1 с 8 миллиардами параметров, где скорость генерации увеличивается с 5.52 tok/sec до 54.86 tok/sec.

Но это всё получено на довольно мощном конфиге стоимостью ~2к евро (уже меньше, наверное). А что же можно получить на типичной печатной машинке?
Ну, на моём стареньком ноутбуке на AMD 3500U + 20Gb Ram вполне получалось запускать инференс маленькой 8B Llama и при некотором терпении получать ответ.

Это удобно в ситуации, когда у тебя нет интернета - перелёт, круиз, прочие командировки.
К сожалению, после обновления LM Studio до версии 0.3.5, у меня на ноутбуке просто перестали загружаться в память модели, нужно разбираться.

Надеюсь, что скоро в LM Studio добавят поддержку мультимодальных сетей и можно будет удобно запускать мультимодальную опенсорсную экстремистскую (META же) Llama 3.2, и кидать в LM Studio картинки
  • ❤ 14
Post #1763 468
Я же, кстати, не рассказывал, что у меня сейчас за проект.
Занимаюсь EPAM Dial – это такая платформа, типа единого окна в мир нейросетей. Представьте себе чат-интерфейс систему корпоративного уровня, в котором – доступ к любым LLM, хоть локальным, хоть облачным - OpenAI/Google/Anthropic/OpenSource

Тут можно немного дать волю своему AI и прочему LLM - энтузиазму, поиграться с разными моделями, поэкспериментировать, ну и просто доступ до разных моделей с возможностью поиграться с температурой и системными промптами.

Да, роль SDET мне тут, конечно жмёт, но проект интересный, коллектив приятный, есть с кем посоветоваться и у кого поучиться. Проект, кстати, опенсорс. Всё гордо лежит на GitHub в пачке репозиториев.

Поднимать такое дома - дичайший оверхэд, я не уверен, что сам смогу без проблем поднять все компоненты и соединить их для работы - просто не было такой необходимости. Но если среди вас есть энтузиасты, можете у себя развернуть и пощупать. А можете вообще форкануть или даже поконтрибьютить.

Epam, соответственно, на самом проекте не зарабатывает, мы продаём развёртывание у заказчика, поддержку и разработку разных эксклюзивных фич.

Что там интересного в самой платформе? Ну, кроме того, что она cloud-agnostic и может быть развёрнута в любом Kubernetes-окружении:

• Кастомизируемый UI: Внешний вид чата полностью настраивается. Можно даже диаграммы-графики отображать.
• Данные не утекают, доступ к промптам только у авторизованных пользователей.
• Интеграция с вашими данными: Можно подключить свои корпоративные данные и workflows к LLM.
• API-First: Все фичи доступны через API
• Шаринг конверсейшенов внутри организации
• Публикация на всех сотрудников от организации.
• Хранение промптов с шарингом и публикацией.
• Хранение файлов.
• Chat Overlay: Добавляйте AI-чат в своё веб-приложение просто вставив кусочек HTML.
• Встроенные приложения поверх нейросетей: Например, цензор или любой другой функционал, который может быть жизнеспособен в интерфейса чата

Если вы супер-секретная организация, то разворачиваете Dial, разворачиваете у себя локально на своём железе какую-нибудь LLAMA 3.1 405B, соединяете их и ваши данные остаются внутри, а организация получает приятный и готовый способ привычно общаться с нейросеточками + спокойный комплаенс

https://epam-rail.com/
  • 👍 13
Post #1762 429
У ChatGpt с недавних пор есть память - и он запоминает какие-то факты из общения с вами.

А вот интересный промпт, использующий эту фичу - попросите написать картинку, основанную на знаниях о вас:

Based on what you know of me, draw a picture of what you think my life currently looks like


Мне нравится, как ChatGPT нарисовал испанские домики в окне - метко подметил, что Испанию я вижу только через оконное стекло в кабинете!

Ну и не так уж много я общался про Raspberry Pi, чтобы повесть логотип аж в виде картины на стене...
  • 😁 12
  • 👍 5
  • 🤓 4
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →