
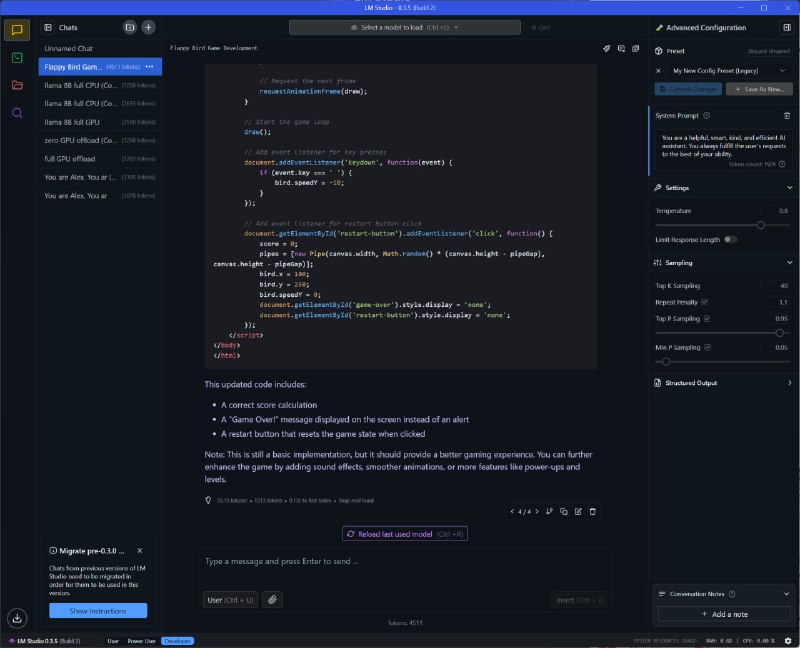
Давайте поговорим о чём-то более применимом для большинства людей, а именно о локальном запуске (инференсе) больших языковых моделей (LLM). Для этого нужно всего лишь скачать LM Studio.
Если у вас есть компьютер с более-менее современной видеокартой, либо современный мак на M-процессоре, то вы можете сделать это с относительным комфортом, а если у вас старенькая печатная машинка, то тоже можете, но комфорта будем меньше.
Сможете развернуть у себя почти любую понравившуюся небольшую LLM и общаться с ней напрямую, бесплатно, без ограничений и даже без интернета, да ещё и в красивом и удобном интерфейсе с поддержкой markdown и хранения чатов.
Те, кто этим плотно интересуется, обычно про LM Studio давно знают, но нужно же с чего-то начинать тем, кто только вкатывается.
• Скачиваете LM Studio, запускаете на вашем ПК.
• Выбираете модель, которая влезет в память, на HuggingFace (в LM Studio встроен браузер по HuggingFace), желательно не беря очень агрессивную квантизацию весов (степень сжатия коэффициентов), от этого модели ощутимо тупеют.
• Общение происходит в стандартном чат-интерфейсе.
В последних версиях LM Studio добавили возможность работать как сервер, так что можно в рамках одной сети давать доступ до мощностей вашей тачки, на которой всё крутится, однако я этим не пользовался.
А вот такие результаты получились на моём конфиге с парочкой небольших моделей (i5 13600K, 32GB, 4070 ti super 16Gb), пояснения ниже:
• Gemma-2-27B Q6_K (c оффлоадом максимально возможного количества слоёв на GPU): 3.97 tok/sec, 824 tokens, 29.16s to first token.
• Gemma-2-27B Q6_K (без оффлоада на GPU): 2.01 tok/sec, 851 tokens, 18.14s to first token.
• Gemma-2-27B IQ4_XS (c полным оффлоадом на GPU): 4.94 tok/sec, 955 tokens, 72.68s to first token.
• Gemma-2-27B IQ4_XS (без оффлоада на GPU): 2.68 tok/sec, 1020 tokens, 11.48s to first token.
• Llama 3.1 8B Q8_0 (c полным оффлоадом на GPU): 54.86 tok/sec, 563 tokens, 0.60s to first token.
• Llama 3.1 8B Q8_0 (без оффлоада на GPU): 5.52 tok/sec, 646 tokens, 0.21s to first token.
Пояснения:
• Оффлоад на GPU, в контексте запуска LLM, означает перенос части вычислений с центрального процессора (CPU) на графический процессор (GPU).
Их архитектура хорошо подходит для параллельных вычислений, которые необходимы при работе с нейросетями. Перенос части операций на GPU позволяет значительно ускорить процесс инференса.
• Q6_K, IQ4_XS, Q8_0: Эти обозначения указывают на тип квантизации, использованный для уменьшения размера модели. Квантизация - это процесс уменьшения точности весов модели, что позволяет уменьшить её размер и требования к памяти, но может снизить качество генерации. Разные обозначения (Q6_K, IQ4_XS, Q8_0) соответствуют разным методам и уровням квантизации. Чем меньше число в обозначении (например, 4 в IQ4_XS меньше, чем 8 в Q8_0), тем сильнее квантизация и меньше размер модели, но потенциально хуже качество.
Как видите, GPU даёт неслабый прирост, особенно заметно ускорение на Llama 3.1 с 8 миллиардами параметров, где скорость генерации увеличивается с 5.52 tok/sec до 54.86 tok/sec.
Но это всё получено на довольно мощном конфиге стоимостью ~2к евро (уже меньше, наверное). А что же можно получить на типичной печатной машинке?
Ну, на моём стареньком ноутбуке на AMD 3500U + 20Gb Ram вполне получалось запускать инференс маленькой 8B Llama и при некотором терпении получать ответ.
Это удобно в ситуации, когда у тебя нет интернета - перелёт, круиз, прочие командировки.
К сожалению, после обновления LM Studio до версии 0.3.5, у меня на ноутбуке просто перестали загружаться в память модели, нужно разбираться.
Надеюсь, что скоро в LM Studio добавят поддержку мультимодальных сетей и можно будет удобно запускать мультимодальную опенсорсную экстремистскую (META же) Llama 3.2, и кидать в LM Studio картинки