TGViewer
Channel Public Channel
Путеводитель по доказательной политике

Путеводитель по доказательной политике

@evidence_guide

Канал обо всем, что связано с доказательным принятием управленческих решений: оценка программ и политик, стратегический аудит, бюджетирование на основе результатов, прикладная аналитика данных.
Subscribers
701
Photos
29
Videos
0
Links
75
Recent Posts 12 shown
Post #127 236
Вчера OpenAI заявила, что её ИИ нашёл решение “задачи тысячелетия” - задачи Навье-Стокса, физического описания движения вязких жидкостей и газов. Но вокруг объявления результатов возник конфликт

Два математика (Тристан Бакмастер, Левент Альпёге из Anthropic) около года работали над связанными задачами, используя ИИ, в том числе сервис OpenAI Codex, загружали туда исследовательские черновики. Когда математики узнали результате OpenAI, возник вопрос, не могли ли неопубликованные наработки пользователей помочь ИИ получить результат. 

Бакмастер пишет, что не знает, были ли использованы их данные. OpenAI утверждает, что команда и агенты не обращались к неопубликованным работам математиков, но не исключает, что данные использования её продуктов могли помочь улучшить модели.

Может ли инструмент, которому мы доверяем свою работу, одновременно становиться нашим конкурентом? Например, когда исследователь находит перспективную идею и использует ИИ, чтобы её проверить, у владельца платформы гораздо больше вычислительных ресурсов, чтобы организовать масштабный исследовательский поиск.

Преимущество - доступный ИИ может дать небольшой исследовательской группе возможности большой лаборатории. Проблема - в контексте подхода Дарона Асемоглу, человек может с ИИ работать эффективнее, но при этом уменьшается его способность договариваться о признании вклада, оплате и условиях работы.  

Кроме того, если исследователь опасается, что предварительные результаты и черновики помогут более сильному конкуренту, разумной реакцией будет скрывать идеи и меньше сотрудничать. Технически обмениваться знаниями становится проще, а экономически - более рискованно.
  • ❤ 5
Post #126 477

Forwarded from Дата-сторителлинг

📈Ищу проекты в сфере исследований, визуализации данных и картографических спецпроектов

Привет, это Андрей Дорожный, автор канала.

Делаю медиапродукты, которые становятся инфоповодами: исследования, карты, рейтинги и индексы, которые попадают в СМИ, пересылаются в соцсетях и используются рынком как источник. 15 лет в медиа и коммуникациях — понимаю, как данные превращаются в новости и какие форматы начинают распространяться, а какие — никому не нужны.

С командой делаем полный цикл: от поиска идеи и аналитики до проектирования формата, разработки, визуализации и запуска проекта как медиапродукта с потенциалом распространения.

Также усиливаю уже готовые исследования клиентов — перевожу их в визуальные и интерактивные форматы, которые проще воспринимаются, цитируются и используются в медиа: карты, дашборды, интерактивные модели, квизы и тесты. Обычно у клиентов такие проекты получают органический охват, цитирование в СМИ и работают как инструмент привлечения внимания к теме или продукту.

Примеры работ:
• карта промышленности России https://industrymap.ru/
• исследование ДТП у школ https://dorozhnij.com/dtp_school
• визуализация исследования креативных кластеров https://creativespace.ru/creative-clusters-research/
• другие проекты тут https://dorozhnij.com/

Если кажется, что это может быть полезно коллегам — можно переслать или сделать репост.
Если это про ваш проект — давайте обсудим на коротком звонке.📞
  • 👍 1
  • 🔥 1
Post #125 637
Подведомственное учреждение Росстата опубликовало вакансию, связанную с построением LLM под нужды Росстата, причем с развилкой - обучение модели с нуля или адаптация существующей модели. На практике развилка иллюзорна. Обучение LLM с нуля - огромные затраты на GPU (вычислительные ресурсы), разметку и подготовку корпуса текстов. Оптимально использовать и дообучать существующие открытые модели под конкретные задачи.

В описании упоминается, что задачи LLM в Росстате - генерация документов, смысловой поиск, вопросно-ответные системы, классификация, суммаризация. Задачи очень общие, но в ключе того, что сейчас делают статистические ведомства в мире (хотя разработки на порталах пока не доступны):

1) семантический поиск и генеративный ответ. Как правило, это поиск на основе метаданных, онтологий и векторных эмбеддингов с доступом через интерфейс и API. Например, в StatsChat от британского ONS веб‑страницы разбиваются на фрагменты, фрагменты переводятся в векторные эмбеддинги, и по запросу пользователя проводится поиск по базе. Результаты передаются в LLM (Flan‑T5‑Large), которая формулирует ответ только на их основе, не придумывая новые факты.

2) данные по запросу на естественном языке (text-to-SQL). Швейцарские статистики разрабатывают чат‑бота Statbot.Swiss. Пользователь задаёт вопрос на естественном языке («Сколько электрических автомобилей в Цюрихе?»), после чего система конвертирует запрос в SQL, извлекает данные из портала, строит графики и выдаёт структурированный ответ.
Аналогично проектируется IMF StatGPT - это перевод запроса пользователя в запросы к официальным API для получения статистики из баз данных, потому что ChatGPT “из коробки” при запросе экономических показателей правильно отвечает в среднем лишь в 34% случаев. AI агент класса text-to-SQL скоро будет на www.sberindex.ru.

3) автоматическая классификация и перевод кодов на новые версии классификаций. Национальный институт статистики и экономических исследований Франции Insee переводит коды экономической деятельности с NACE Rev 2 на новую NACE 2025. LLM получает список допустимых кодов и их описания, анализирует описание деятельности предприятия и выбирает подходящий код.

ClassifAI от ONS строит эмбеддинги для описаний кодов классификаций, с их помощью подбирает несколько подходящих кодов для текста (например, описания вакансии или деятельности), обращается к LLM (Gemini‑Pro) для выбора лучшего кода. Может задать уточняющий вопрос.

4) Редактирование и генерация метаданных. Банк международных расчётов BIS сделал «BIS Metadata AI Editor»на основе SDMX: статистик загружает файл метаданных, приложение генерирует исправленный дополненный вариант, дальше можно принять, отклонить или отредактировать результат.

5) Перевод кода на свободные языки программирования. Статистическое управление Ирландии разработало «SAS‑to‑R Transcompiler» на базе GPT‑4, который автоматически переводит код SAS в R, облегчая переход на открытое ПО.

6) Генерация аналитических документов. Национальный институт статистики и географии Мексики INEGI сделал прототип, в котором LLM генерирует аналитические отчёты на основе внутренних данных. Процесс состоит из 4 этапов: определить набор экономических индикаторов, получить индикаторы через API, передать результаты модели (Mixtral 8×7B) для интерпретации и сформировать текст отчёта. Все расчёты выполняются внешними скриптами, не LLM, то есть вычисления контролируемые.

Также статистики экспериментируют с таргетированной коммуникацией для разных групп пользователей, генерацией синтетических данных, аннотированием выбросов (привязка к событиям).

Всё это строится на открытых моделях, при этом даже важнее не сама LLM, а связка между AI и проверенными данными. Именно эту задачу пытается решить инициатива Global Trusted Data Commons: AI‑readiness для официальной статистики предполагает:
- использование стандарта SDMX, обогащенное описание метаданных (позволит устанавливать соответствие между, например, инфляцией и ИПЦ)
- открытые API, чтобы модели могли запрашивать статистику напрямую у первоисточника и обеспечивать неизменную точность.
  • 👍 9
  • 🔥 5
Post #124 953
Несмотря на огромный поток информации, мы по-прежнему многого не знаем об экономике, людях и территориях. Запустили конкурс по дата-журналистике и визуализациям на муниципальных (и не только) данных.
  • ❤ 12
Post #121 858

Forwarded from Конкурс СберИндекс/Муниципальный код

Объявляем старт приема работ на первый конкурс СберИндекса по дата-историям и визуализации данных «Муниципальный код»

Если вы любите копаться в статистике, умеете извлекать смыслы из массива таблиц и верите, что данные способны помогать людям лучше понимать мир вокруг нас, подавайте проекты на наш конкурс до 14 ноября.

Конкурс пройдет по номинациям «Дата-история» и «Визуализация данных и инфографика». Авторы лучших проектов поборются за:
— денежный приз
— возможность опубликовать результаты на медиа-площадках СберИндекса
— приглашение на стажировку в Лабораторию СберИндекс.

Чтобы участвовать в конкурсе, нужно:
1. Выбрать номинацию
2. Сформулировать решаемую задачу или выбрать из предложенных на сайте
3. Использовать в работе хотя бы один набор данных Лаборатории Сбериндекс
4. Оформить проект и отправить его через форму на сайте

Работу можно выполнять индивидуально или в команде до четырех человек. Подробности о конкурсе опубликованы на сайте.

17 и 20 октября мы проведем вводные вебинары, посвященные данным, работе над проектами и визуализациям. После выступления спикеров можно будет задать вопросы.

Участвуйте в конкурсе и превращайте сложные массивы информации в увлекательные проекты!

#конкурс #муниципальный_код #сбериндекс
Post #119 2.64K
Интересное применение GenAI — Research Gap Finder для поиска пробелов в исследовательских областях. В ответ на запрос показывает, где в теме не хватает:
◽️теории (нет актуальной теоретической рамки)
◽️методологии
◽️или эмпирических результатов.

Оговорка - результаты, конечно, стоит верифицировать более детальным обзором литературы. AnswerThis также предлагает как продукты других AI агентов для исследователей, с доступом к 250+ млн статей.

https://answerthis.io/ai/research-gap-finder?fpr=razia75
  • 👍 15
Post #112 1.39K
  • 👍 1
Post #111 1.24K
Будущее рабочих процессов с AI агентами: рамка для аудита

Быстрое внедрение AI-агентов в бизнесе и госуправлении будет основным фактором трансформации рабочих процессов в ближайшее время. Полезно иметь рамку для аудита, чтобы понимать:
◽️ что фактически автоматизируется в организации;
◽️ требуется ли полная автономность агентов или партнерство с участием человека;
◽️ где именно нужно внедрять AI агентов с точки зрения потенциала, технической реализуемости и мнения сотрудников.

Статья “Future of Work with AI Agents” (Shao et al., 2025, Stanford) как раз описывает такую методологию оценки на уровне выполняемых задач (не целых профессий) и результаты ее применения по итогам сбора мнений 1500 работников из 104 процессий, независимых оценок 52 AI-экспертов для оценки технической реализуемости автоматизации по тем же задачам.

При этом используются ключевые метрики:
◽️ желание автоматизации со стороны работника;
◽️техническая реализуемость задачи современными AI-агентами;
◽️ желаемый и допустимый уровень человеческой вовлечённости, который оценивается по шкале Human Agency Scale от 1 (полная автономность) до 5 (незаменимость человека):
- H1 - AI агент полностью выполняет задачу самостоятельно
- H2 - требуется минимальное участие человека
- H3 - равное партнёрство: AI агент и человек дополняют друг друга (доминирует в 45.2% профессий, по мнению сотрудников)
- H4 - AI агент нуждается в регулярном вмешательстве человека
- H5 - AI агент неспособен выполнять задачу без постоянного участия человека (это только 1% задач)

Работники в целом предпочитают более высокий уровень вовлечения человека, даже если AI-технологии позволяют большую автономию AI-агентов.

Работников в интервью просили кратко описать работу, выполняемые задачи, наиболее частые и важные задачи, используемые инструменты, подробное описание 3 основных задач, чтобы понять их структуру и сложность, мнение о применении AI в работе. Результаты использовались для качественного объяснения результатов анкетирования.

В итоге:
◽️46.1% задач получили положительную оценку для автоматизации. Это в основном рутинные и низкозначимые задачи.
◽️ есть несоответствие между желаемой автоматизацией и техническими возможностями текущего поколения AI агентов (для визуализации соотношение между желаемым и возможным разбили на 4 зоны - зелёная зона (желательно и возможно - приоритет для внедрения), красная зона: возможно, но нежелательно — потенциальный конфликт, R&D-зона: желательно, но пока невозможно - область для исследований, низкий приоритет: ни желания, ни возможности.

Интересно, что анализ инвестиций стартапов Y Combinator и реальных запросов на автоматизацию показал, что 41% компаний ориентированы на задачи, которые либо не желательны для автоматизации, либо малоприоритетны с точки зрения работников. Задачи из "зеленой" и R&D-зоны остаются недоинвестированными.

На основе mixed-effects оценили влияние различных факторов на желание работников автомазировать задачу, помимо самих характеристика задач.
Чаще выступают за автоматизацию:
◽️ респонденты с большим опытом работы и большим уровнем образования (вероятно, лучше понимают, чем AI агенты реально могут помочь)
◽️ с позитивным отношением к AI
◽️ с более высоким доходом
◽️активно используют LLM

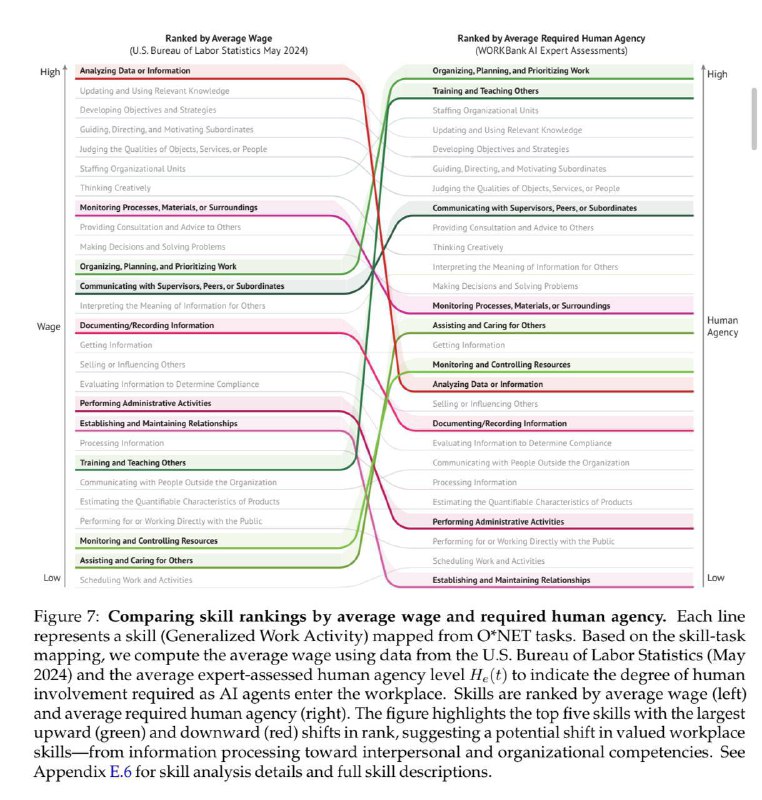
Рисунок 7 о трансформации востребованных компетенции - одно из самых интересных в статье
  • 👍 6
  • 🔥 4
Post #110 1.6K
Мы проводим хакатон на муниципальных данных. Среди задач - аналитика муниципалитетов и регионов, AI-агенты и визуализация детальных данных. Официальная статистика сосредоточена на федеральных и региональных данных, но самое ценное - на уровнях ниже. Участвуйте, будет интересно! 7 июня, Кутузовский, 32

https://www.sberbank.com/ru/hackathon_sberindex
Sberbank Присоединяйтесь к Хакатону СберИндекса Исследуйте страну и общество через данные и создавайте AI-решения, которые помогут лучше понять мир вокруг нас
  • ❤ 12
  • 👍 1
Post #109 1.14K

Forwarded from Счетная палата РФ

Этот день – повод напомнить о масштабном проекте Счетной палаты – «Архив». На специальной странице нашего сайта вы можете найти более 3500 оцифрованных проверок СП с 1996 года.
  • ❤ 6
Post #108 2.76K
Сила историй: цифры не всегда громче всех, и это полезно знать для бизнеса, СМИ и policy

Я уже писала о примечательной, но противоречивой силе числовых фактов, почти автоматически связанных с доверием и объективностью.

Недавнее экспериментальное исследование показывает, что статистика (количественные данные) и истории (качественный нарратив) по-разному влияют на формирование убеждений [1].

В результате ограничений памяти убеждения частично возвращаются со временем к исходному априорному значению для обоих типов информации. Но исследователи обнаружили различие между статистикой и историями в динамике изменения убеждений: влияние историй на убеждения ослабевает меньше, чем влияние статистики.

◽️ Статистика воспринимается как более информативная и в краткосрочной перспективе (Immediate) оказывает большее влияние на убеждения, чем истории.
◽️ Но со временем (Delay) ситуация меняется: влияние статистики уменьшается, и истории в итоге могут оказывать более сильное воздействие. Величина возврата убеждений к априорному значению более чем в два раза выше для статистики (73%), чем для историй (33%), что указывает на более устойчивое воздействие качественных нарративов на убеждения.

Преимущество историй еще и в том, что истории не только "очеловечивают" абстрактные числа, но и помещают данные в запоминаемый контекст. Истории, обогащенные качественными деталями и семантическими связями, легче вспоминаются: участники эксперимента в 62% случаев правильно вспоминали детали историй по сравнению с 27% для статистики.

[1] Graeber, T., Roth, C., & Zimmermann, F. (2024). Stories, statistics, and memory. The Quarterly Journal of Economics, qjae020.
Telegram Путеводитель по док.политике Неправильные данные: любой ответ в кратчайший срок? В мире, где данные играют ключевую роль в принятии решений, удивительно часто появляется утверждение "лучше плохие данные/ доказательства, чем вообще никаких". Понятно, что есть два случая: ◽️ данные…
  • 🔥 14
  • ❤ 4
  • 👍 1
Post #104 8.2K
Анализ российских данных на внутрирегиональном уровне осложняется изменениями границ муниципальных образований, изменениями их типов, названий и кодов ОКТМО.

С 2018 по 2024 гг. изменилась муниципальная структура более 40 регионов:
◽️ есть регионы, где все муниципалитеты меняли свои типы - Магаданская и Курганская области, Ставропольский край, ЯНАО, Удмуртия и др.;
◽️есть регионы, где было большое количество изменений границ - Московская область, Пермский край и др. - около 3% муниципалитетов России в 17 регионах.

Масштаб изменений сильно осложняет сбор панельных данных по муниципалитетам. При этом процесс преобразований не прекращается. Но удобных открытых машиночитаемых данных о таких преобразованиях нет.

Поэтому мы собрали базу данных об изменениях муниципалитетов и их границ, теперь можно:
🔸прочитать в статье на habr о проблемах данных на муниципальном уровне и как мы собрали и объединили данные из Росстата и OpenStreetMap;
🔸скачать с сайта СберИндекса версионный справочник муниципальных образований и пространственный слой с границами муниципалитетов с 2018 г.
 
Эта информация может помочь:
◽️ геоаналитикам, заинтересованным в данных о границах муниципальных образований
◽️исследователям, которые работают с муниципальными данными
◽️при проектировании БДПМО 2.0. Росстата
  • 🔥 18
  • 👍 8
Older posts →

About this channel

How can I read @evidence_guide without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Путеводитель по доказательной политике: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Путеводитель по доказательной политике have?
Путеводитель по доказательной политике (@evidence_guide) has 701 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Путеводитель по доказательной политике know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →