TGViewer
Channel Public Channel
Embrace the data

Embrace the data

@embrace_data

Data (science) dump

NLP, биоинформатика и визуализация данных

Автор - @Screemix
Subscribers
124
Photos
86
Videos
3
Links
45

Showing posts older than #67 · Back to latest

Older Posts 12 shown
Post #66 303
🥲
  • 💅 1
Post #62 318
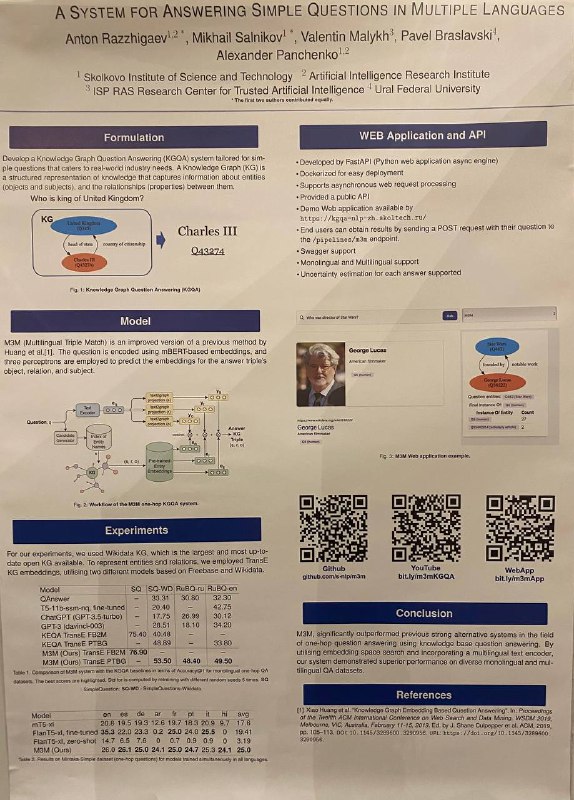
Так же прикрепляю подборку моих постеров-фаворитов 💛
  • ❤ 2
Post #55 311
Fall into ML

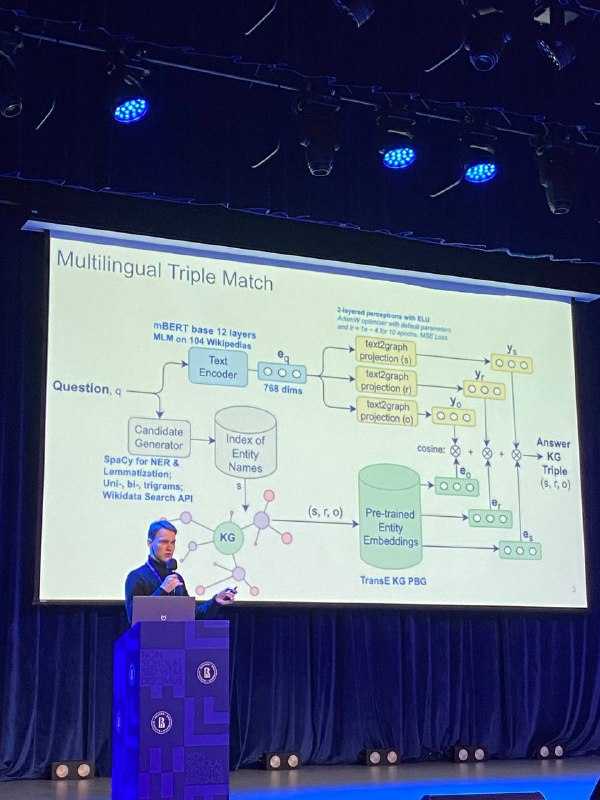
На выходных успела побывать на коференции от вышки, посвященную разным направлениям и сферам применения ML. К сожалению, из-за того, что мне нужно было сделать дела в ИТМО в Санкт-Петербурге, я смогла приехать только на последний день, чтобы выступить со своей работой на постерной сессии.

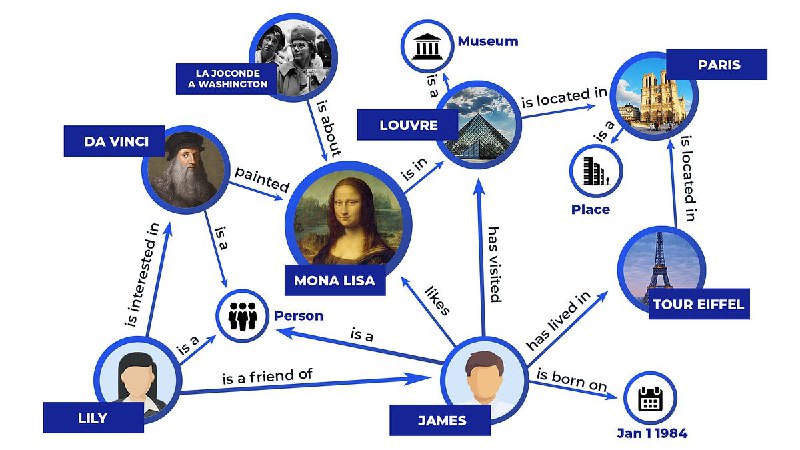
Хотелось бы отметить отличный уровень докладчиков - ты можешь не быть специалистом в RL, но тот же Александр Панов, как и обычно, настолько понятно объяснит идею и плюсы своего исследования, что ты поймешь все и заинтересуешься еще больше. Было очень много докладов про теоретический ML, но и практический не обошли стороной - очень рада, что тема применения Knowledge Graph-ов в NLP and beyond становится такой популярной и много лабораторий начинают интересоваться этим направлением, как и adversarial attacks в NLP.

Мероприятие прошло отлично, потому что лично я ушла с него на позитивной ноте - очень здорово видеть, что в у нас все еще много талантливых ученых и молодых ребят, которые интересуются наукой и с совсем юного возраста занимаются исследованиями.

Конференции казались мне непонятным мероприятием, особенно такие, где нет proceedings, а больше проходящие в режиме докладов об уже опубликованных и принятых на конференции исследованиях. Но оказалось, что слушать про то, чем занимаются коллеги это очень важно и интересно. Помимо уже надоевшего всем нетворкинга (что не отменяет его важности в академической среде!), посещение таких мероприятий сильно расширяет твой кругозор и понимание домена твоих исследований, а еще можно получить и дать много дельных советов о том, как можно продолжать свои исследования.

Очень советую посмотреть доклады в записи. Найти их можно тут.
  • ❤ 1
Post #53 266
Из интересного - у меня карие-зеленые глаза, которые достаточно точно отображаются на всех стилях, кроме Модильяни. Там они какие-то прозрачно-голубые. Моя теория - у Модильяне мало картин с нарисованными глазами и сетка обучилась делать их всем очень светлыми
Post #52 277
Всегда мечтала быть нарисованной Модильяни или Фридой Кало 🥹

Замечательная команда из AIRI выложили тулзу для того, чтобы все могли попробовать быть нарисованными любимыми художниками. Highly recommend как говорят у нас в Осиново!

Угадайте, каких еще художников я использовала для переноса стиля в этом видео :)
  • ❤ 4
Post #51 280
Где найти вдохновения дописать статью на конференцию, у меня не получается писать
Post #49 329
Dump d'Alla 💅🏻 Я: стесняюсь сказать о том, что мы публикуемся на emnlp, хотя работала над этим последний год, думаю, что результаты не прямо вау, пишу пост на радостях и стираю, боясь преувеличить свои заслуги Мой научрук:
Пока статья ожидает своего места в EMNLP findings, приглашаю почитать небольшой пост о нашей работе
Medium Improving Knowledge Graph Completion with Generative LM and neighbors Combining both internal LM knowledge and external data from KG
Post #48 295

Forwarded from Dump d'Alla 💅🏻

Я: стесняюсь сказать о том, что мы публикуемся на emnlp, хотя работала над этим последний год, думаю, что результаты не прямо вау, пишу пост на радостях и стираю, боясь преувеличить свои заслуги
Мой научрук:
  • 😁 2
  • ❤ 1
Post #45 396
Embrace the data Очень крутая статья про ai-written text detection. Ребята детектируют текст, не тренируя модель, а используя разницу внутренней размерности эмбеддингов предобученной RoBERTa. Получаются действительно устойчивые результаты для разных языков и датасетов, а это…
Как пишет сам OpenAi для своего аналогичного решения:

- AI-written text can be edited to evade the classifier. Classifiers like ours can be updated and retrained based on successful attacks, but it is unclear whether detection has an advantage in the long-term.
- Classifiers based on neural networks are known to be poorly calibrated outside of their training data. For inputs that are very different from text in our training set, the classifier is sometimes extremely confident in a wrong prediction.
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →