TGViewer
Channel Public Channel
Embrace the data

Embrace the data

@embrace_data

Data (science) dump

NLP, биоинформатика и визуализация данных

Автор - @Screemix
Subscribers
124
Photos
86
Videos
3
Links
45
Recent Posts 18 shown
Post #153 354
  • 🥰 6
  • ✍ 4
  • ❤ 2
  • 💅 2
Post #151 309

Forwarded from Рандомные галлюцинации

Сегодня мы рады представить результаты нашей работы последних месяцев — семейство специализированных SLM-моделей OCC-RAG для question answering по контексту. Несмотря на компактный размер (всего 0.6B и 1.7B параметров), наши модели способны отвечать на сложные multi-hop вопросы, рассуждать по шагам и, что особенно важно, корректно отказываться от ответа, если в контексте недостаточно информации.

Как нам удалось этого добиться?

📚 Сложные синтетические вопросы-ответы

Для обучения моделей нужны большие объемы качественных данных. Однако большинство открытых QA-датасетов уже давно стали частью обучающих выборок современных LLM и плохо подходят для развития сложного рассуждения. Поэтому мы построили собственный пайплайн генерации данных. С помощью Wikontic мы извлекаем граф знаний из текстов и затем генерируем вопросы на основе путей в этом графе. Такой подход позволяет создавать действительно сложные multi-hop вопросы, требующие объединения информации из нескольких источников.

В результате мы получили:
— миллионы одношаговых вопросов;
— сотни тысяч multi-hop вопросов;
— специальные примеры с контекстами-дистракторами;
— задачи, в которых правильным ответом является отказ от ответа.

⚙️ Mid-training и curriculum learning

В качестве базовых моделей мы использовали Qwen3-0.6B и Qwen3-1.7B. Далее провели масштабный mid-training на более чем 3 миллионах сгенерированных примеров. Обучение строилось по принципу curriculum learning: сначала модель осваивает простые одношаговые вопросы, а затем постепенно переходит к сложным multi-hop сценариям.

🏆 Результаты

Мы протестировали OCC-RAG на популярных QA-бенчмарках, включая HotpotQA, MuSiQue, TAT-QA, а также ConFiQA — одном из самых строгих тестов на faithfulness, который проверяет способность модели следовать контексту даже тогда, когда он противоречит общеизвестным фактам.

Результаты превзошли наши ожидания:

— OCC-RAG показывает качество на уровне моделей в 2–6 раз больше по размеру;
— на задачах multi-hop reasoning наши модели конкурируют с моделями класса 8B–14B;
— на ConFiQA OCC-RAG превосходит даже Qwen3-32B;
— модели существенно лучше следуют контексту и значительно реже подменяют его своими внутренними знаниями;
— среди специализированных малых моделей для QA OCC-RAG показывает лучшие результаты.

Что это означает?

Мы показали, что маленькие специализированные модели могут конкурировать с гораздо более крупными LLM, если правильно подойти к данным и процессу обучения. Это открывает путь к созданию более дешёвых, быстрых и надёжных систем для RAG, поиска информации и корпоративных QA-решений.


Если работа показалась вам интересной — будем рады вашим лайкам, репостам и вопросам 👇
https://huggingface.co/papers/2606.00683

🌐Рандомные галлюцинации
  • 🔥 4
  • 👍 1
Post #149 309
Приглашаем вас на летнюю школу AIRI!

Отличный шанс попробовать поработать над интересными проектами и, возможно, продолжить работать над ними под руководством опытных коллег. А еще это повод сменить обстановку, познакомиться с умными и мотивированными ребятами и специалистами.

https://t.me/airi_research_institute/1257
Telegram Институт AIRI 🚀 Открываем приём заявок на Лето с AIRI 2026! Юбилейная Летняя школа по искусственному интеллекту пройдёт в Первом университетском лицее имени Н.И. Лобачевского при МГУ в городе Усть-Лабинск, Краснодарский край. Даты проведения — с 21 июля по 4 августа.…
  • ❤‍🔥 2
  • ❤ 2
  • 🥰 1
Post #148 339

Forwarded from Рандомные галлюцинации

📜Multimodal Evaluation of Russian-language Architectures
Мультимодальный бенчмарк, содержащий текст, изображения, аудио и видео, учитывающий культурно‑языковую специфику русского и предлагающий универсальную таксономию мультимодальных способностей языковых моделей

📜Detecting Overflow in Compressed Token Representations for Retrieval-Augmented Generation
Авторы предлагают механизм обнаружения случаев, когда компрессия входной последовательности удаляет существенную информацию

📜Call, Reward, Repeat: Advancing Dialog State Tracking with GRPO and Function Calling
Авторы используют GRPO для улучшения Dialog State Tracking в условиях небольшого количества обучающих данных, показывая, что такой подход позволяет превзойти предыдущие методы даже при меньшем объёме обучающих данных
Post #147 267

Forwarded from Рандомные галлюцинации

🚀 Первый день EACL 2026 в Рабате, Марокко!

Друзья, сегодня стартовала европейская конференция EACL в солнечном Рабате! Как всегда, буду подробно освещать самые интересные работы по NLP. Начну с краткого обзора работ от наших коллег.

📜Wikontic: Constructing Wikidata-Aligned, Ontology-Aware Knowledge Graphs with Large Language Models
Wikontic — многошаговый конвейер построения компактных, онтологически согласованных с Wikidata графов знаний из открытых текстов, который достигает высокого покрытия ответов в многошаговых QA‑задачах при существенно меньших затратах токенов

📜DRAGOn: Designing RAG On Periodically Updated Corpus
DRAGOn — методология проектирования RAG‑бенчмарков на периодически обновляемых корпусах, сочетающую автоматическую генерацию вопросов‑ответов по извлечённому графу знаний

(продолжение следует)
Post #146 238
Post #145 283
  • 😁 1
Post #144 395
В продолжении заметки Айдара о наших похождениях на AAAI, предлагаю почитать о статье, которую мы презентовали на демо-сессии AAAI-2026 на русском языке на хабре.
  • 👍 4
Post #143 422
Каждый уже, наверное, слышал про SAE — разреженные автоэнкодеры — способные интерпретировать нейронные сети.

Популярность SAE обязаны публикациям исследований от Anthropic. Однако не смотря на весь хайп, с последующими попытками применить и исследовать эти автоэнкодеры возникали сомнения в том, насколько они способны обнаруживать важные и полезные фичи.

Что если на самом деле SAE не обучаются значимым признакам — они лишь немного лучше случайных моделей?

Коллеги показали, что SAE в их текущем виде недостаточно надежны для декомпозиции и понимания внутренних механизмов моделей. Существующие метрики для SAE (reconstruction, interpretability scores, sparse probing, causal editing) недостаточны для оценки того, выучили ли автоэнкодеры полезные и важные фичи.

Также авторы предлагают простые методы проверки, позволяющие убедиться в том, что SAE обучаются осмысленным разложениям признаков, чтобы дополнить их оценку.

Читаем статью и ставим апвоуты на хф!
  • ❤ 6
Post #142 300
Между конференциями, пока все в ожидании ревью на свои работы и процессе написания ревью на работы коллег, предлагаю почитать небольшую статью Айдара о том, как прошел AAAI-2026.
  • ❤ 5
Post #141 487
Выложили препринт Wikontic-a, пайплайна для извлечения графов знаний из текста, который позволяет графам быть более компактными и согласованными с онтологией (в данном случае с онтологией Wikidata).

Будем благодарны upvote!

https://huggingface.co/papers/2512.00590

репо - https://github.com/screemix/Wikontic
huggingface.co Paper page - Wikontic: Constructing Wikidata-Aligned, Ontology-Aware Knowledge Graphs with Large Language Models Join the discussion on this paper page
  • ❤ 6
  • 👍 2
Post #140 525
Wordle для тех, кто любит смотреть на графики и искать в них инсайты 📊
Оказалось правда очень инетерсно и познавательно. Большинство задачек очень логичные и требуют небольших знаний географии, современной истории и здравого смысла.

https://chartle.cc/
chartle.cc Chartle - A daily chart game Guess the country in red by analysing today's chart
  • ❤ 5
Post #139 446
Интересная и короткая обзорная статья про то, как еще можно использовать графы знаний для LLM.

Предлагается составлять граф структурных и семантических связей веб-страниц для оценки и составления бенчей для веб-агентов. В комментариях обсуждения еще интереснее - кто-то считает, что это уход от той гибкости, которую нам давали LLM в сторону четко заданных алгоритмов; а кто-то наоборот считает, что это удачное дополнение для оценки сложноинтерпретируемых систем.
Post #138 547
cursed timeline
  • 🥰 3
Post #135 647
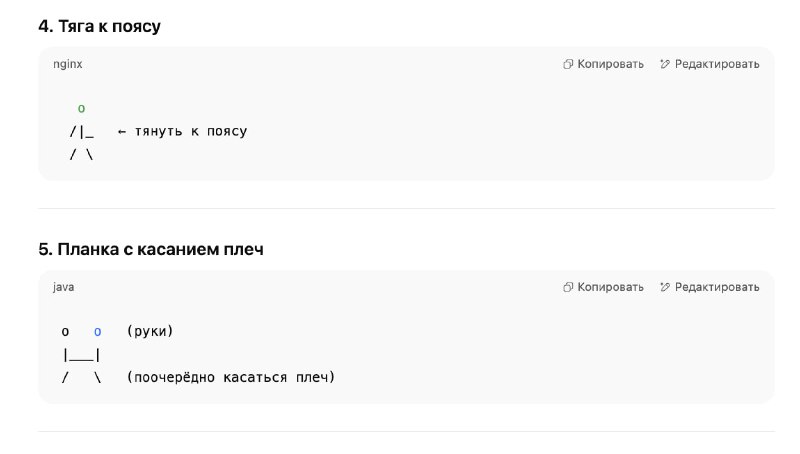
У chatgpt кончился лимит на генерацию картинок, и она проявила инициативу - предложила сгенерировать ASCII-схемы для упражнений на спину для меня

Не знаю как спину, но настроение мне точно улучшило
  • ❤ 4
  • 🥰 4
  • 💘 1
Older posts →

About this channel

How can I read @embrace_data without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Embrace the data: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Embrace the data have?
Embrace the data (@embrace_data) has 124 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Embrace the data know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →