

Как устроен этот ваш BERT 👀В первую очередь, этот пост расчитан для новичков, для тех кто только входит в мир DS ✏️
Верхнеуровнего BERT превращает текст в цифры, то есть хавает "Я хочу пиццу", а на выходе даёт что-то типо [0.21, 0.19, 0.14, 0.12]. Эти цифры позволяют комьютеру "понимать" текст на комьютерном языке.
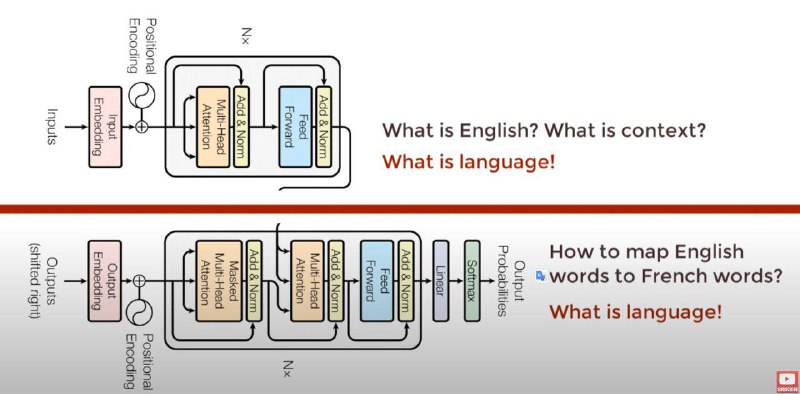
Теперь немного глубже. BERT основан на архитектуре, называемой трансформером. У трансформера две части: энкодер и декодер (1 картинка)
➡️ Энкодер берет текст и превращает его в числа (вектора). Это нужно для анализа текста и понимания его смысла.
➡️ Декодер берет числа и снова превращает их в текст. Например, такие модели используются для генерации ответов, как в ChatGPT.
BERT использует энкодер, что делает его топовым инструментом для таких задач как:
1️⃣ Определение тональности текста
2️⃣ Поиск похожих по смыслу предложений
3️⃣ Ответы на вопросы на основе текста
BERT обучался на двух ключевых задачах, которые помогли ему стать такой мощной моделью: (2 картинка)
1️⃣ Masked Language Modeling (MLM) — задача, при которой некоторые слова в предложении маскируются, и модель должна предсказать эти скрытые слова. Например, если мы берем предложение "Я [MASK] пиццу", модель должна угадать, что на месте [MASK] стоит слово "хочу". Это учит модель понимать контекст и связи между словами. Если угадала, то мы её хвалим, если нет, то пинаем по голове, шобы такого больше не было. 😕
2️⃣ Next Sentence Prediction (NSP) — задача предсказания следующего предложения. Модели дают два предложения, и она должна определить, логически ли они связаны. Например, если предложения: "Я хочу пиццу. Я съел деда.", модель должна понять, что они связаны по смыслу. Это учит BERT анализировать связи между предложениями и целыми текстами. Опять же, угадала - хвалим, не угадала - бьём. 💥
Модель произвела большой скачок в сфере, так как модель принесла 💪
1️⃣ Двустороннее (bidirectional) понимание контекста - Word2Vec, FastText, RNN не обладали таким же глубоким понимаем контекста, как BERT.
2️⃣ Transfer Learning - когда можешь взять эту базовую модель, заморить первые слои и обучить последние слои на свои задачи
3️⃣ Универсальность - модель способна обучаться на любых задачах связанной с текстом.
Ссылки для более глубоко понимания BERT:
- Transformer, explained in detail | Igor Kotenkov | NLP Lecture (in Russian) - советую посмотреть весь видос
- BERT Neural Network - EXPLAINED!
- BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding
- Оригинальная статья BERT