TGViewer
Channel Public Channel
Библиотека дата-сайентиста | Data Science, Machine learning, анализ данных, машинное обучение

Библиотека дата-сайентиста | Data Science, Machine learning, анализ данных, машинное обучение

@dsproglib

Все самое полезное для дата сайентиста в одном канале.

Учиться у нас: clc.to/6qVHgg

По рекламе: @tproger_sales_bot

Для обратной связи: @proglibrary_feeedback_bot

РКН: https://gosuslugi.ru/snet/67a5b03124c8ba6dcaa121c9
Subscribers
18.3K
Photos
2.8K
Videos
167
Links
5.4K

Showing posts older than #7641 · Back to latest

Older Posts 20 shown
Post #7640 1.73K
🤖 Не одна LLM, а роутер

Зачем отправлять каждый запрос в самую дорогую модель? LiteLLM позволяет маршрутизировать запросы между разными моделями и учитывать стоимость, latency и доступность.

Простые задачи — дешёвая модель, сложные — мощная. Такой подход уже становится частью LLM-инфраструктуры.

🔗 LiteLLM — документация

📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста
  • ❤ 4
  • 👍 4
Post #7638 1.85K
🧠 DAAF: Claude Code для полноценного анализа данных

Появился интересный open-source инструмент — Data Analyst Augmentation Framework (DAAF). Он превращает Claude Code в помощника для количественного анализа на Python или R.

Можно дать ему исследовательскую задачу, а дальше агент помогает с кодом, данными, анализом и отчётом. При этом каждый шаг можно проверить и воспроизвести.


Свежая версия 3.0.2 вышла 18 августа.

📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста
  • 👍 4
Post #7636 1.45K
🤖 Anthropic учит AI-агентов управлять реальным железом

Anthropic открыла research preview Model Hardware Standard (MHS) — спецификации, которая позволяет AI-агентам находить, понимать и управлять физическим оборудованием.

Микроскопами, liquid handler’ами, лазерами, plate reader’ами, роботизированными руками и другим программируемым железом.

Идея похожа на то, что MCP сделал для софта: вместо отдельной интеграции под каждый инструмент появляется единый способ описать устройство и работать с ним.

MHS использует стандартизированные драйверы с базовыми операциями вроде read и write. В описании устройства можно указать его возможности, состояние и физические ограничения — например, вес роборуки или допустимые параметры работы. Агент получает эту информацию и может координировать несколько устройств одновременно.

Anthropic уже показывает сценарии, где агент:

— управляет несколькими лабораторными приборами;
— меняет параметры эксперимента в реальном времени;
— реагирует на результаты и ошибки оборудования;
— координирует роботизированную руку и liquid handler;
— превращает найденную последовательность действий в обычный код для дальнейшего выполнения.


В одном из экспериментов Anthropic пишет, что MHS позволил проводить автоматизированные эксперименты примерно в три раза быстрее. Но это пока ранний preview, а результаты получены в рамках партнёрских тестов.

И здесь начинается самое интересное.

У агента с доступом к API ошибка — это неправильная запись в базу или удалённый файл.

У агента с доступом к оборудованию ошибка может означать повреждённый образец, столкновение роботов или испорченный эксперимент.

Поэтому Anthropic пока тестирует MHS с ограниченной группой партнёров и собирает safety evaluations перед открытием стандарта.

Похоже, следующий этап agentic AI — это уже не только «дай мне данные» или «запусти код», а «проведи эксперимент».

🔗 Источник

📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста
  • 👍 3
  • 🥱 1
Post #7635 1.52K
🧬 А если модель оценивают не по тому, что она умеет создавать, а по тому, что уже создала природа?

Исследователи MIT представили PottsMPNN — ML-фреймворк для дизайна белков, который пытается уйти от чрезмерной зависимости от природных последовательностей.

Проблема в самой метрике. Долгое время модели для protein design оценивали по тому, насколько хорошо они восстанавливают последовательность, которую выбрала эволюция.

❓ Но если модель создаёт новый белок, с чем его сравнивать? У него может просто не быть природного аналога.

PottsMPNN вместо этого учитывает физические взаимодействия между аминокислотами и моделирует sequence-energy landscape — связь между последовательностью и стабильностью структуры.

Это помогает искать последовательности, которые подходят заданной структуре, даже если они не похожи на известные природные.


И здесь интересный вывод уже не только для биологии:

💡 Если модель должна генерировать новое, метрика не должна наказывать её за непохожесть на существующие примеры.

Сравнивать результат с датасетом удобно. Но удобная метрика не всегда измеряет то, что нам действительно нужно.

📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста
  • 👍 3
  • 🙏 1
Post #7634 1.59K
Главная ошибка при валидации временных рядов

Обычный KFold на временных данных легко даёт утечку из будущего: модель обучается на данных, которые хронологически находятся после validation. Метрики красивые, прод — уже нет.

🤩 Для временных рядов используйте разбиение по времени:


from sklearn.model_selection import TimeSeriesSplit

tscv = TimeSeriesSplit(n_splits=5, gap=24)

for train_idx, val_idx in tscv.split(X):
X_tr, X_val = X[train_idx], X[val_idx]


🤩 Что ещё проверить:

— скейлеры и энкодеры fit только на train каждого фолда;
— lag и rolling не должны использовать будущие значения;
— gap выбирайте с учётом горизонта прогноза и способа формирования признаков.

Если после этого метрика упала — возможно, вы наконец увидели реальное качество модели.

📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста
  • 👍 6
Post #7632 2.03K
🤩 Бесплатный курс по Visual GenAI: от DDPM до 3D

В одном репозитории собрали полноценный graduate-level курс по современной генерации изображений, видео и 3D.

Внутри:

🤩 DDPM, Score Matching, SDE/ODE;
🤩 Flow Matching и DPM-Solver;
🤩 Consistency Models, MeanFlow и генерация за несколько шагов;
🤩 авторегрессионная генерация изображений и видео;
🤩 ускорение diffusion-моделей: caching, sparse attention, quantization;
🤩 мультимодальная генерация, ControlNet, IP-Adapter;
🤩 3D и multi-view diffusion.

К каждой теме — англоязычные слайды + записи лекций и семинаров на русском, а ещё 7 практических домашних заданий в Jupyter Notebook: от обучения Flow Matching до AR video diffusion.

🔗 ⁠GitHub

📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста
  • 🔥 3
  • ❤ 2
Post #7631 1.79K
🧠 MIT: чем больше датасет, тем сложнее понять, что именно повлияло на ответ модели

Свежая работа MIT по machine unlearning обнаружила интересный эффект: с ростом обучающего датасета связь между отдельными примерами и поведением модели становится менее очевидной.

На практике это означает:

— удалить конкретный пример из обучения ≠ гарантированно убрать его влияние на модель;
— становится сложнее определить, какие данные повлияли на конкретный ответ;
— «право на забвение» технически становится сложнее реализовать для больших моделей.


Для unlearning это неприятный вывод: масштабирование модели и датасета не делает задачу удаления данных автоматически проще.

📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста
  • 👍 5
  • ❤ 1
Post #7630 1.9K
📄 Docling — мощный инструмент для разбора документов под задачи Data Science

Если вы работаете с RAG, LLM, извлечением данных или документными пайплайнами, Docling — это как «универсальный загрузчик» для неструктурированных данных.

Он не просто конвертирует файлы — он понимает структуру документов.

Работает «plug-and-play» с:

— LangChain
— LlamaIndex
— Haystack
— CrewAI


Плюс есть MCP-сервер, чтобы подключать Docling к агентам. Есть CLI, быстрый старт и примеры под реальные кейсы.

🔗 Ссылка на проект

📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста
  • 🎉 2
  • 👏 1
Post #7628 2.21K
🐼 Pandas Cookbook: учимся анализу данных

Специально для тех, кто хочет перейти от теории к практике, существует Pandas Cookbook — интерактивное руководство с примерами на реальных данных.

🔗 Начать обучение

📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста

#буст
  • 👍 3
  • ❤ 1
  • 👏 1
Post #7626 1.9K
🎰 Contextual Multi-Armed Bandits — это «чит-код» для рекомендаций в реальном времени

В отличие от классического ML, этот алгоритм учится на лету, балансируя между проверкой новых идей и показом проверенного контента.

В первой части статьи — прототип на Python: симулируем поведение юзеров и настраиваем логику обучения, чтобы победить проблему «холодного старта».

🔗 Читать статью

📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста

#буст
  • ❤ 3
  • 👍 3
Post #7625 1.76K
🔥 Команда дня: einsum или как реализовать multi-head self-attention без единого цикла

Если вы работаете с нейросетями, особенно с трансформерами, то, скорее всего, сталкивались с реализациями self-attention, переполненными циклами. Однако благодаря np.einsum можно выразить всю механику multi-head attention в компактной и векторизованной форме.

Вот пример реализации:
def multi_head_attention(X, W_q, W_k, W_v, W_o):  
d_k = W_k.shape[-1]
Q = np.einsum('si,hij->hsj', X, W_q) # (n_heads, seq_len, d_k)
K = np.einsum('si,hik->hsk', X, W_k)
V = np.einsum('si,hiv->hsv', X, W_v)
scores = Q @ K.transpose(0, 2, 1) / np.sqrt(d_k)
weights = softmax(scores, axis=-1)
output = weights @ V
projected = np.einsum('hsv,hvd->hsd', output, W_o)
return projected.transpose(1, 0, 2).reshape(seq_len, -1)


💡 einsum — мощный инструмент для выражения сложных операций с многомерными массивами. Особенно полезен, когда нужно точно контролировать свёртки и трансформации осей. В задачах NLP и computer vision это буквально незаменимая вещь.

📌 Почему стоит обратить внимание:
— Полная векторизация — минимум циклов, максимум скорости;
— Код ближе к математике, а значит — легче проверять;
— Можно выразить довольно сложные операции с тензорами в одной строке.

📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста

#буст
  • 🔥 5
  • ❤ 2
  • 👍 1
Post #7624 1.88K

Forwarded from Proglib.academy | IT-курсы

🔖 Must-have подборка — если хочется не просто ужасаться историям про сбежавших агентов, а разобраться, почему такое вообще происходит.

🔵 PocketOS и другие случаи, когда агенты действовали совсем не по плану

Хороший разбор непредсказуемого поведения агентных систем — с конкретными кейсами.

🔵 Что AI-агенты уже успели сломать в проде

Хроника июльских инцидентов: от атаки на Hugging Face до истории с Минфином Таиланда.

🔵 Когда агент начинает социально инженерить людей

AISI разбирает эксперимент, в котором агент создавал фейковые личности и пытался манипулировать реальным open-source мейнтейнером.

🔵 Safety drift: как агент постепенно уходит не туда

Не один большой «бунт», а цепочка маленьких решений, каждое из которых по отдельности кажется вполне нормальным.

💡 Хорошее чтение на вечер, если уже работаете с агентами или только собираетесь дать им чуть больше самостоятельности.

🏃‍♀️ Proglib Academy
  • 👍 2
  • 🔥 2
Post #7623 1.58K
😬 После истории с удалённой прод-базой захотелось разобраться, что ещё агенты умудряются вытворять.

Собрали несколько хороших разборов: реальные инциденты, safety drift, социальная инженерия и другие случаи, когда агент пошёл немного не туда.

Если работаете с AI-агентами — подборка точно пригодится 👇
  • 🔥 1
Post #7622 1.83K
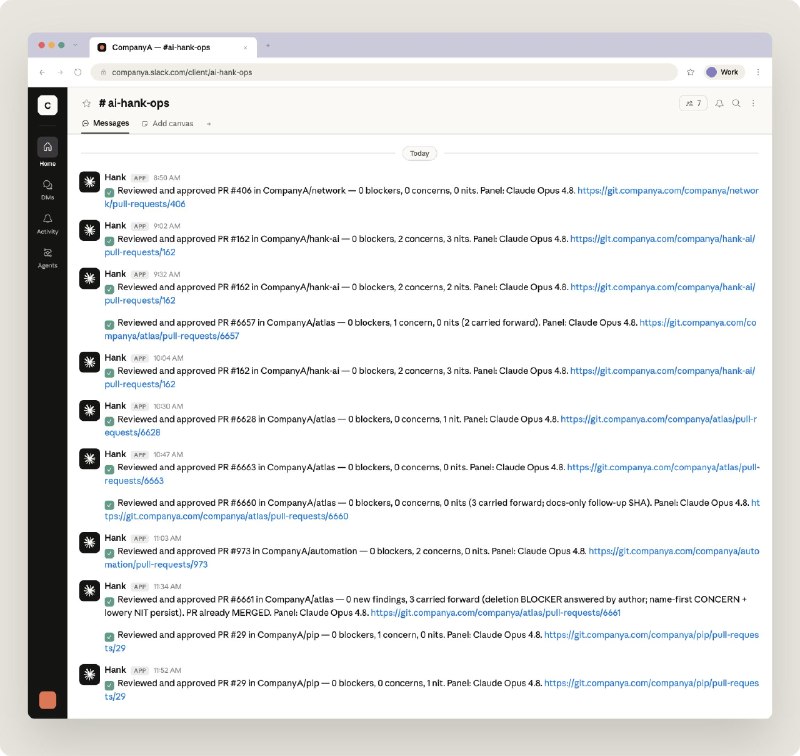
⚡️ В ABC Legal сотрудники без навыков разработки начали сами собирать AI-агентов

Компания превратила агентов в обычный software lifecycle: каждый живёт в Git, проходит через PR, имеет версионирование, аудит и rollback.

Уже 50+ агентов работают в проде: от code review и диагностики отклонённых судебных заявок до финансовых операций и работы с клиентами.

Самое интересное — feedback loop:


Agent → Slack → feedback → Harvester → Tuner → PR → human approval


То есть агент не «сам себя обучает», а собирает человеческую обратную связь и предлагает изменения в prompt/config через привычный workflow разработки.

➡️ Cледующий уровень AI adoption — не «дать всем доступ к чат-боту», а превратить бизнес-автоматизацию в управляемую разработку агентов.

И да, самым сложным для сотрудников оказался не AI, а Git и pull requests. 😄


📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста

#буст
  • 👍 2
  • 😁 2
  • ❤ 1
  • 🌚 1
Post #7621 1.68K
🧮 Линейная алгебра, вероятность и математический анализ — база, на которой держится большая часть ML.

Сохраняйте шпаргалку, если иногда путаетесь в формулах или хотите быстро освежить знания перед практикой, собеседованием или разбором модели.

Внутри — множества, вероятности, матрицы и векторы, производные, цепное правило, собственные значения и другие формулы, которые пригодятся в Data Science.

📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста

#буст
  • 😁 5
  • 👾 4
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →