TGViewer
Channel Public Channel
DATApedia | Data science

DATApedia | Data science

@ds_wiki

Тут вы найдете всё, что связано с Data Science, AI и Machine Learning, как для начинающих, так и для бывалых специалистов. Также, для вас, мы переводим зарубежные статьи.

Сотрудничество: @Seyfme
Subscribers
3.2K
Photos
196
Videos
91
Links
834
Recent Posts 20 shown
Post #1418 169
Как мы ускорили рекомендации на главной в 18 раз

На Авито 240 млн активных объявлений. Половину просмотров и около трети контактов продавцам приносят рекомендации их товаров на главной странице.

Недавно мы изменили архитектуру рекомендаций, и вот что из этого вышло:

🚀 Обновление раз в 20 минут вместо 6 часов.
💜 +1% контактов продавцов с покупателями.

Рассказали на Хабре: «Как мы ускорили коллаборативную модель в рекомендациях».
  • ❤ 1
  • 🔥 1
Post #1414 907
Как векторные базы данных налаживают взаимопонимание между человечеством и роботами

Если в вашем проекте пользователи ищут данные не по точным ключевым запросам, а по смыслу, эта статья для вас. В ней мы расскажем, как работают векторные базы данных, для каких проектов они нужны и как выбрать подходящую в зависимости от задач.

Читать | DATApedia
Post #1413 800
Обзор на Claude Opus 4.6: разбор модели, тесты и сравнение

В этой статье мы обсудим, что именно изменилось в версии 4.6 Opus. Мы разберем возможности модели в программировании, анализе данных и работе с автономными функциями.

Читать | DATApedia
Post #1412 833
Anthropic создала монстра: как самая безопасная компания выпустила самую безрассудную модель

В этой короткой статье вы узнаете и о реальной опасности, которой подвергают нас эти новые, мощные ИИ, и о вполне обыденном, не-фантастическом объяснении того, почему ИИ лгут, шантажируют или действуют безрассудно — всё простыми словами, чтобы вы поняли.

Читать | DATApedia
Post #1410 630
Как оптимизация промптов превратилась из шаманства в инженерную дисциплину

Ещё пару лет назад промпт-инжиниринг выглядел как подбор удачного заклинания: "а давай добавим think step by step, "а давай попросим быть аккуратнее" и о приправим xml-тегами".
Сегодня это типовая задача оптимизации в условиях чёрного ящика.
Промпт -> это не текст, а параметр модели, и оптимизировать его нужно алгоритмически, а не интуитивно.

Читать | DATApedia
Post #1409 680
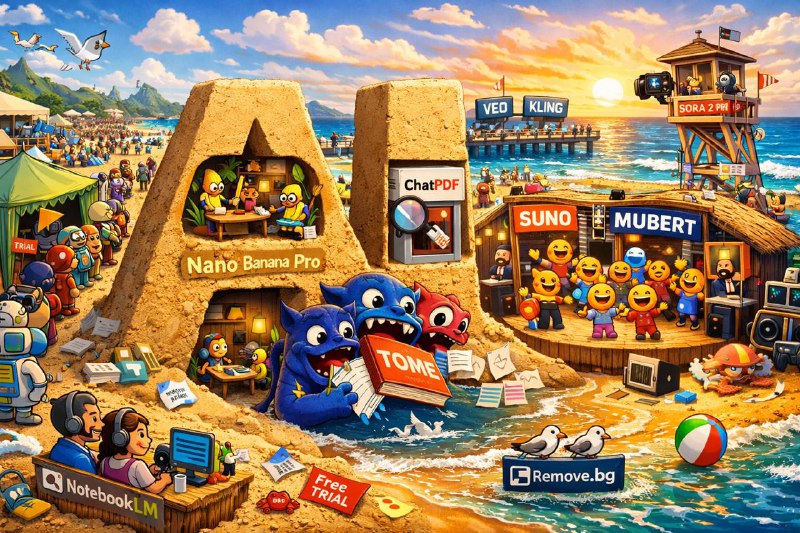
Топ нейросетей и ИИ-сервисов 2026 года: лучшие ИИ-инструменты

В этом обзоре вы найдёте не только известных гигантов вроде ChatGPT 5.2 или Gemini 3, но и другие решения: ChatPDF для документов, SlidesAI для слайдов, Suno для музыки и отечественного “Кандинского” для изображений.

Читать | DATApedia
Post #1408 751
Линейная регрессия, встряска рейтинга и первое место. Часть 1: Ёлочка, живи

Сказ о том, как после долгого перерыва я "взял в руки шашки" (поучаствовал в ML-соревновании) и дотащил задачу на "таблички" до первого места на финальном "приватном" лидерборде с помощью простейшей подготовки фич и классической линейной регрессии с регуляризацией, внезапно обогнав при этом всех модных катбустеров, банально переобучившихся на "паблике".

Читать | DATApedia
  • 👍 3
Post #1406 796
Анатомия трансформеров: почему обычный Self-Attention больше не используют

В этой статье я постараюсь рассказать, как механизм внимания помогает языковым моделям обрабатывать тысячи слов контекста и почему с этим не справлялись в свое время обычные RNN. В конце статьи я расскажу про проблемы классического attention и современные адаптации.

Читать | DATApedia
Post #1405 732
«Галлюцинации LLM — это не баг»: профессор математики объясняет, почему ИИ не перестанет врать

Владимир Крылов, профессор математики, научный консультант Artezio и один из самых глубоких русскоязычных экспертов по применению ИИ в разработке, дал интервью по итогам года. Мы поговорили о том, почему reasoning-модели галлюцинируют вдвое чаще обычных (и это математически неизбежно), почему OpenAI объявил «код красный» и отстаёт от Google, и правда ли, что программисты, умеющие писать код только руками, скоро вымрут как вид. Спойлер: Паваротти не умел читать ноты, и это кое-что говорит о будущем vibe-coding.

Читать | DATApedia
Post #1404 1.06K
🔥 Твоя статья может принести 1 миллион рублей!

ВТБ и Институт ИИ МГУ открыли прием заявок на конкурс Data Fusion Awards для data scientists и ML-исследователей. Ищут лучшие научные статьи 2025 года по ИИ.

Зачем участвовать:
🔵 Продемонстрировать прорыв в математике ИИ, оптимизации или глубоком обучении
🔵Получить признание от лидеров отрасли
🔵 Забрать до 1 млн рублей из призового фонда 3 млн
🔵 Усилить резюме аффилиацией с топ-конкурсом

👉 Подавать заявку до конца января
на сайте
  • 🔥 1
Post #1403 626
Функция потерь: как алгоритм понимает, что он ошибся

Представьте, что вы играете в дартс. Сначала ваши дротики разлетаются по всей мишени, но с каждой попыткой вы постепенно приближаетесь к заветному центру. Человек интуитивно понимает, что нужно скорректировать бросок: сильнее, выше, левее или правее. Примерно так же работает и алгоритм машинного обучения. Только вместо интуиции там есть функция потерь.

Читать | DATApedia
Post #1402 749
Claude Opus 4.5 и конец привычной разработки

Статья о том, почему Claude Opus 4.5 стал переломным моментом в ИИ-разработке. Автор на реальных проектах показывает, как ИИ-агенты уже сегодня способны собирать полноценные приложения — от UI до бэкенда — за считанные часы, и рассуждает о том, зачем человеку вообще читать код в мире AI-first разработки.

Читать | DATApedia
  • 👍 1
Post #1401 842
Создаем простую систему RAG на Python

Представьте, что вы предоставляете своему ИИ конкретные релевантные документы (или фрагменты), которые он может быстро просмотреть, чтобы найти необходимую информацию, прежде чем ответить на ваши вопросы. То есть, вместо поиска по всей базе данных (которая может не поместиться в контекстное окно модели LLM, или даже если поместится, это потребует много токенов для ответов), мы предоставляем LLM только релевантные документы (фрагменты), которые ему необходимо найти, чтобы ответить на вопрос пользователя.

Читать | DATApedia
Post #1400 718
Метрики для задач NLP. Часть 1. Классификация, NER, Кластеризация

В этой статье будет рассказано о популярных метриках для NLP-задач: классификации текста, NER и кластеризации. Рассказ будет сопровождаться визуализацией, примерами и кодом на Python.

Читать | DATApedia
Post #1399 703
Книги, видео и курсы для изучения ML

Собрали бесплатные ресурсы, которые позволят погрузиться в работу с искусственным интеллектом — как для новичков, так и для тех, кто уже работает с ML и хочет углубить знания.

Читать | DATApedia
Post #1397 766
Проверяем качество ИИ без сложной математики

Представьте, что ваша команда только что получила доступ к новейшей AI-модели или внедрила умный чат-бот. Коллеги в восторге от точности, скорости и функциональности инструмента. Но как понять, насколько он действительно хорош?

Читать | DATApedia
  • 👍 1
Post #1396 730
Как системному аналитику перейти в дата-аналитику: советы из личного опыта

Расскажу, что в профессии системного аналитика остается неизменным, какие есть ключевые концепции и инструменты Data-направления и что на самом деле нужно знать для перехода.

Читать | DATApedia
  • ❤ 2
Post #1395 803
Путешествие токена: что конкретно происходит внутри трансформера

Из этой статьи вы узнаете о том, как трансформеры преобразуют входные данные в контекстно-зависимые представления и, в итоге, выдают вероятности, влияющие на выбор слов, которые генерируют большие языковые модели.

Читать | DATApedia
Older posts →

About this channel

How can I read @ds_wiki without a Telegram account?
TGViewer shows the public web preview Telegram publishes for DATApedia | Data science: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does DATApedia | Data science have?
DATApedia | Data science (@ds_wiki) has 3.2K subscribers on Telegram, refreshed roughly every 30 minutes.
Does DATApedia | Data science know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →