Почему модель, обученная с L1-регуляризацией, может приводить к более интерпретируемым результатам по сравнению с L2-регуляризацией?
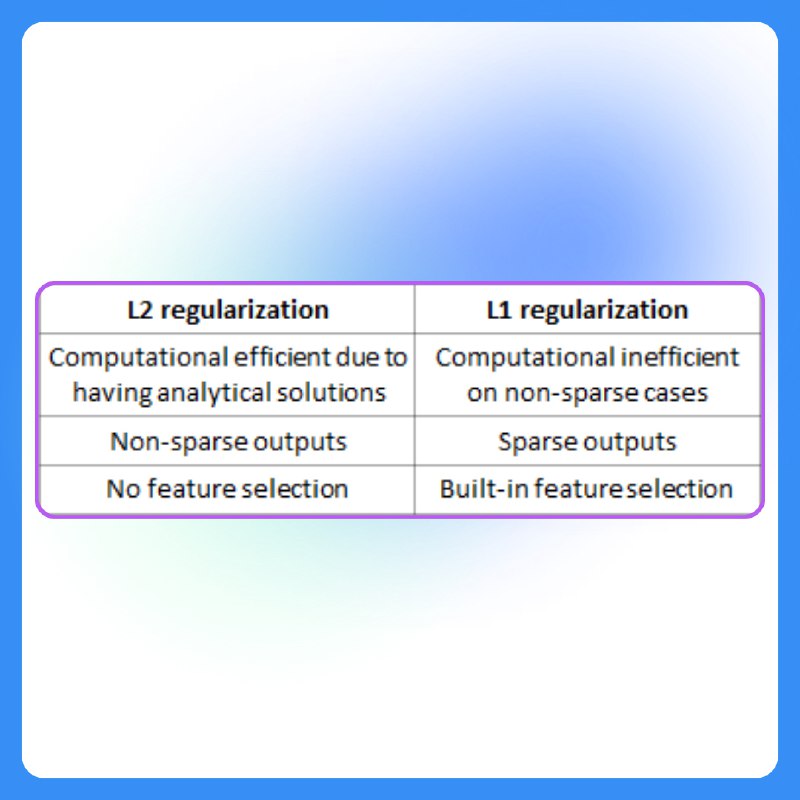
🔹 L1-регуляризация (Lasso) добавляет к функции потерь сумму модулей весов, что способствует обнулению некоторых из них. Это приводит к разреженности модели — многие параметры становятся нулевыми, оставляя только значимые признаки. В результате модель становится проще и легче интерпретируется.
🔹 L2-регуляризация (Ridge) добавляет сумму квадратов весов, но не зануляет их, а только уменьшает. Это делает модель более устойчивой к шуму, но не позволяет выявить наименее значимые признаки.
📌 L1-регуляризация действует как механизм автоматического отбора признаков, что упрощает интерпретацию модели. L2, в свою очередь, помогает сглаживать веса, но не делает модель разреженной.
Post #818
1.07K
- ❤ 4
- 👍 1