TGViewer
Channel Public Channel
Data Quality | Качество данных

Data Quality | Качество данных

@dq_data_quality

Канал о данных, их качестве, подготовке, обработке, проверке.
Автор @Rinnushka
Личный канал https://t.me/rinnushka_life
Subscribers
542
Photos
55
Videos
1
Links
22

Showing posts older than #77 · Back to latest

Older Posts 20 shown
Post #76 397
Привет!
Сегодня последний день приёма заявок на data internals.

Заявку подавать тут: https://cfp.datainternals.ru/
Post #73 353
Провожу исследование, в рамках которого предполагается опрос. Выбираю площадку для проведения. И вот тут просьба к вам, проголосуйте пожалуйста в опросе ниже?
Post #72 419
Основы качества данных, глава четвертая, часть 2/2.

Мысли о мониторинге и обнаружении аномалий в данных.

📎 Аномалии можно описывать кратко и полно, и это будет влиять на скорость устранения. Полное и подробное описание может ускорить решение проблемы.

📎 Основные столпы наблюдения за данными (они же - следующие пункты для поиска аномалий):
4️⃣Схема данных и её изменения.
5️⃣Граф зависимостей данных, их происхождение и путь.

📎 Эвристика, (а на деле - глубокое погружение в процессы и данные), ускоряют поиск аномалий и их устранение.

📎 Гарантировать, что все проблемы, выявленные мониторингом, подлинные - невозможно.

📎 Рекомендуется найти компромисс при настройке мониторингов, чтобы максимизировать истинно положительные и истинно отрицательные результаты и сократить ложные.

📎 Для поиска золотой середины и параметров настройки можно использовать метрики точности моделей для машинного обучения (насколько часто предупреждения верны).

📎 Ложноположительный результат лучше, чем ложноотрицательный (согласны?)

📎 Параметр точности не может быть одинаковым для разных данных.

📎 Лучшие алгоритмы обнаружения аномалий делают три вещи:
1️⃣обнаруживают проблемы как можно раньше
2️⃣сообщают о них тем, кому нужно знать
3️⃣предоставляют информацию, которая поможет сократить простои данных

📎 Лучшие практики мониторингов:
➡️ Определение правил и порогов
➡️Использование авторегрессии (проверка прошлых периодов для прогноза будущих и сравнение реального с прошлым)
➡️ Использование экспоненциального сглаживания

📎 Основные различия между алгоритмом поиска аномалий для DWH и Data Lake
1️⃣Количество точек входа
2️⃣Сбор и хранение метаданных
3️⃣Доступ к метаданным

📎 Должна быть точка оборы - какая-либо базовая истина.

#качестводанных #dataquality #dqf
  • 👍 2
  • 🔥 1
Post #71 332
Основы качества данных, глава четвертая, часть 1/2.

Мысли о мониторинге и обнаружении аномалий в данных.

📎 Аномалии в данных могут появиться из-за причин, не связанных с самими данными (🔥 если такое было)

📎 Чаще всего аномалии выявляются с помощью простых проверок.

📎 Раньше проверка данных считалась полезной, но не обязательной. Сейчас данных больше, их ценность и значимость выше и управление данными, качество данных - уже неотъемлемый атрибут работы с данными.

📎 Можно выделить два основных типа проблем с данными:
1️⃣Известные неизвестные (можно предсказать или предположить, что может пойти не так, большинство можно поймать проверками)
2️⃣Неизвестные неизвестные (как суслик - его никто не видит, а он есть. Например, изменение схемы другой командой, изменение кода, изменение историчных данных, если на это нет отдельных проверок)

📎 Если есть понимание, какие данные считать "хорошими", легче найти "плохие".

📎 Алгоритм обнаружения аномалий:
1️⃣Мониторинг актуальности. Когда данные были обновлены последний раз? Какой период времени приемлем после последнего обновления?
2️⃣Понимание распределения. Какими должны быть ваши данные? Сколько их? Каждый день по 100 строк с похожими цифрами? От чего может завистеть? Есть ли "сезонность" (от времени суток, дня недели, времени года, места)? Предсказуемые колебания? Тут речь про нормальное распределение (распределение Гаусса) и Центральную предельную теорему — сумма большого количества слабо зависимых случайных величин, имеющих примерно одинаковые масштабы, имеет распределение, близкое к нормальному. Готовь сани летом, а покупай зимой, чтобы не сломать магазинам проверки :)
3️⃣Контекст. Какие ранее осуществлённые манипуляции могут быть причиной? Что может быть затронуто еще? На что влияют эти аномалии?

📎 Когда есть ключевой показатель, можно оценить его состояние разными способами. Например, среднее значение, количество нулей или пустых значений.

#качестводанных #dataquality #dqf
  • 👍 2
  • ❤ 1
  • 🔥 1
Post #70 311
  • ❤ 1
  • 🔥 1
Post #69 342
С чего начать утро первого мая?
С подачи заявки на доклад.
После майских карета превратится в тыкву, но ещё можно успеть)

А мы (программный комитет) тем временем переходим на встречи два раза в неделю и увеличиваем их продолжительность в два раза. Индивидуально беседуем с каждым потенциальным спикером, помогаем в подготовке и собираем классную программу! 🔥

Тыкать сюда: https://cfp.datainternals.ru/
cfp.datainternals.ru Data Internals X 2025 Профессиональная конференция про базы данных
  • 🔥 2
Post #67 375
Основы качества данных, глава третья, часть 5/5.

Мысли о проверках данных.

📎 При проверке тест-кейсы пишут с учетом логики работы системы, но она тоже может сломаться

📎 Распространённые проверки:
➡️ Нулевые значения
➡️ Неизвестные значения (NULL)
➡️ Объём
➡️ Факт получения данных и их размер
➡️ Допустимость диапазона данных
➡️ Инварианты

📎 Проверки желательно проводить перед преобразованием и после каждого этапа процесса преобразования, на всех этапах обработки, от приема данных до передачи их дальше

📎 Рекомендуется использовать разные виды проверок:
➡️ Сингулярные (индивидуальные, для конкретной схемы/таблицы/атрибута)
➡️ Модульные (для продукта, схемы, какой-то части данных)
➡️ Общие (шаблонные, которые легко масштабировать):
1️⃣Уникальность
2️⃣Полнота not_null
3️⃣Принадлежность конечному набору данных
4️⃣Ссылочная целостность

📎 Необходимо регулярно актуализировать проверки при изменении/доработке скрипта обработки данных, удалять лишние и добавлять новые

📎 Quality Gate или "автоматический выключатель" - важная штука для качества данных. Если данные не проходят пороговые значения критичных проверок - они не идут дальше по тракту. Стоит использовать только для проверок, ошибки в которых могут привести к серьезным последствиям

📎 Даже при самых жестких проверках могут остаться ошибки в данных.

#качестводанных #dataquality #dqf
  • 👍 3
  • 🔥 1
Post #66 308
Основы качества данных, глава третья, часть 4/5.

Мысли про обработку и преобразование данных.

📎 Пакетная или потоковая обработка - зависит от задач и желаемого результата, у каждого способа свои плюсы и минусы.

📎 Основная разница - в объёме данных, обрабатываемых в каждом пакете и скорости обработки. Качество данных у пакетной обычно выше.

📎 Преобразование данных - неотъемлемая часть работы с данными. Включает в себя:
1️⃣Нормализацию данных. Тут под нормализацией понимается приведение к конечному формату
2️⃣ Работу с разнородными источниками данных, и здесь могут быть свои подводные камни:
➡️ Задержка и рассинхрон данных, особенно при потоковой обработке
➡️ Отсутствие иерархии, вместо "БД+схема+таблица" возможно полотно текста
➡️ Необработанные форматы файлов, например с датчиков
➡️ Необязательные поля
➡️ Гетерогенность данных и необходимость приводить их в структурированную форму
3️⃣Проверку схемы и приведение типов

📎 Изменение схем - основной источник повреждения данных.

📎 Достижение синтаксической и семантической однозначности в данных очень важно! Особенно в рамках одной команды/продукта, на всех этапах работы с данными. Например, поле "dr" можно воспринять как "др." - другое, а можно как "дорогая редакция" - что-то важное. Способ округления чисел, вверх или вниз, имеет значение, а еще стоит учитывать числа с плавающей точкой.
Желающие могут погуглить анекдот про возврат товара с надписью "Х" и "П", он наглядно демонстрирует последствия отсутствия договоренности.

📎 Настроить предпроверку можно в приложениях передачи и обработки данных.

📎 Ничего не сломать при ETL/ELТ (особенно в части преобразования) - возможно. Если очень постараться)

#качестводанных #dataquality #dqf
  • ❤‍🔥 1
  • ❤ 1
  • 👍 1
  • 🔥 1
Post #65 341
Основы качества данных, глава третья, часть 3/*.

Про очистку данных.

📎 Одна из самых больших сложностей на пути к высокому качеству данных - их очистка, удаление неточных данных. Основные способы:

📎 Удаление выбросов. Рекомендуется делать это как можно раньше, если только нет цели найти как раз выбросы.

📎 Оценка особенностей набора данных. Все ли таблицы в схеме нужны для исследования? Все ли поля в таблице? Есть ли однозначная документация на всё это?

📎 Нормализация. Про это много написано, полезная штука.

📎 Реконструкция данных. Например, если данных почему-то нет в небольшом количестве. Пишут, что это неизбежно. Можно использовать интер-/экстраполяцию, категоризацию данных.

📎 Преобразование часового пояса. Мега важная штука! Представьте, что вы летите в новогоднюю ночь с востока на запад и каждый час отмечаете новый год. Какой считать "настоящим"?) должен быть какой-то стандарт, чаще всего это UTC или приведение к нему, иначе можно никогда не узнать, когда произошли события относительно друг друга.

📎 Приведение типов. Данные типизированы, но форматы могут отличаться. Необходимо "причесать" весь имеющийся зоопарк типов и привести к удобным для последующей работы типам.

#качестводанных #dataquality #dqf
  • 👍 2
  • 🔥 1
Post #64 320
Уже через полчаса состоится онлайн встреча с программным комитетом Data Internals 🔥🔥🔥

Ждём всех, кто хочет выступить на Data Internals X 2025 или пока только думает о выступлении.

Обсудим, какие темы будут актуальны на конференции, что для нас важно при отборе заявок в программу и как проходит подготовка спикеров перед выступлением.

Можно (и нужно) задать свои вопросы комитету, в том числе по поводу ваших идей и предложений тем выступлений.

Для участия необходимо зарегистрироваться: http://cfp.datainternals.ru/?utm_source=tg&utm_medium=post&utm_campaign=anons&utm_content=1604#onlinemeetup

До встречи 17 апреля, в 18:00 по московскому времени! 😊

Маякните в комментариях, кто собирается прийти?
cfp.datainternals.ru Data Internals X 2025 Профессиональная конференция про базы данных
Post #63 328
Основы качества данных, глава третья, часть 2/*

О журналах приложений (они же логи), ответах API и данных датчиков.

📎 Данные в логах - результат действий в ПО, пользовательских или внутренних.

📎 Что включать в журнал, а что нет - зависит от разработчиков ПО, данные могут быть не полными.

📎 На что обратить внимание при работе с логами, как источником данных:
1️⃣ Структура, она же формат
2️⃣ Временные метки и их формат
3️⃣ Уровни логов:
➡️ Информация
➡️ Предупреждение
➡️ Ошибка
4️⃣ Цель
➡️ Диагностика
➡️ Аудит

📎 Почему часть инфо берётся через API - потому что своё приложение не может делать всё.

📎 На что обратить внимание при получении данных по API:
1️⃣ Объекты - что нам присылают, JSON, XML что-то ещё
2️⃣ Коды ответов. Например, коды состояния http (200 ok, 404 not found, 500 internal server error и тд) или другие стандарты
3️⃣ Цель использования. От этого зависит, на что обращать внимание, вариант использования может влиять на то, какая информация имеет значение.

📎 Данные датчиков. Тут про интернет вещей (IoT) или исследовательское оборудование с простой логикой.

📎 Важные моменты при работе с данными от датчиков:
1️⃣ Шум. Скорее всего, часть данных будет не репрезентативной и нужно быть готовым к их очистке, поэтому рекомендуется иметь устойчивый последовательный поток.
2️⃣ Режимы отказа. Важно понимать, как каждый из датчиков, с которых собираются данные, сообщает о неполадках: может выдавать ошибку, перестает поставлять данные или показывает рандомную температуру на Марсе.
3️⃣ Цель. Опять же, зачем эти данные собираются: для обучения моделей или решения задач, основанных на логике? В первом случае важен объем, во вторых - минимальная задержка.

📎 Вывод по сбору данных: важно правильно собирать нужные данные. Акцент на оба слова, иначе можно получить совсем не то, что принесет пользу.

#качестводанных #dataquality #dqf
  • 👍 3
  • ❤ 1
  • 🔥 1
Post #62 292
Основы качества данных, глава третья, часть 1/*.

Сбор, очистка, преобразование и проверка данных.

Интересное:
📎 Чтобы получить полное представление о качестве ваших данных, нужно знать весь их жизненный цикл.

📎 Основные шаги, влияющие на общее качество данных: сбор, очистка, преобразование и проверка

📎 Самый важный аспект сбора - точка входа, где данные не обработаны и могут быть структурированы или не структурированы.

📎 Источник данных редко зависит от инженеров, чаще от бизнеса

📎 Все источники данных можно поделить на три категории: журналы приложений, ответы API, данные датчиков. Я бы добавила четвертый, ручной ввод, но, пожалуй, это можно отнести и к приложениям.


Дальше подробнее напишу про каждую из этих категорий и этапы работы с данными

#качестводанных #dataquality #dqf
  • 👍 4
  • 🔥 1
Post #60 325
Недавно общались с коллегами о профессиональном пути к data quality, если всё сложится и всеми согласуется, то скоро будет статья об этом 📰
  • 👍 2
  • 🔥 1
Post #59 374
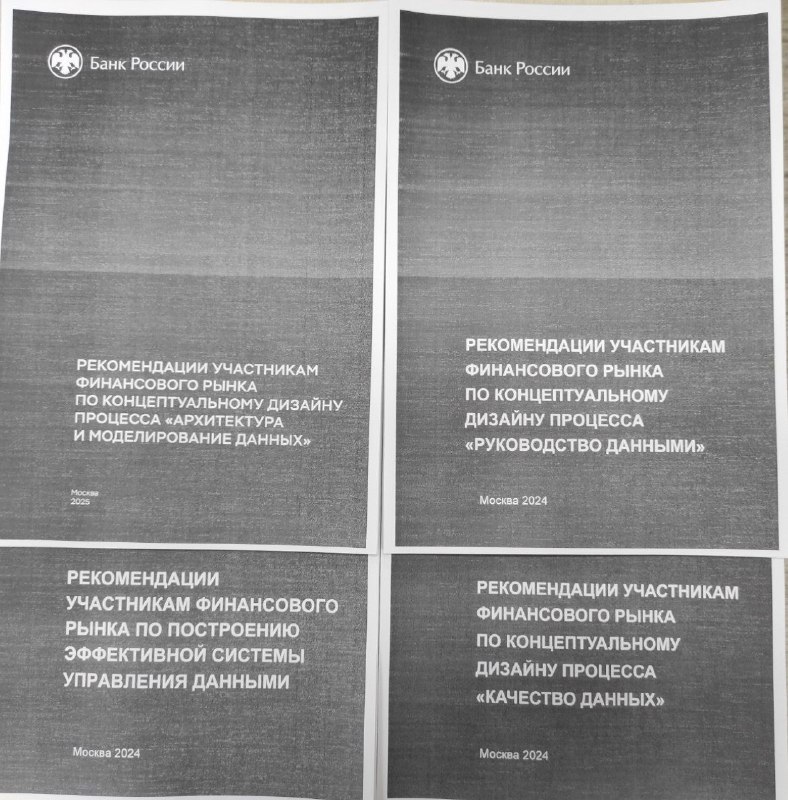
И ещё про управление данными.

Бегло пролистала - полезно для работы.

#качестводанных #dataquality
  • 👍 1
  • 🔥 1
Post #57 358
Вчера выступала на митапе одного из СберПрофи сообществ - DWH/BigData, рассказывала коллегам о том, как у нас в команде устроена работа с качеством данных.

Хорошо, что есть возможность обменяться опытом, узнать, как устроено у других и взять что-то себе в работу.
  • 👍 3
  • 🔥 2
Post #56 351
В канале в сетке уже 3 000 подписчиков! Растём!)
Спасибо за внимание!
  • ❤ 2
  • 🔥 2
Post #55 358
Выступила на Analyst Marathon, привет новоприбывшим 🖐

Понравились ваши вопросы, спасибо)
  • 🔥 5
  • 👍 3
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →