TGViewer
Channel Public Channel
DLStories

DLStories

@dl_stories

Что-то про AI Research и AI образование от Танечки

Сотрудничество/предложения: @atmyre
Subscribers
15.6K
Photos
339
Videos
46
Links
686

Showing posts older than #1026 · Back to latest

Older Posts 15 shown
Post #1023 9.15K
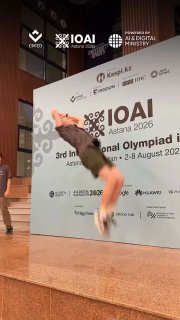
Последние три недели я провела в Москве на сборах перед межнаром IOAI, а сегодня мы прилетели в Астану на сам межнар. Основные индивидуальные туры будут 4 и 6 августа, а пока что, как видите, фоткаемся и бегаем от комаров (они тут очень жёсткие)
  • 🔥 69
  • ❤ 19
  • ❤‍🔥 4
Post #1020 9.54K
В итоге рекорд из 10 попыток — 9.6 секунд на сборку. Среднее значение — что-то вроде 78-80 поворотов/10 секунд на сборку. Для каждой попытки из зала вызывался человек, который либо кнопками вручную, либо с помощью случайного генератора (либо и так, и так) запутывал мегаминкс, затем полученный стейт подавался на вход алгоритму, который искал решение, и затем это решение реализовывалось роботом.

На видео:
1) Как человек собирает мегаминкс (тут сборка за минуту 40 секунд)
2) Как работает пайплайн
3) Одна из 10 попыток сборки: запутывает мегаминкс тут Леша Колегов — один из членов сборной этого года на IOAI (собственно, мы приехали смотреть на мегаминксы с ребятами из команды, с которыми у нас сейчас сборы перед IOAI в Москве)
  • ❤ 46
  • 🔥 17
  • 🥱 2
Post #1019 7.03K
DLStories Я тут несколько раз писала про применения AI в математике, и, в частности, про проект CayleyPy, в котором применяют AI для поиска путей в графах Кэли с огромным числом вершин. Напомню, что их статья про поиск путей в графе кубика Рубика получила Sptlight на…
Приехала на Физтех, где сегодня собираются ставить рекорд по сборке мегаминкса роботом. Правда, выяснилось, что рекорд будет только в 19:00 (а всех звали к 17:30), поэтому пока что сижу работаю. Что ж, посмотрим, поставят ли)

На фотке, как я понимаю, магаминкс в самом роботе, который будет его собирать, и сами разрабы, которые его к рекорду готовят
  • ❤ 50
  • 🔥 15
  • 👍 8
  • 😁 1
Post #1016 9K
- я и постер (забыла попросить кого-то сфоткать)
- я, постер и мой бывший коллега из российского Huawei
- афтепати с коллегами после
  • ❤ 113
  • 🔥 30
  • ❤‍🔥 9
  • 👍 4
Post #1015 7.86K
Я на ICML в Сеуле, и тут на main conference аж две мои статьи, чем я очень горжусь! Но и это еще не все, еще две статьи — на MechInterp воркшопе, который будет 10 числа. И сегодня уже через пару часов буду стоять у постера одной из статей (если мне его таки распечатали))), поэтому приходите в HALL A #2606 в первую постерную сессию посмотреть на меня и помочь толпой сделать вид что статья популярна, хах

Статья: MidSteer: Optimal Affine Framework for Steering Generative Models (arxiv link)
Это — вторая моя статья по теме representation engineering, и первая попытка уйти от чисто эмпирического рукомахательного рисерча и сделать что-то более математически/теоретически обоснованное.
История такая: как я писала раньше, первой моей статьей по этой теме была CASteer — steering-метод для удаления концептов из активаций диффузионной модели. В CASteer стиринг для удаления применяется довольно наивно, без нормального теоретического обоснования, только что-то вроде "ну вот у нас есть linear representation hypothesis, поэтому логично двигать активацию в сторону анти-стиринг-вектора, и давайте подвинем именно на такой коэффициент потому что такая трансформация сохраняет норму". После того, как я доделала CASteer, мне захотелось понять, как делать стиринг для удаления более фундаментально, т.е. можно ли вывести в некотором смысле лучшее преобразование для удаления концепта из активации.

Оказалось, что для задачи удаления такое уже существует. Это статья LEACE: Perfect linear concept erasure in closed form. В ней выводится в некотором смысле лучшее линейное преобразование для удаления концепта из векторов-активаций моделей. Но применяется это в статье только для активаций, которые были получены из модели типа BERT и потом применяются для решения какой-нибудь downstream задачи классификации. То есть, метод не применяли на активациях LLM/диффузий, чтобы влиять на их генерацию.

Разобравшись с LEACE, оказалось, что обычный activation steering для удаления концептов из активаций, который делается оргононализацией активации к стиринг вектору — это просто частный случай LEACE. То есть, обычный стиринг == LEACE в предположении о том, что матрица ковариаций активаций слоя единична, и среднее активаций равно нулю. Тут у меня возник вопрос, а почему тогда в статьях по стирингу не используется LEACE. Тут два предположения: 1) для LEACE надо считать матрицу ковариации слоя, что долго и дорого 2) как писала выше, статья LEACE не тестирует метод на генеративных моделях, и, возможно, поэтому о LEACE просто мало знают те, кто стирят LLMки

Хорошо, стиринг для удаления — частный случай LEACE. Давайте теперь попробуем сделать что-то новое. Например, попробуем решить чуть другую задачу — не удаления концепта из активации, а перевода одного концепта c_1 в другой c_2 (concept switching). Например, c_1=котик, c_2=песик, и тогда цель — чтобы LLM/диффузия генерили текст/картинки с песиками вместо котиков, если в промпте при этом просят котиков. И, как и в LEACE, скажем, что преобразование должно быть линейным и в некотором смысле "оптимальным". Оптимальность в данном случае задается как "минимальное изменение вектора активации при условии изменения концепта c_1 -> c_2".

Оказывается, такое "оптимальное" линейное преобразование для concept switching можно вывести. Более того, есть даже два варианта. Первое очень просто получается из LEACE изменением коэффициента, но у него есть недостаток — при применении оно меняет c_1 <-> c_2 в обе стороны, т.е. вместо котиков вы получите песиков, и наоборот. А второе — новое, которое меняет c_1 -> c_2, но не наоборот. Вот это новое преобразование для concept switch (теорема и результаты экспериментов) и есть главное novelty статьи.

В итоге главные моменты статьи:
• Cтиринг для удаления концептов — частный случай LEACE
• Оптимальное линейное преобразование для concept switch (случай c_1 <-> c_2) — следствие LEACE
• Новая теорема и эксперименты: оптимальное линейное преобразование для concept switch (случай c_1 -> c_2) — MidSteer

Ссылки:
Статья на arxiv
Alpharxiv (тут можно поставить лайк)
GitHub (а тут звёздочку 🥺)
  • 👍 73
  • ❤ 42
  • 🔥 10
  • 👏 8
  • ❤‍🔥 1
Post #1012 8.24K
В феврале, прямо перед поездкой в Словению на межнар, приходила к Виктору Кантору на подкаст. И вот пару дней назад он наконец вышел — ссылки на посмотреть тут

Поговорили немного про рисерч, про DLS, олимпиады, и мотивацию этим всем заниматься. Возможно, говорили про что-то еще, но я этого уже не помню)
  • ❤ 42
  • 🔥 4
  • 😱 2
Post #1011 10.6K
У нас с Егором вышла новая статья про стиринг, а ну ставьте лайк на HF daily papers 😠

Вообще за последнее время у меня приняли несколько статей, и вышли ещё несколько новых статей, но никак не могу про это все написать 🫠 (отчасти потому, что работаю над этими статьями, хех)
  • ❤ 47
  • 🔥 9
  • 🎉 8
  • 👍 4
  • ❤‍🔥 1
Post #1010 9.11K

Forwarded from Aparin (Георгий Апарин)

Чаще всего стиринг активаций LLM реализуют как параллельный перенос активаций вдоль предпосчитанного вектора концепта (стиринг вектора). Такой дизайн исходит из гипотезы о локальной линейности множества активаций LLM. Но недавно вышли работы, которые критикуют такой подход, заявляя, что при линейном стиринге сильно меняется норма активации, а это выводит активацию в out-of-distribution, что ломает модель. Предлагаемая альтернатива — сферический стиринг, который сохраняет нормы активации, только поворачивая их в сторону вектора концепта на некоторый угол

Но сами гипотезы, на которых строится этот подход (что активации лежат на сфере, а норма для концепта не важна), эмпирически не проверялись. Мы с Таней решили закрыть этот пробел: построили фреймворк, объединяющий сферический и линейный стиринг в один общий класс методов, и выделили норму и угол вектора как два интерпретируемых параметра (вместо одного, неинтерпретируемого, в линейном стиринге)

Оказалось, что активации не лежат строго на сфере, а норма всё-таки важна для стабильности генерации, и опираясь на это мы предложили новый метод, совмещающий сильные стороны обоих подходов

Полный обзор написал в [телеграфе]

Если вам понравилась статья, поддержите её классом на huggingface daily papers, чтобы больше людей её увидело :)

[arxiv]
Telegraph A Geometric Account of Activation Steering through Angle-Norm Decomposition Чаще всего стиринг активаций LLM реализуют как параллельный перенос активаций вдоль предпосчитанного вектора концепта (стиринг вектора). Такой дизайн исходит из гипотезы о локальной линейности множества активаций LLM. Но недавно вышли работы, которые критикуют…
  • ❤ 33
  • 👍 10
  • 🔥 3
Post #1009 17K
В этом году позвали в программный комитет Practical ML Conf. Мы вместе с авторами @lovedeathtransformers, @boris_again, @tech_priestess и другими людьми будем отбирать доклады и делать так, чтобы программа конфы получилась интересной и качественной. Говорят, в этом году подали больше докладов, чем в прошлом, и доклады в среднем тоже круче.

Конференция будет 19 сентября 2026. А пока еще можно подать на нее доклад — дедлайн подачи уже 1 июня (включительно). Тематика такая:

Мы ждём глубокие технические доклады об ML-технологиях, которые уже сейчас приносят пользу для бизнеса.
Мы отбираем доклады, исходя из четырёх основных критериев: польза и новизна для сообщества, применимость на практике и хардовый уровень сложности.


Более подробно про подачу докладов — тут. Подавайте доклады, рассказывайте о своем рисерче/работе! (а мы ее рассмотрим 😃)

Подать доклад тут
Practical ML Conf 2026 Хардовая конференция для экспертов и практиков. Здесь будет всё о практическом применении ML: технические доклады ведущих специалистов отрасли, инженерные мастер-классы и много нетворкинга. Обсудим, как извлечь из машинного обучения реальную пользу для бизнеса.
  • ❤ 28
  • 🔥 14
  • 👍 7
  • 💩 2
  • 👎 1
Post #1008 9.22K
Нина подаётся на Yandex ML Prize как руководитель DLS. Там для заявки нужны несколько отзывов студентов, которые проходили курс. Если вы проходили DLS, вам понравилось, и вы хотите поддержать DLS, Нину и всех нас, напишите мне, пожалуйста

P.S. Вроде набрали 10 человек, спасибо вам большое 🥰
  • ❤ 91
  • 🔥 13
  • 😁 6
  • 💩 1
  • 🦄 1
Post #1007 10.4K
Так вышло, что теперь у нас не три, а четыре дня NeoAI, и сегодня тоже есть тур

Он начнется вот-вот, вот ссылка на трансляцию.
А ещё у нас есть живой лидерборд!

Туры сегодня и завтра уже не международные, поэтому на лидерборде по новым задачам будут только кандидаты в сборную

Приходите смотреть трансляцию, там будет про задачи в том числе)
  • 👏 8
  • ❤ 6
  • 🔥 3
Post #1006 10.4K
А я тем временем уже снова в Москве (точнее, в подмосковье), где завтра (3 мая) стартует NeoAI — Northern Eurasian Olympiad on Artificial Intelligence. Это AI олимпиада, которую мы проводим как основной отбор в сборную на межнар IOAI, но в этом году в ней удаленно также могут участвовать и другие страны.

Всего будет три дня контестов по три задачи (3, 4 и 6 мая). Сережа (один из тренеров) решил взять у ICPC идею и сделать трансляцию олимпиады. И будет не просто трансляция из зала, а еще разговоры с разными людьми вокруг AI соревнований: как было раньше, как есть сейчас, и куда все это катится как это все будет выглядеть в будущем

В посте Саши — спикеры на все три дня и подробные темы. А вот ссылки на прямые трансляции всех дней:
Первый тур (3 мая 10:00 - 16:00)
Второй тур (4 мая 10:00 - 16:00)
Третий тур (6 мая 10:00 - 16:00)
Telegram Жизнь и датка Серёжа решил сделать вид что мы ICPC и сделать трансляцию отбора на IOAI) заходите послушать: мы будем обсуждать межнар, участников, задачи и решения, а также позовем наших классных друзей, чтобы пообщаться про соревнования и AI. Ссылки на трансляции: Первый…
  • ❤ 36
  • 👍 10
  • 🔥 6
  • ❤‍🔥 2
  • 💩 2
  • 👏 1
Post #1005 9.11K
В DLS делают очень интересную штуку — летнюю смену по AI для школьников 8-10 классов. Это типа летний лагерь, как по олимпиадной математике/проге, но только по ИИ!

Смена пройдет 3-13 июля в экопарке «Бобровый мыс». Учеба будет довольно плотной: 4 пары в день и работа над проектом. Программа начинается с математики для ML, основ ML, CV, NLP. Участники смены будут разделены по уровню подготовки, поэтому смена подойдет как новичкам в AI, так и студентам с обширным опытом.

Организация и программа делается людьми, которые хорошо понимают в програмах и образовании по олимпиадной математике и AI. Руководитель смены — Валерия Набатова, тренер сборной Москвы по ИИ и один из менеджеров DLS.

Для участия в смене необходимо зарегистрироваться на сайте и пройти отборочный контест до 9 мая (контест доступен в течение пяти дней после регистрации, но не позже 9 мая 23:59 Мск).

Участие в смене платное, для олимпиадников предусмотрена скидка. Больше информации о смене и программе читайте на сайте:
📎 Сайт
📎 Регистрация (открыта до 9 мая 23:59 Мск)
Если остались вопросы, спрашивайте под постом DLS о смене тут
  • ❤ 26
  • 👍 4
  • 🤷‍♀ 3
  • ❤‍🔥 1
  • 🔥 1
  • 🐳 1
Post #1004 8.56K
Я сегодня наконец доехала на ICLR в Рио де Жанейро, и прямо сейчас буду презентовать свой постер! Приходите посмотреть на меня и Andreea (мою коллегу-соавтора из лондонского Huawei) в Pavilion 4 P4-#3208, если вы вдруг тоже тут)

Я так и не написала до этого момента про эту статью, давайте напишу хотя бы немного сейчас. Небольшой дисклеймер: возможно, это будет не самый связный и понятный рассказ, потому что я вообще не спала сегодняшную ночь (летела из Лондона в Рио, это 11 часов 🫠), и слова из-за этого в связные предложения складываются чуть хуже 👿

Итак, статья CASteer: Cross-Attention Steering for Controllable Concept Erasure — она о том, как перенести идеи representation engineering из LLM на диффузионки и получить довольно простой training-free метод для удаления концептов из диффузий (например, картинок с nudity, violence или copyritghted material), который при этом очень эффективный и сохраняет общее качество генераций модели.

Теперь чуть подробнее. Для начала, в чем состоит идея representation engineering из LLM. Где-то году в 2022-2023 было показано, что в LLM работает следующая идея: давайте выберем концепт (например, toxicity) и зафиксируем слой LLMки (например, слой номер 13). Возьмем несколько промптов, на которые LLM отвечает довольно токсично, и усредним активации с этого слоя на этим промпты. Получим "среднюю активацию слоя на токсичные промпты". Возьмем еще несколько промптов, на которые LLM отвечает не токсично, и тоже усредним активации с этого слоя на этим промпты. Получим "среднюю активацию слоя на обычные промпты". Потом отнимем среднюю активацию слоя на обычные промпты от средней активации слоя на токсичные промпты, и получим стиринг вектор токсичности. Это будет как бы вектор в пространстве выходов слоя, который кодирует концепт "токсичности" в модели.

А далее при inference модели мы просто будем добавлять или отнимать этот стиринг вектор токсичности от текущих активаций модели на этом выбранном слое. Таким образом мы сможем влиять на генерацию: если добавлять стиринг вектор токсичности, то генерация будет получаться более токсичной, а если отнимать, то менее токсичной.

Так вот, я в 2024 году наткнулась на эту идею, и она показалась мне довольно удивительной: идея стиринга выходов слоев — супер простая, но это действительно неплохо работает. Мне захотелось разобраться, почему же это вообще работает, и как сделать так, чтобы работало еще лучше (и, желательно, еще с теоретическим обоснованием и гарантиями). Но пока я разбиралась в этом стиринге и что там происходит с активациями при стиринге, мне захотелось попробовать этот стиринг потыкать руками, хотя бы куда-то применить. Так родилась идея попробовать адаптировать эту идею к генерации картинок диффузионками — диффузионный модели все же отличаются от LLM структурой и идеей работы, и к ним стиринг в таком виде еще никто не применял.

Собственно, CASteer — это то, что получилось из этой идеи. В статье я беру те диффузионки, которые получают информацию из текста при генерации через слои cross-attention (CA), и применяю стиринг к активациям CA слоев модели, чтобы заставить модель не генерировать определенные концепты, даже если они заданы в промпте. Кажется, что раз мы хотим запретить нейронке генерировать что-то, что есть в тексте, то как раз и нужно стирить то место в сети, которое передает инфу из текста в патчи генерируемой картинки — а это и есть CA слои. И это действительно сработало — CASteer хорошо удаляет разные концепты, не ломая при этом общие способности моделей к генерации разных картинок.

Вот так. Еще раз вот вам ссылки:
статья на arxiv
код на GitHub (очень буду рада звездочкам 🥺)

Ну и stay tuned, скоро расскажу про следующие статьи, которые уже больше про то, "почему стиринг работает, и как сделать его лучше с теоретической точки зрения"
  • ❤ 89
  • 👍 29
  • 🔥 18
  • ❤‍🔥 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →