TGViewer
Channel Public Channel
Михаил Омельченко | AI&IT

Михаил Омельченко | AI&IT

@django_school

ИИ в работе, разработка, веб. Агенты, автоматизация, инструменты. Веду я, Михаил Омельченко, внешний технический директор по ИИ и ментор.

Менторство, реклама и сотрудничество: djwoms.ru
Telegram - @DJWOMS
YouTube - https://www.youtube.com/c/DjangoSchool
Subscribers
5.19K
Photos
969
Videos
190
Links
703

Showing posts older than #2012 · Back to latest

Older Posts 16 shown
Post #2011 1K
Четыре способа сломать себе контекст

Когда агент начинает нести чушь, говорят что "модель слабая". Чаще дело в том, что накопилось у неё в контексте.

Есть разбор Дрю Бройнига (Drew Breunig), где эти вещи разложены по четырём видам. Он вышел 22 июня 2025 года и с тех пор эти четыре названия закрепились, в разборах про агентов я встречаю именно их.

1) Отравление. В контекст попала ошибка или галлюцинация, и агент дальше на неё ссылается как на факт. Пример из разбора: агент на Gemini, игравший в Pokemon, выдумал несуществующее состояние игры и дальше добивался невозможной цели.

2) Отвлечение. Контекст разросся настолько, что модель залипает на истории и перестаёт опираться на то, чему училась. Тот же агент после 100 000 токенов начал повторять свои прошлые действия вместо новых стратегий.

3) Путаница. В контексте лежит лишнее и модель всё равно тащит это в ответ. Бройниг ссылается тут на Berkeley Function-Calling Leaderboard: при большом наборе подключённых инструментов модели иногда вызывают не тот.

4) Столкновение. Новая информация противоречит тому, что уже лежало в промпте. Бройниг ссылается тут на совместную работу Microsoft и Salesforce: качество падает на 39%, когда задачу выдают по частям за несколько шагов вместо сразу целой.

Четвёртый пункт неприятнее остальных, потому что так работает обычный диалог. Вы уточняете задачу по ходу дела, а агент тащит за собой все прежние версии условия и путается между ними.

Если разговор с агентом ушёл в сторону, дописывать в него ещё одно уточнение, это чаще всего проигрышный ход. Надёжнее собрать условие заново и начать с чистого контекста, вы теряете накопленную историю, зато возвращаете себе управляемое окно.

Источник: Drew Breunig, "How Long Contexts Fail"
  • 👍 7
  • 🔥 2
  • 🎉 1
  • 💯 1
Post #2009 1.03K
Давно хотел собрать себе Джарвиса, и вчера дособирал последнее, чего не хватало, управление голосом.
  • 🔥 8
  • 👍 6
  • ❤‍🔥 3
  • 😁 2
Post #2007 1.08K
Окно на миллион токенов не отменило работу с контекстом

Окна моделей выросли до миллиона токенов и появилось ощущение, что можно складывать в контекст всё подряд, места хватит.

Давайте разберёмся, почему это не сработало.

В июле 2025 года Chroma прогнала 18 моделей на входах разной длины: Claude, GPT, Gemini, Qwen. Chroma делает базу для векторного поиска, то есть интерес в этой теме у неё большой и читать замер стоит с поправкой на это.
Вывод, модели не держат одинаковое качество на разной длине входа. Причём деградация начинается задолго до физического предела окна и идёт она неровно, провалами.

У этого есть название, context rot, гниение контекста.

Anthropic в статье про контекст инжиниринг (context engineering) называет контекст конечным ресурсом с убывающей отдачей. Объясняет через бюджет внимания: он у модели ограничен, каждый новый токен его тратит и поэтому чем длиннее контекст, тем строже приходится отбирать, что в него класть.

Поэтому большое окно не заменило работу с контекстом. Оно отодвинуло точку, где отсутствие этой работы становится заметным и подняло цену ошибки, за лишнее в окне вы платите на каждом шаге, и платите не один раз.

Источники:
1) Замер Chroma "Context Rot: How Increasing Input Tokens Impacts LLM Performance"

2) Anthropic, "Effective context engineering for AI agents"
  • ❤‍🔥 3
  • 👍 3
  • 🎉 1
  • 💯 1
Post #2006 1.21K
Открываю набор в новый сезон клуба по AI агентам. Стартуем 22 сентября.

Сезон устроен так: месяц на понимание базы (написан новый курс), дальше три месяца один общий проект на всех участников.

Первый месяц идёт без проекта, уроки курса по LangChain с дедлайнами, плюс теория на встречах. Теория отвечает на вопрос "что это такое и почему устроено именно так". Что занимает контекстное окно, откуда берётся цикл агента, чем субагент отличается от инструмента и т.д.

Со второго месяца начинается общий проект. В этом сезоне это агент археолог легаси.

Он отвечает на вопросы, которые возникают в любом незнакомом репозитории. Для этого обходит код, собирает граф зависимостей, а свой ответ проверяет запуском.
У него восемь слоёв, от обхода репозитория до оценки качества. В каждом из трёх блоков проекта вы берёте новый слой, а прежний передаёте другому участнику вместе с описанием, как он устроен и где грабли.

1. За сезон вы работает руками над трема слоями из восьми. Остальные пять видите на разборах и принимаете от коллег вместе с описанием, как они устроены.

2. Встречи по вторникам в 18:00 мск, каждую неделю. Разбор идёт вживую, поэтому сезон рассчитан на участие, а записи нужны, чтобы догнать пропущенное

3. Первый месяц идёт по курсу с дедлайнами и к началу проекта у всех есть база

Для участия нужен опыт разработки на python. Языковые модели знать не нужно.

Сезон длится с 22 сентября по 22 января, четыре месяца по четыре встречи, с пропуском недели на новогодние каникулы.

Стоимость 5 000 ₽ в месяц, оплата помесячная.
Созвоны в Телемосте, общение в Телеграм чате клуба. Беру 10-12 человек, отбор по анкете.

Анкету принимаю до 21 сентября, потом закрываю набор. Присылайте мне в личку, @DJWOMS.

Анкета:
1. Что вы уже умеете и на чём пишете: язык, фреймворки, сколько лет в разработке, работали ли с языковыми моделями и агентами.
2. Чего вы ждёте от клуба, своими словами
3. Чему конкретно хотите научиться за эти четыре месяца. Чем конкретнее ответ, тем точнее я распределю участников по проекту
4. Сможете ли участвовать по вторникам в 18:00 мск: да, нет, или могу не всегда, поясню

Если сомневаетесь, подходит ли вам, тоже напишите.
  • 🔥 6
  • 👍 2
  • 😁 1
  • 🤔 1
  • 🎉 1
  • 💯 1
Post #2002 1.36K

Forwarded from AI для каждого | AISferaic

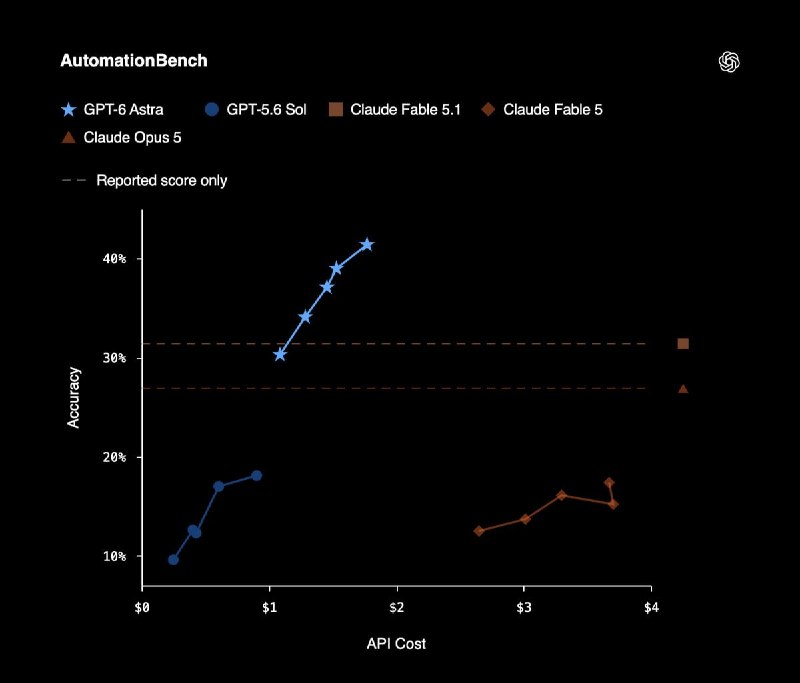
OpenAI представила GPT-6 Astra новый флагман, который, судя по первым цифрам, совершил серьезный скачок относительно прошлого поколения.

По бенчмаркам Astra демонстрирует впечатляющее превосходство: в Terminal-Bench 4.0 она набрала 57,7%, обойдя Fable 5.1 и значительно опередив GPT-5.6 Sol. В научных задачах Terminal-Bench Science отрыв еще заметнее 64,6% против 52,6% у ближайшего конкурента, а в тестах ARC-AGI-3 и ExploitBench модель показала практически абсолютный результат.

Стоимость в API составит 10 за миллион входных и 50 за миллион выходных токенов, а для тех, кому важна скорость, доступен режим Fast mode, работающий в 2,5 раза быстрее при двойном тарифе. Пока Astra доступна лишь ограниченному числу организаций, но в ближайшие дни OpenAI обещает открыть доступ всем платным пользователям.

Теперь остается дождаться массового релиза и первых независимых тестов.
  • 🔥 8
  • 👍 2
  • 🎉 2
Post #2001 1.4K

Forwarded from AI для каждого | AISferaic

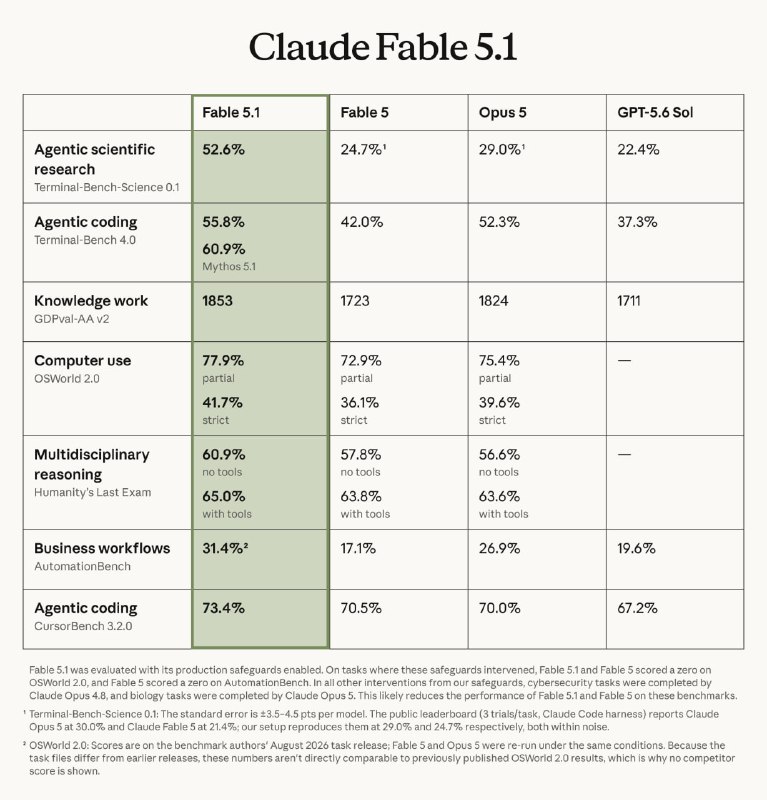
Anthropic выкатила Claude Fable 5.1 и Mythos 5.1.

Fable 5.1, это новый флагман для всех пользователей. Mythos 5.1, это та же модель с ослабленными ограничениями по кибербезопасности и биологии, доступная только проверенным организациям.

По бенчмаркам апдейт заметный:

- Terminal-Bench 4.0: 55,8%, у Mythos 60,9%
- Terminal-Bench-Science: 52,6% против 24,7% у прошлой версии
- Humanity's Last Exam: 60,9% без инструментов и 65% с ними
- OSWorld 2.0: 77,9%

Цена прежняя, $10/$50 за миллион токенов, зато чтение кэша подешевело на 75%, до $0,25 за миллион. По оценке Anthropic, это снижает расходы примерно на 25% в обычных сценариях и до 45% в агентных.

На Low/Medium effort Fable 5.1 уже может выдавать результат уровня Fable 5 дешевле. В Claude Code по умолчанию High, в Cowork и claude.ai Medium.

Фильтры кибербезопасности срабатывают примерно на 60% реже, а модель разрешили использовать для поиска уязвимостей, но не для написания эксплойтов.

https://www.anthropic.com/claude-fable-and-mythos-5-1
  • 🔥 5
  • 😁 1
  • 🎉 1
  • 💯 1
Post #2000 1.4K
Многие уверены, если купить команде доступ к нейросети, дальше люди сами разберутся и начнут работать быстрее. А через месяц оказывается, что всё идёт по-старому. Почему так выходит?

В новом выпуске подкаста я снова поговорил с основателями школы Стратоплан, Александром Орловым и Вячеславом Панкратовым. Те же, с кем в июле разбирали уход из кода в менеджмент.

Разобрали, почему инструмент, за который заплатили, лежит без дела.

Заодно поговорили про то, что делать, когда сотрудник говорит, что с нейросетью работает медленнее. Это саботаж или он говорит правду, и как это проверить не на одном человеке, а на контрольной группе.

А ещё обсудили, можно ли требовать использовать нейросеть так же, как требуют соблюдать регламент. Где заканчивается управление и начинается слежка, если переписку команды обрабатывать нейронкой.

Разговор получился про то, с чем возможно столкнётесь, когда принесёте нейросеть команде.

👉 Смотреть на YouTube

👉 Смотреть на Rutube

А у вас инструмент прижился или лежит купленным?
  • 👍 15
  • 🔥 10
  • 🎉 4
  • 💯 2
  • 😁 1
Post #1999 1.73K

Forwarded from AI для каждого | AISferaic

На GitHub набирает популярность Godogen проект с открытым исходным кодом, который фактически автоматизирует создание полноценных игр. Репозиторий уже собрал более 5 тысяч звезд.

Система берет на себя весь цикл производства: от проработки архитектуры и создания ресурсов до написания кода и запуска движка. Уникальность Godogen заключается в собственном цикле контроля качества, ИИ сам делает скриншоты запущенной игры, анализирует визуальные ошибки и тут же пытается их исправить.

Инструмент поддерживает движки Godot 4, Bevy и Babylon.js, работая на базе Claude Code или Codex. Внутри него зашиты справочники и документация для 850+ классов GDScript, которые подгружаются по мере необходимости. При этом весь процесс генерации можно запускать прямо на обычном домашнем компьютере.
  • 👍 8
  • 🔥 3
  • 😁 2
  • 🎉 2
  • 💯 1
Post #1998 1.53K
Ко мне пришёл фаундер строительной компании, для понимания возможностей нейросетей и их применения в жизни и бизнесе.

За четыре занятия разобрали, как модель выдаёт ответ: что такое контекстное окно и токены, откуда берутся выдуманные факты, почему модель соглашается с собеседником. Как ресерчить, как сделать память, где можно встроить ее в бизнес и как. Отдельно разобрали персональные данные и что в модель не отправляют.
Дальше работали на его задаче, он получил план с цифрами. Там же проверили эти цифры и увидели, что два прогона одного запроса дают разные суммы и где модель может ошибаться.

Его слова: "Многие вещи, о которых раньше имел только общее представление, стали гораздо понятнее, а главное, появилось понимание, как ИИ уже сегодня можно использовать в реальных задачах".

Формат: занятия по часу и переписка между ними. Подходит руководителю, который решает, что делать с ИИ у себя в компании.

Написать мне: @DJWOMS
  • 🔥 10
  • 👍 2
  • 😁 1
  • 💯 1
Post #1996 1.37K

Forwarded from AI для каждого | AISferaic

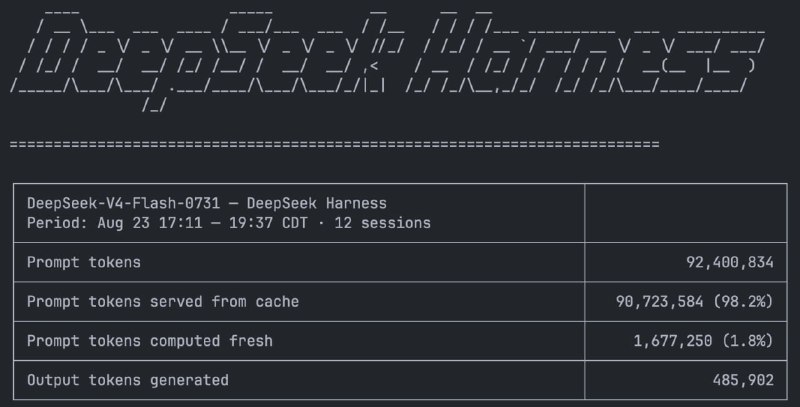
DeepSeek Harness демонстрирует впечатляющие результаты в реальной работе.

После тестирования самостоятельно развернутой версии DeepSeek V4 Flash 0731 главным преимуществом стал показатель попадания в кэш на уровне 98,2%.

Такая высокая эффективность позволяет системе крайне экономно расходовать токены, что критично для масштабных задач.

Проект вызывает огромный интерес у сообщества GitHub-репозиторий набрал более 188 тысяч звезд менее чем за две недели.
  • 👍 6
  • 🔥 6
  • 🤔 3
  • 🎉 1
  • 💯 1
Post #1995 1.59K
Месяц назад ко мне пришла помощница фаундера строительной компании по его рекомендации. Не разработчик, использует ChatGPT каждый день для писем и т.д.

Месяц пошёл на процедуру работы с моделью, которая переносится в любую работу. Из чего состоит запрос, почему модель забывает то, что было выше, как забрать результат файлом.

Сама между третьим и четвёртым занятием, за один день, она собрала себе ассистента с четырьмя функциями и протестировала две на своих задачах.

Формат: 4 занятия по часу за месяц и переписка между занятиями. Подходит вам, если у вас есть повторяющаяся задача, вы не разработчик и отдать её разработчику нельзя.

Пишите мне: @DJWOMS
  • 🔥 10
  • 👍 2
  • 😁 1
  • 💯 1
Post #1994 1.42K

Forwarded from AI для каждого | AISferaic

Qwen3.8-27B теперь выдает честные 70 токенов/с прямо на ноутбуке благодаря выходу DFlash 2.

Это новое поколение спекулятивного декодирования, основанное на методе блочной диффузии.

Технология разгоняет модель на MacBook Pro с чипом M5 Max, увеличивая скорость авторегрессионного декодирования до 4,6 раза. При этом итоговый результат остается на 100% идентичным оригиналу качество вывода не страдает ни на один токен. ⚡️

Новые черновые модели для Qwen3.8-27B уже доступны с нативной поддержкой популярных движков SGLang, vLLM, llama.cpp и oMLX. Подробный разбор подхода и того, как это работает, можно найти здесь
  • 👍 10
  • ❤‍🔥 3
  • 💯 3
Post #1993 1.22K

Forwarded from AI для каждого | AISferaic

Anthropic продлила действие повышенных лимитов для Claude Code.

Изначально недельные лимиты были увеличены на 50% в качестве временной акции до 19 августа, однако теперь этот период продлен до 31 августа.

В компании надеются сделать данные условия постоянными для всех тарифов. Однако разработчики предупреждают, что из-за аномально высокого спроса на модели в ближайшие недели мощностей может не хватить, поэтому окончательное решение будет зависеть от стабильности системы.
  • 🔥 5
  • 😁 2
  • 🎉 1
  • 💯 1
Post #1992 1.19K

Forwarded from AI для каждого | AISferaic

Anthropic уже завершила обучение Mythos 2.

Однако не спешит выводить модель на рынок. Об этом в свежем подкасте сообщил основатель SemiAnalysis Дилан Патель, ссылаясь на свои источники.

Более того, по информации Пателя, компания уже вовсю использует мощности Mythos 2 для обучения и доработки следующего поколения нейросети Mythos 3.

Такая стратегия внутренней итерации может означать подготовку к мощному технологическому скачку, но точные сроки публичных релизов пока остаются неизвестными.
  • 👍 4
  • ❤‍🔥 3
  • 🤔 2
  • 🎉 1
  • 💯 1
Post #1991 1.29K

Forwarded from AI для каждого | AISferaic

Anthropic опубликовала подробное руководство по эффективной работе с Claude Code.

В гайде собраны шесть ключевых рекомендаций, которые помогут оптимизировать процесс разработки и сэкономить токены.

Разработчики советуют использовать /clear при переходе к новым задачам, заранее определять модель и уровень усилий, а также точечно указывать файлы через символ @. Для чистоты контекста рекомендуется подавлять лишний вывод команд флагами, проверять текущий объем данных через /context и не забывать про команду /compact перед длительными перерывами в работе.

Эти советы универсальны и будут одинаково полезны при использовании Codex или любого другого продвинутого ИИ-агента для программирования.
  • 👍 10
  • ❤‍🔥 1
  • 🎉 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →