TGViewer
Channel Public Channel
C# Short Posts 🔞

C# Short Posts 🔞

@dimasshortposts

Здесь я, Дима Афонченко @Undermove1, публикую короткие заметки о разработке (и около). Я не претендую на правильность высказываний и открыт к дискуссиям, исправлениям и конструктивной критике. С любыми деструктивными вещами можно приходить в комменты)
Subscribers
306
Photos
206
Videos
7
Links
211

Showing posts older than #479 · Back to latest

Older Posts 15 shown
Post #478 497
🔎 У HTTP появился новый метод QUERY

Двадцать лет индустрия пытается ответить на главный вопрос жизни, вселенной и всего такого. А именно: как посылать сложные запросы?

Потому что если посылать GET, то у него есть ограничения по длине. К примеру Nginx по умолчанию рубит строку запроса на 8 КБ. Плюс тело у GET семантически не определено: ты можешь его положить, но его по дороге могут не передать.

Двадцать лет индустрия отвечала на этот вопрос: 4️⃣ 2️⃣

И вот наконец в этом году стала отвечать 6️⃣7️⃣

Ладно, это все шутки. На самом деле предлагалось взять метод POST, который создан совсем для другого, и заворачивать все в него, и в общем это так и работает.

Минусы у этого подхода вот такие. POST по своей сути не идемпотентный. Словил таймаут, повторить не можешь (ну если следовать правилам): вдруг оно там уже что-то создало. Закэшировать тоже нельзя. На редиректе метод может схлопнуться в GET вместе с телом. Ну и в логах с трейсами твой поиск по каталогу выглядит как запись в БД.

📬 Но! НО! буквально на днях мы дожили. В июне 2026 приняли RFC 10008, и стал доступен новый метод: QUERY. Тело как у POST, семантика как у GET. Идемпотентный и кэшируемый.

Вообще, для меня это шок. Я вообще такого, мне кажется, никогда не видел. Может, я просто не следил и новые методы появляются постоянно? Не знаю, но я вижу это в первый раз. И это прикольно.

Теперь про дотнет. Десятка метод уже поддерживает: HttpMethod.Query на клиенте, HttpMethods.Query и IsQuery() на сервере, Kestrel умеет его парсить.

На пояснительно дикпике можно ознакомиться с тем, как выглядит все это на посылку и на прием 🍆

Пока что MapQuery() для minimal API и [HttpQuery] для контроллеров недоступны, обещают вернуться в .NET 11-й. Но мне кажется что не проблема написать свой экстеншен метод, если будет нужно.

Это все круто, но как вы понимаете в этой бочке дёгтя все вышеперечисленной было лишь чайной ложечкой мёда.

🔞 Использовать не получится еще лет 20: не все маршрутизаторы, устройства, вафы и прочие промежуточные узлы умеют правильно понимать QUERY. Незнакомый метод обычно скорее всего закэнселят по по allowlist'у.

Но кое-что можно придумать:

1️⃣ Во-первых, можно делать фоллбэк на обычный стандартный POST: не получилось QUERY, ловишь 405 или сетевую ошибку и повторяешь POST'ом на тот же эндпоинт. Собрал демку, где это видно вживую: тумблер включает злой прокси, тот режет QUERY, фронт молча уезжает на POST.

2️⃣ Во-вторых, если хочется общаться между сервисами, то QUERY можно брать уже сейчас: там вы контролируете среду выполнения целиком. Так что в межсервисных взаимодействиях ни в чем себе не отказывайте. Если вы, конечно, еще отказываете.

Есть идейка попробовать реализовать схемку с фоллбэком на рабочем проекте: сначала QUERY, не получилось, фоллбэк на POST. А потом посмотреть статистику, сколько запросов реально проходит с QUERY, а сколько нет.

Но это если будет свободное время, а его, скорее всего, не будет. 🍾 Но вдруг кто-то поставит такой эксперимент, было бы очень интересно посмотреть на цифры.

Кстати, у нас есть технопосиделка и для нее я быстренько навайбкодил презу про QUERY. Делюсь с вами. Вдруг удобнее пролистать всё это слайдами.

👋 Ну и заделитесь постом с коллегами, мне кажется что среди дотнетных каналов мало как-то уделено времени столь легендарному событию!

#csharp #dotnet #http
  • 👍 2
  • 🔥 1
  • 💘 1
Post #475 375
Почти всё лето мы с тобой изучали внутрянку БД на примере #postgresql: от индексов мы спустились по Б+-деревьям до work mem и узнали насколько глубока восьмиикилобайтовая страница 📄

Теперь поплывём дальше 🛳
На нашей steam state machine мы пойдём по бурным рабочим потокам (worker thread), воочию увидим их освобождение на асинхронном водопаде, который приведёт нас к бескрайнему озеру памяти 🫡
Там мы увидим, как различные объекты сбились в несколько поколений кучи (heap), сдерживаемой лишь DOTNET_GCHeapHardLimitPercent. Некоторые из них довольно глубоко пустили корни, так что финализировать их приходится в несколько проходов, а некоторые оказались настолько холодными, что образовали свои айсберги Frozen object heap 🧊
В концов концов мы увидим, как, параллельно с другими, наша программа последовательно впадает в океан ЦПУ🤩 и выполняет своё предназначение в этом круговороте исполнения, печатая у тебя на экране заветные слова:

Hello, world!

По крайней мере таков горизонт нашего планирования, к которому мы стремимся 🌅
Возможно шторма жизни и обратной связи изменят наш с тобой курс, но мы всё равно будем стремиться к общей цели: лучше узнать платформу, на которой работаем 🗼и прочие #инженерныештучки

🧑‍💻dp🥁
Это #heavywednesday, мои чюваки
  • ❤ 2
Post #473 507
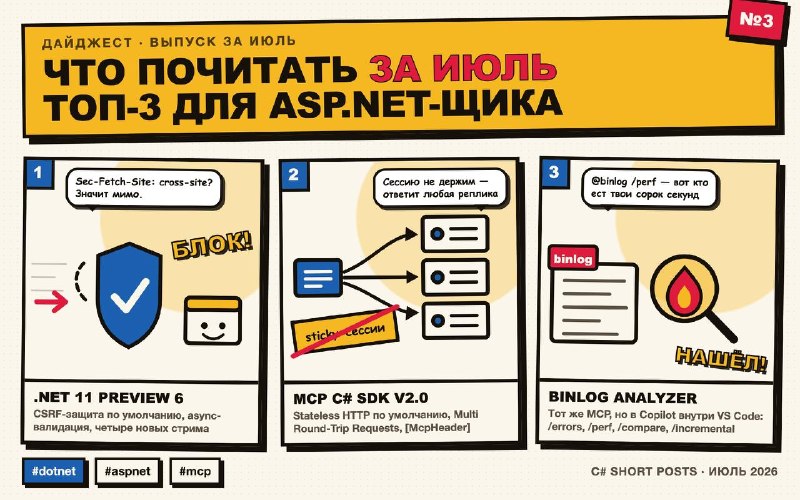
🗞 Что почитать за июль — мой топ-3 для ASP.NET-щика

Возвращаюсь к нерегулярной рубрике (в мае был такой же топ за апрель). Как и всегда июль вышел с перекосом в AI-инструменты для дотнетчика, но и обычного бэкендерского добра завезли.

1️⃣ Много хайпа вокруг .NET 11 Preview 6. Там много чего завезли, но лично мне нравятся вот эти штуки:

🟢 CSRF-защита теперь работает по умолчанию. Приложение теперь само отбивает небезопасные кросс-origin запросы, глядя на заголовки Sec-Fetch-Site и Origin. Никаких токенов и никакой конфигурации. Завезли в minimal API, MVC, Razor Pages и Blazor. Отключается через .DisableAntiforgery() на эндпоинте или ключом DisableCsrfProtection на всё приложение. Это довольно круто, так как раньше можно было и не знать, что такую штуку надо включать.

🟢 Асинхронная валидация наконец нормальная: приехали AsyncValidationAttribute и IAsyncValidatableObject, и Microsoft.Extensions.Validation умеет их гонять при валидации запроса. То есть «проверь, не занят ли этот email» пишется своим атрибутом, который спокойно дёргает сервис через DI и await. Это полный топчик! 🔝 Так как раньше приходилось чутка изголяться.

🟢 Union-типы. Про них я уже говорил в прошлый раз. Но я по чатикам вижу, что народ прям обсуждает. Кто-то не понимает для чего оно, а кто-то наоборот люто хайпит. Мне оно скорее средне.

🟢 Четыре новых стрима: ReadOnlyMemoryStream, WritableMemoryStream, ReadOnlySequenceStream и StringStream. Это вот тоже неплохо. Мне вот особенно инетересен StringStream в контексте работы с текстами Базы Знаний.

2️⃣ MCP C# SDK v2.0

Главное — HTTP-транспорт стал stateless по умолчанию. Раньше сессия жила в памяти конкретного инстанса, значит нужны sticky-сессии или общее хранилище. Теперь сервер масштабируется горизонтально как обычный стейтлес-сервис.

Чтобы не потерять интерактивные сценарии, придумали Multi Round-Trip Requests: сервер не дёргает клиента по живой сессии, а возвращает InputRequiredResult с непрозрачным блобом состояния, и клиент переспрашивает тем же вызовом уже с ответами. Плюс появился [McpHeader] — параметр можно поднять в HTTP-заголовок, чтобы балансировщик роутил по нему, не заглядывая в тело запроса.

С первой версией обе стороны договариваются, ломается только расширение Tasks — его перепроектировали.

3️⃣ Binlog Analyzer прямо в VS Code

Это прикольная штука. Я потыкал в июне Binlog MCP Server, чтобы попробовать оптимизнуть билд проекта на работе. Но к сожалению ничего драматически крутого агент с помощью MCP не нашел. Предложил кэшировать пакеты, что у нас и так было сделано. И был таков. Но у нас не очень сложный билд, так что может просто не подошло по применению. Однако для сложных билдов самое то.

Теперь вот и Copilot в VS Code будет уметь в аналитику

🅰️ Итого: Вообще мне видится, что вот эта CSRF-защита по умолчанию делается в первую очередь для агентов. Чтобы те не могли забыть ее включить и тем самым не подставили начинающего вайб-кодера.

В целом эта вся агентная история сместила фокус с “разраб сам должен думать головой” в сторону “а давайте сразу за него подумаем о базовой безопасности”

И мне кажется это круто! Потому что надеяться на дисциплину — это всегда самая идиотская тактика из всех. Что на дорогах, что в разработке.

А у вас в июле что зашло? Кидайте в комменты, если я что-то важное проспал.

#dotnet #aspnet #mcp #digest
  • ❤ 2
  • 🔥 2
  • 🐳 1
Post #471 450
🩺 Диагностика — как понять, на что ушла оперативка (часть 2, work_mem наносит ответный удар)

👈 Часть инструментов рассмотрели в прошлом посте, а в этом рассмотрим ещё парочку:

🧰 Что лежит в кэше прямо сейчас

Расширение pg_buffercache (мы его уже видели в посте про shared_buffers) показывает поимённо, какие страницы заняли кэш Postgres в данный момент. Удобно, когда надо понять, чем именно забиты те самые 128 MB, выданные под shared_buffers

👥 Кто сейчас активен (дикпик 3)
Кроме shared_buffers можно проверить и work_mem, чтобы узнать, сколько соединений работает и что они выполняют. Это показывает представление pg_stat_activity: оно построчно показывает каждое соединение, и там видно текущий запрос от клиента (app) и его состояние. Дальше пользуемся арифметикой work_mem × число операций × число активных соединений, чтобы получить объём памяти, занятый данными для операций

Чтобы при этом явно понять, какой клиент выполняет запрос, важно передавать его читаемое название через строку подключения или в запросе, тогда его название отобразится в app 🧠

⚠️ Ловушка при подсчёте памяти процессов
Если помнишь, каждое соединение в Postgres обслуживает отдельный процесс. Казалось бы, сложи память всех процессов и получишь общий расход. Но есть подвох: shared_buffers общий, и операционная система засчитывает его в память каждого процесса. Этот объём называют RSS (resident set size — объём оперативки, занятый процессом). Если просто сложить RSS всех бэкендов, общий shared_buffers посчитается много раз, и итог окажется сильно завышенным. Для суммирования правильнее брать PSS (proportional set size): он делит общую память поровну между процессами, которые ею пользуются

🧯 Если work_mem чересчур раздут
Если арифметика подтвердит, что в основном память выделена под обработку запросов, рецепт простой: уменьшить work_mem, сократить число соединений, или поставить перед базой пулер соединений. Пулер (например, PgBouncer) — это прослойка, которая держит небольшой набор постоянных соединений к Postgres и раздаёт их клиентам, что позволяет избежать выделение процесса на подключение каждого клиента. А отдельному тяжёлому запросу можно задать work_mem прямо в нём командой SET LOCAL (она меняет параметр в пределах текущей транзакции).

🅰️ Что унести с собой
🟢 Состав кэша показывает pg_buffercache. Кто сейчас активен, видно в pg_stat_activity
🟢 Складывать RSS процессов не стоит: общий shared_buffers задвоится. Для суммы есть PSS

🧑‍💻dp🥁
#бд #postgresql #инженерныештучки #heavywednesday
  • ❤ 2
  • 🤝 1
Post #470 356
🍁 Уже этой осенью я буду выступать на DotNEXT 2026!

Мне нравится .NET, AI и рассказывать доклады. И что может быть лучше чем рассказать доклад про AI в .NET?

Агенты — это относительно новая штука, и мы привыкли пользоваться ими в разработке. Но вот как писать своих агентов и главное зачем? Об этом особо никто не говорит.

Так что в этом году буду рассказывать с большого экрана про Microsoft Agent Framework и про то, как именно мы его применяем у себя в повседневных задачах.

Поэтому переходите на сайт конфы, изучайте программу и до встречи на площадке!
А за билетами по специальным спикерским условиям — всегда можно прийти ко мне в личку @Undermove1 😌
  • ❤‍🔥 6
  • 🔥 2
  • 🐳 1
Post #469 403
🤩 Пятничное.

Начал тут читать “Войну и Мир”

Был значительно ошарашен (в ахуе) от того, сколкьо персонажей можно ввести за раз.

В первой главе аж 9 основных. Ну и там еще около 10 второстепенных перечисляется.

Сначала чутка фрустировал. Потом пытался вести конспект. А потом вдург вспомнил, что сейчас же есть клодчанский!

Попросил его накидать по-быстрому доску-расследование, как в Alan Wake 2.

Типа я читаю главу, а потом могу посмотреть, кто и что в ней делал, какие у кого были мотивы + по каждому персонажу могу посмотреть короткую сводку – как выглядит, чем знаменит, и чего хочет.

По ходу прочтения буду расширять. Так что можете следить за моим прогрессом)))

Кстати, в виде аудиокниги слушать значительно проще. На x2 все вот эти затянутые описания люстр воспринимаются сильно полегче.

И бля, из приколов, там в самом начале мужика сравнивают, то с куском говядины, то с ростбифом, то еще с какой-то кулинарией. Я б такое читать устал. А на x2 это ощущается так, как и задумывалось автором – как ирония. Так что даже есть где посмеяться.

А, ну и французские вставки там сразу переведены на русский. Так что не приходится скакать глазами между ебучими сносками.

#ai #devlife #petproject
  • 👏 5
  • 🔥 1
Post #468 338
⚡️ Еще быстрый факт про серверный MCP сервер

Сегодня поймали еще одну проблемку-дилемку, которую можно было бы добавить в TOP-11 вопросов которые возникли при проектировании MCP:

⚠️ Не очень удобно через серверный MCP отправлять файлы.

Дело в том, что по сути есть два пути как передать файл.

1️⃣ Inline base64 прям в Body запроса.

2️⃣ Передать ссылку на точку где лежит ресурс и загрузить самому на сервере.

Путь 1 проще, но упирается в разнообразные лимиты сервера – body size и прочее.

Путь 2 замороченнее для клиента, так как ему нужно сначала закгрузить куда-то на отдельный сервер файл, и только потом уже передать его нам, чтобы мы могли его прикопать.

С локальным MCP появляется третий путь: клиент передаёт в тул просто путь к файлу, а сервер сам читает его с диска и стримит нам обычным multipart-запросом — хоть 500 MB, никакого base64 и лимитов на body.

🅰️ Итого: при проектировании MCP и выборе между серверным и клиентским вариантами, хорошо бы подумать о том, как вы будете пересылать вот такие крупные куски.

PS: Есть еще такой прикол. Что если модельке дать возможность пихнуть инлайновый base64, то нужно как-то ей говорить, чтобы она его руками не генерила. Нейронки конечно сейчас умные, но не факт, что клиент использует самую умную и есть риск наткнуться на то, что при передаче картинки в 1Мб моделька внезапно сожрет пол-ляма дорогущих выходных токенов. Что есть полная жесть. Но тут непонятно, мы как поставщик MCP об этом должны заботиться или сам пользователь?

Со своей стороны мы дескрипшен добавили, чтобы такого не случилось.

#mcp #ai #agents #devtools
Telegram C# Short Posts 🔞 🔤🔤 Мы сделали свое MCP для базы знаний. Наш топ-11 граблей и инсайтов на этом пути Такс, это (реализация MCP) было довольно интересно. Много что есть рассказать, но попробую тут кратко пробежаться по основным инсайтам. ⡈⢂⢨⠪⠪⠬ ⡡⡒⠴⠣⢒⠨⠖ ⢁⡐⢄⠜⢉⠘ ⠙⢡⢂ ⠦⡔⢃⠜⢐⢌ ⠜…
  • 💯 2
  • 🤝 2
  • 🤔 1
Post #464 342
🩺 Диагностика — как понять, на что ушла оперативка (часть 1)

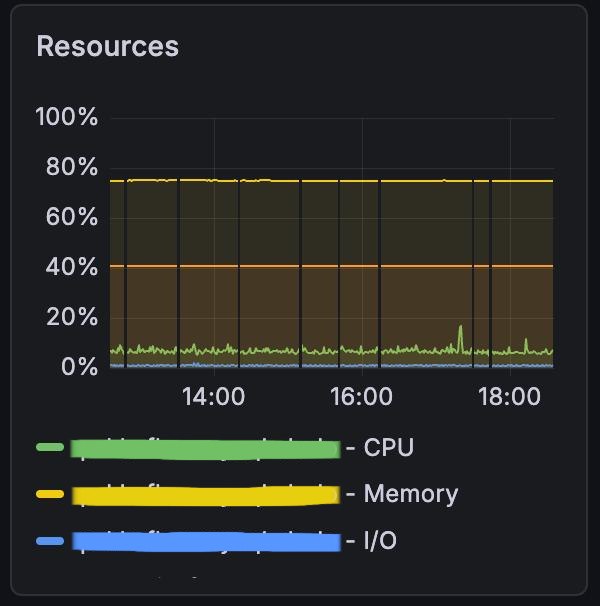
Мы с тобой разобрались с shared_buffers, кэш ОС и work_mem. Теперь можем понять, если на сервере память забита под завязку (как на дикпике из графаны), проблема это или норма, и куда смотреть в первую очередь 👀

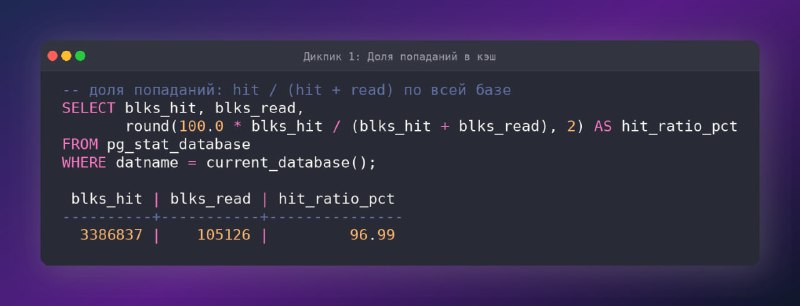
📊 Доля попаданий в кэш (дикпик 1)
Первый вопрос — насколько хорошо данные ложатся в память. По каждой базе Postgres в pg_stat_database (системное представление, содержащее накопленную статистику по каждой базе данных в кластере) содержит два счётчика: blks_hit (сколько страниц нашлись прямо в shared_buffers) и blks_read (сколько пришлось дочитывать мимо него). Их отношение hit / (hit + read) называют долей попаданий в кэш (по-английски cache hit ratio) 🔖

На прогретой базе эта доля стремится к 99% и выше. У меня после прогрева вышло около 97.84%, а сразу после рестарта она была заметно ниже, потому что кэш ещё пустой.

Если доля стабильно низкая, это сигнал: рабочий набор (та часть данных, к которой реально обращаются запросы) не помещается в память, либо запросы идут мимо индексов и вычитывают всё подряд 📖

🔎 Разрез по таблицам и индексам (дикпик 2)
Одно общее число по базе мало о чём говорит. Чтобы понять, что конкретно не попадает в кэш, есть два представления: pg_statio_user_tables (счётчики чтений и попаданий по каждой таблице) и pg_statio_user_indexes (то же самое по каждому индексу). В нём сразу видно, какая таблица или какой индекс постоянно бегает на диск 💽

🅰️ Что унести с собой
🟢 Доля попаданий из pg_stat_database показывает, помещаются ли данные в память. Если она стабильно низкая, это повод разбираться
🟢 Представление о таблицах и индексах в кэше дают... представления pg_statio_user_tables и pg_statio_user_indexes

Ещё пару инструментов рассмотрим в следующем посте 👉

🧑‍💻dp🥁
#бд #postgresql #инженерныештучки #heavywednesday
  • ❤ 2
  • 🔥 1
  • 🐳 1
Post #463 469
🔤🔤 Мы сделали свое MCP для базы знаний. Наш топ-11 граблей и инсайтов на этом пути

Такс, это (реализация MCP) было довольно интересно. Много что есть рассказать, но попробую тут кратко пробежаться по основным инсайтам. Почему топ-11? Потому что больше я вспомнить не смог 👋

1. Есть два вида MCP которые вы можете реализовать: серверный и клиентский.

2. Самый незапарный вариант сделать клиентский MCP это написать прилку на TypeScript. Клод и прочие такое генрят на раз-два.

3. Клиентский вариант удобен, если вам нужно реализовать какую-то сложную авторизацию. К примеру в некоторых флоу нужно поднимать локальный сервер, чтобы принимать редиректы.

4. Клиентский вариант неудобен тем, что его нужно куда-то выложить и отдельно обновлять, если выходят новые функции на бэке. То есть вам нужно будет к примеру написать код эндпоинта который можно дергать, а потом код самого MCP подправить. Короче, как в классическом фронт-бэк взаимодействии.

5. Серверный вариант удобен в большинстве случаев. Главное, чтобы ваши безнес кейсы соответствовали подходящему флоу авторизации.

6. Для реализации серверного MCP использовали ModelContextProtocol.AspNetCore

7. Авторизация для нас стала самой тугой частью. И мы открыли ДВА сценария ИСПОЛЬЗОВАНИЯ MCP, о которых нужно было подумать: клиентский и серверный. Клиентский – это когда у вас пользователь MCP сидит за компом и может пройти все консент-скрины и прочую мудистику. Cерверный – это когда ваш клиент написал прилку на основе вашего MCP и там уже не получится давать права всякими кликами мыши в браузере.

8. Мы в итоге забили и написали простой советский, который есть у каждого… Personal Access Token

9. Забыли дать MCP тулзу которая позволяет получить пользователю самого себя. Без этого к примеру поиск “Дай мне все мои статьи” превращается из одного запроса в тысячу и выжирает пользователю токены, потому что агент качает и грепает.

10. Нужно будет подумать о том, как нам отдавать агентам большие статьи, потому что они порой могут ухуячить лимиты. Типа все идет ок. А потом агент выкачивает новостной дайджест, который ведется чуть ли не от начала времен и весит под мегабайт. Но пока вроде это ок работает. Может быть будем выдавать агенту вместе со статьей какой-то параметр типа длины и просить его не вкачивать такое себе полностью в контекст. В общем подумаем еще, что можно делать

11. Сам MCP у нас получился легковесный занял всего около 927 токенов. Для сравнения MCP гитхаба 6 000 токенов. За этим показателем стоит следить, примерно как за размером своего приложения.

Вот такие вот инсайты. Написал чуть сумбурно может быть. Но очень хотелось все это не забыть)

#mcp #ai #agents #devtools
  • 👍 5
  • 🔥 3
Post #461 441
🌟 work_mem — тихий пожиратель оперативки

shared_buffers и кэш ОС памяти занимают немало, но ведут себя спокойно и предсказуемо. А вот из-за work_mem бывает что оперативка «внезапно» улетает в потолок 📈

🤔 Что это
Запросы к БД могут быть простыми, состоящими из одного шага (операции): достань одно поле по такому-то идентификатору. А могут быть сложными, из нескольких операций: достань данные из разных таблиц, отсортируй, сгруппируй, выдай сумму.

Некоторым операциям внутри запроса нужна рабочая память: место, чтобы разложить промежуточные данные. Чаще всего это сортировка (ORDER BY, построение индекса) и хеш-операции (соединение таблиц через хеш, группировка).

work_mem — это параметр, который можно задать как на уровней всей СУБД, так и в рамках запроса. Он указывает, сколько оперативки одна такая операция имеет право взять, прежде чем начнёт сбрасывать промежуточные данные на диск. По умолчанию лимит очень скромный — 4 MB.

🔬 Пощупаем
Берём таблицу users на миллион строк и сортируем по email (дикпик 1)

При work_mem = 4MB сортировка в лимит не влезает, и Postgres досортировывает её через диск. В плане запроса (его показывает команда EXPLAIN) это видно по строке Sort Method: external merge Disk — «внешняя сортировка слиянием»: данные бьются на куски, частично уходят во временные файлы и потом сливаются.

Поднимаем work_mem до 256MB и повторяем ту же сортировку. Теперь она целиком умещается в памяти: Sort Method: quicksort Memory, и рядом её размер — около 71 MB. И это на одну операцию!🤯

⚠️ Где подвох
К БД может быть открыто несколько подключений, если используется пул подключений, например, или несколько клиентов. Каждое подключение к Postgres обслуживается отдельным процессом операционной системы, его называют бэкендом. Если у тебя сто подключений, значит на сервере с БД работает сто процессов. По каждому из этих подключений могут одновременно прийти сложные запросы, и все эти запросы будут выполняться параллельно. В каждом таком запросе несколько операций.

И теперь главная мысль:
⚠️work_mem выделяется на каждую операцию ⚠️

Не на запрос целиком и не на весь сервер. То есть свой лимит у каждой сортировки и у каждой группировки⚡️

Дальше простая арифметика беды: work_mem × число операций × число соединений. Если щедро выставить 256 MB и открыть пару сотен активных соединений с тяжёлыми запросами, то десятки гигабайт оперативки тут же растворятся😯

🧪 Важная оговорка
Объём work_mem не резервируется заранее. Память берётся только тогда, когда она понадобилась для выполнения операции, и ровно столько, сколько нужно (но не больше лимита). Так что «256 MB × 200 соединений = сразу отожрёт 51 GB» — это не совсем так. Столько наберётся, только если все разом запустят достаточно тяжёлые операции🤩

И ещё тонкость: для хеш-операций по умолчанию работает множитель hash_mem_multiplier, равный 2. То есть хеш имеет право взять не work_mem, а вдвое больше, потому что хеш-таблица в памяти прожорливее сортировки⚠️

🅰️ Что унести с собой
🟢 work_mem — это лимит рабочей памяти на одну сортировку или хеш-операцию, по умолчанию 4 MB
🟢 Если лимита не хватает, операция досчитывается через диск и работает медленнее
🟢 Реальный расход — это work_mem × число операций × число соединений, поэтому слишком большой work_mem легко съедает гигабайты оперативки
🟢 Память не резервируется заранее, а хеши по умолчанию берут вдвое больше из-за hash_mem_multiplier

🧑‍💻dp🥁
#бд #postgresql #инженерныештучки #heavywednesday
  • ❤ 2
  • ❤‍🔥 1
  • 👾 1
Post #460 351

Forwarded from Орлов катит в прод 🇦🇷

😋 Лазерная указка из детства - POCKET_LASER

Та самая, желтая одноразка. Которой мы бесили прохожих под окнами и которую постоянно отнимали учителя. Кому-то отдавали ее обратно после уроков? 😒

Вспомнил о ней случайно – и захотелось поиграться. В Аргентине 🇦🇷 не то чтобы они продавались так легко, значит, потрогаем мышкой.

Заодно давно хотел погонять Fable от Anthropic на чем-то посложнее мобильных проектов и глянуть, как он тащит в автономе. С одного промпта – конфетка С одного промпта базированно – 💩 Еще пара итераций – и вышло вполне недурно.

Что там внутри:
Насадки с узорами – меняются.
Крышка – откручивается, батарейки – вылетают.
Лазер – светит 😋

Лежит
на pages, можете потыкать 👉 POCKET_LASER

Если зайдет – сделаю целый сайт таких штук из детства и подумаю, как это монетизировать 💵
  • ⚡ 4
  • 💯 2
  • 😍 1
Post #459 339
Абсолютная приколюха! Вайб нулевых словил моментально!
Post #458 594
🗄Оперативное 2: Кэш ОС — ещё один уровень кэша, которым Postgres не управляет

Второй едок памяти из обзорного поста — кэш операционной системы. Именно с ним связана классическая паника «на сервере с базой вся оперативка занята, памагити, ААА!»😂

📚 Откуда он берётся
shared_buffers — это кэш самого Postgres. Но есть ещё один уровень кэша, который живёт своей жизнью. Когда любая программа читает файл с диска, операционная система запоминает прочитанные блоки в свободной оперативке. В следующий раз тот же файл прилетит уже из памяти, без похода на диск. Этот общесистемный кэш называется страничным кэшем (или же page cache) 📃

Postgres читает свои файлы — и кучу с данными, и файлы индексов — как все, через операционную систему. Значит, его страницы попадают ещё и в кэш ОС. Получается двойное кэширование: одна и та же страница может одновременно лежать и в shared_buffers, и в страничном кэше ОС 📄

🍽 Почему «вся память занята»
Операционная система не любит, когда оперативка простаивает впустую, поэтому забивает всё свободное место кэшем файлов. На Linux, например, при помощи утилиты free (которая показывает, как используется ОЗУ и пространство подкачки (swap) в системе) зачастую можно увидеть, что свободной памяти почти не осталось, а здоровенный кусок помечен как buff/cache (если, конечно, в системе активно происходит чтение файлов 🧠)

Пугаться этого не нужно. Память под кэшем ОС считается освобождаемой. То есть, правильно говорить не «память кончилась», а «сейчас память используется под кэш, но как только она понадобится другому приложению, система тут же готова уступить оперативку по первому требованию, чесслово 💯»

🔗 read ≠ чтение с диска
Напомню, что в посте про чтение страниц мы видели в плане запроса слово read — «страницы не было в shared_buffers, пришлось дочитывать». Там же мы выяснили, что read не обязательно означает поход на диск: страница вполне могла быть прочитана из кэша ОС. Поэтому read иногда оказывается почти таким же быстрым, как hit (чтение из shared_buffers, то есть, по сути, тоже из оперативки).

🅰️ Что унести с собой
🟢 Кроме кэша Postgres есть кэш операционной системы: он общий для всей машины, и Postgres им не управляет
🟢 Одна страница может лежать сразу в двух кэшах — это и есть двойное кэширование
🟢 Когда вся память используется под файловый кэш — это нормально: такая память освобождается по первому требованию других приложений
🟢 read в плане запроса значит «не нашлось в shared_buffers», а не обязательно прочитано с диска»

🧑‍💻dp🥁
#бд #postgresql #инженерныештучки #heavywednesday
  • ❤ 2
  • 🤝 2
Post #457 488
❓ Как там со статьями на хабре.

В прошлом году решил попробовать выпускать какой-то регулярный контент. И сфокусировался на выступлениях на нашем внутреннем девфоруме.

За год получилось выступить 6 раз. Темы были хорошие, довольно хардовые. Ставил себе цель выступать раз в месяц. Но по итогу получилось в среднем раз в два месяца. (плюс конечно выступил на DOTNEXT что жесть как круто)

Эксперимент был хороший – прокачался я знатно за этот год. Чууууутка 🤏 расстраивало, что все это по сути так или иначе оставались доступными только для нашего Додо-комьюнити. Ведь оно же и другим может быть полезно. Так что одно выступление я быстро превратил в статью на хабре.

А потом и решил, а что если попробовать теперь выпускать статьи на хабр? Так же раз в месяц пробовать что-то написывать туда.

Чтобы чуть ускориться придумал такой пайплайн:

0️⃣ Либо с клодом либо по своему бэклогу развития выбираю новый материал на изучение

1️⃣ Читаю и разбираюсь в нем.

2️⃣ Делаю серию постов в канальчик

3️⃣ Делаю статью с доп подробностями

Такой вариант чутка снимает прокрастинацию, так как написать пост сюда гораздо быстрее и проще, чем сразу сесть за статью. А потом из постов склеить статью проще, так как уже есть с чего начинать.

За прошедший месяц получилось сделать аж две статьи! Это супер-быстро. Ибо раньше на одну статью или выступление у меня уходило ДВА месяца!

Пока не знаю какие выводы тут сделать. Вроде работает, но надо еще потраить.

📊 Статка

В конце хочу показать статистику хабра. (на пояснительном дикпикосике как раз она). Из интересного в ней, что у меня по статистике самая лучшая оказалась статья про Caveman — короткая и про то, что скилл для клода оказался говном.

А в антитопе статья про тестовые фреймворки в .NET, над которой я сидел четыре месяца. 👋

Чутка демотивирует конечно. Но зато ребятки из подкаста RadioDotNet обратили внимание, а это уже наоборот жесть как мотивирует 💪

Так что ждите постов, они будут. А как будут, комментируйте, лайкайте, или закидывайте какашками и лягушками, в общем все эти действия активно мотивируют! Спасибо, что читаете 🖤

#хабр #контент #выступления #продуктивность
  • 🔥 5
  • 🏆 3
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →