
Расшифровка масс-спектров при помощи ML: как выглядит прогресс, если присмотреться
Примечание: работы по хемоинформатике публикуются отнюдь не только в рецензируемых журналах, но и в качестве препринтов на arXiv или openreview - последний вариант особенно распространен в ML-сообществе, где ключевые результаты всегда представляют на международных конференциях. Сегодняшняя статья - из последних, с грядущего воркшопа ICML GenBio 2026.
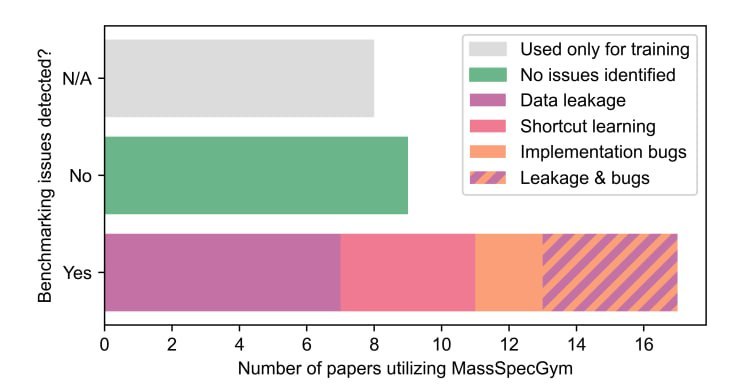
MassSpecGym - стандартный набор тестовых задач для моделей (иными словами - бенчмарк), которые определяют структуру молекул по тандемным масс-спектрам. Он появился всего год назад, но уже успел стать точкой отсчёта для сравнения новых методов в области автоматизированной рассшифровки масс-спектров. Новый препринт (см. первый комментарий), поданный 28 мая 2026 г. на воркшоп ICML 2026, анализирует, как именно исследователи пользовались этим инструментом, — и результаты заставляют задуматься: как минимум в 17 из 26 работ, ссылавшихся на этот бенчмарк, обнаружились проблемы, влияющие на достоверность заявленных выводов. Среди проблемных работ в том числе публикации в Nature Biotechnology, Bioinformatics и на самом ICML.
Авторы показывают, что ряд методов, демонстрировавших впечатляющие результаты, фактически эксплуатировал случайные технические артефакты или ложные корреляции. Например, несоответствие в канонизации SMILES между целевыми молекулами и молекулами-кандидатами позволяло модели решать задачу с Hit rate@1 82%, после устранения утечки авторами точность упала до 7%. Аналогичная утечка данных - простое ранжирование кандидатов по порядку их индексов в PubChem уже достигает точности в 50%, что сравнимо с точностью опубликованных "обученных" методов расшифровки масс-спектров.
Отдельная, и, пожалуй, более тонкая проблема - методы нередко собираются из готовых компонентов (например, энкодера), разработанных в других работах. Если хотя бы один такой компонент «видел» тестовые данные на этапе своего обучения, итоговая оценка оказывается завышена — причём это может быть совершенно незаметно при обычной проверке.
Поиск и исправление авторами подобных ошибок в корне перевернул рейтинг "лучших" текущих моделей, вернув задаче статус на практике далекой от решения. Заметим, что существенную часть потенциально ошибочных работ в рецензируемых журналах авторы просто не смогли проверить из-за нерабочего или недоступного кода.
К работе прилагается обновлённая версия MassSpecGym v1.5 с исправленными тестами и набором переобученных «чистых» компонентов моделей для будущих честных сравнений.
В заключение - главный вывод, который выходит далеко за рамки масс-спектрометрии. Эта работа наглядно показывает: даже если код из статьи запускается, а заявленные метрики воспроизводятся, это всё ещё не означает, что модель будет работать на практике. Метрика - не самоцель, а попытка ответить на вопрос «как модель поведёт себя на реальных, новых данных?». Именно этот вопрос остаётся в хемоинформатике самым важным - и пока, к сожалению, редко задаваемым.
Post #47
335
- ❤ 8
- 👍 4
- 🔥 2