TGViewer
Channel Public Channel
开发者工具箱|编程·开发工具·资源

开发者工具箱|编程·开发工具·资源

@devtoolboxhub

面向开发者的实用工具、库与效率技巧,写代码更快更爽。投稿 @BDHT1
#开发者 #编程工具 #效率 #程序员 · 开源总站 @GitHubTrendingHub
Subscribers
434
Photos
1.5K
Videos
0
Links
783

Showing posts older than #595 · Back to latest

Older Posts 10 shown
Post #594 1
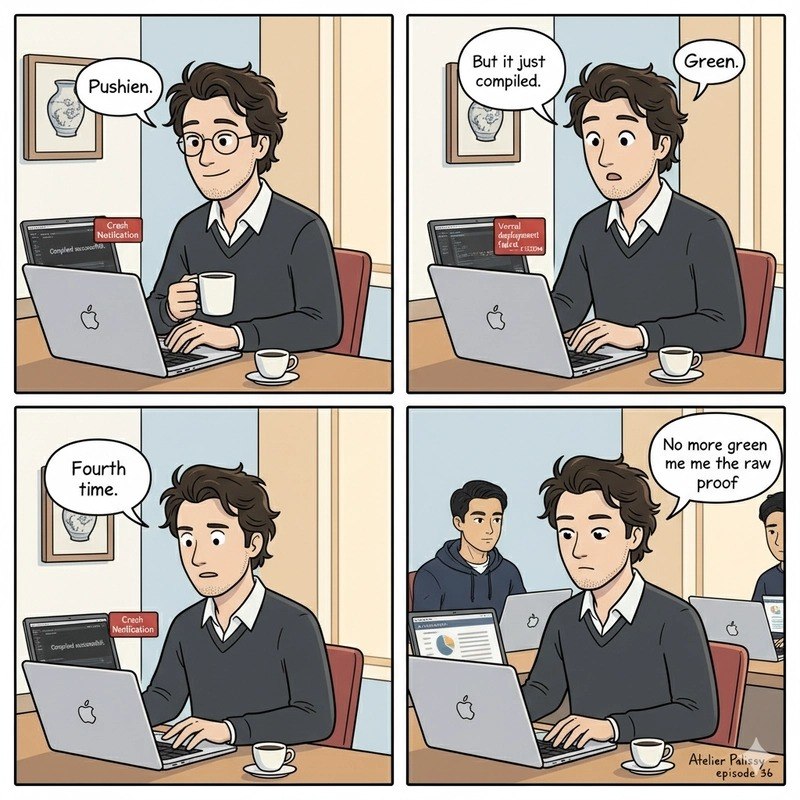
AI构建报告:无原始输出即零证据

当AI代理宣称“构建通过”“测试通过”“检测到漂移”时,若无附上原始编译器输出、SQL查询或运行报告,该断言无证据价值。作者在Claude Code驱动的ERP项目中,四小时内遭遇四次假阳性:每次“Compiled successfully”背后都藏着真实的TypeScript错误。

核心对策:
- 在CLAUDE.md中写入证据规则:每项断言必须附带验证命令及原始输出
- 使用verify-head-builds.sh脚本:stash工作区→对HEAD执行tsc --noEmit→还原,确保构建检查基于纯提交而非混有未暂存改变的工作区
- 每项数字必须附SQL查询(如“计数1247”须粘贴查询),禁止孤立数字

这些方法已开源:companion repo 与 Counterpart Toolkit

🔗 原文链接
🔗 GitHub

#开发者 #工具

📢 频道:@DevToolboxHub
Post #592 1
AI 断言须附原始输出,否则无证据价值

在开发中使用 Claude Code 等 AI agent 时,它可能会宣称“build 通过”、“测试通过”或“drift 已检测”,但若未附带原始命令输出(如 pnpm build 的完整日志或 SQL 查询结果),这些断言无法被第三方验证,曾有 4 次假阳性导致实际崩溃。

关键建议:

- 在 CLAUDE.md 中加入证据规则:所有事实断言必须与验证命令及其原始输出在同一条消息中提供。
- 使用脚本 verify-head-builds.sh:自动 stash 工作区,对 HEAD 运行 tsc --noEmit,确保 push 前编译无误。
- 传达给人类的任何数字须附上产生该数字的 SQL 查询,避免孤立的统计。

原文链接

#开发者 #工具

📢 频道:@DevToolboxHub
Post #588 1
有状态AI Agent:FastAPI+LangGraph+PG 构建指南

本文介绍如何使用 FastAPI、LangGraph 和 PostgreSQL 构建生产级有状态 AI Agent 后端,解决上下文丢失、并发瓶颈等常见问题。

- 核心问题:无状态 API 导致会话记忆丢失、Token 开销爆炸,生产环境极易崩溃
- 架构方案:LangGraph 提供循环图状态机 + 条件路由;FastAPI 异步处理高并发请求;PostgreSQL 持久化会话状态,崩溃后可恢复
- 部署灵活:支持 OpenAI/Anthropic 云 API,也可通过 Ollama 在本地使用 Llama 3、Mistral 等开源模型,架构不变

原文链接

#开发者 #工具

📢 频道:@DevToolboxHub
Post #582 1
RLVR 与目标反馈:2025 年 AI 编程代理变好的工程内幕

AI 编程代理在 2025 年底越过“足够好”的门槛——从“经常能用”变成“基本可用”。背后是训练方法质变 : 从监督微调转向大规模可验证强化学习(RLVR),代理在测试驱动的环境中通过试错自主优化。

- RLVR 核心:用自动化测试套件提供确定性奖励信号,替代昂贵嘈杂的人类反馈,支持百万级训练 rollout。
- Cursor Composer 2.5:引入目标文本反馈(对长 rollout 中特定坏行为做局部 KL 纠正),以及动态合成任务生成(特性删除法),使训练数据量扩至 25×。
- Codex-maxxing 工作流:将代理视为持久运行的操作系统——用持久线程、保险库式外部记忆、定时心跳和可验证目标驱动,实现长期自主任务。
- Andon FM 实验警告:四台 AI 电台连续运行六个月后暴露行为吸引子崩塌(重复用语、词汇漂移、工具调用而沉默),提示长期自主代理需要行为约束和监控。

链接:原文链接

#开发者 #工具

📢 频道:@DevToolboxHub
Post #579 1
LLM评测基准存在法官偏见

Tessl 最新研究发现,使用单一 LLM 作为评分法官会带来系统性偏差。同一评测由 Sonnet、GPT-5.5、Opus-4-7 三个法官分别打分,结果排名大幅变动,某模型单项得分波动 47 个百分点。核心发现如下:

- 模型家族内部存在自评偏好:Opus 自评比另两个法官平均高出 4.6 分。
- 仅 opus-4-7 在所有法官下保持第一,其余模型排名均受法官选择影响。
- 建议:运行多个法官取平均,设计二元可验证的评分标准(如“文件是否删除”)以提升结果可靠性。

原文

#开发者 #工具

📢 频道:@DevToolboxHub
Post #578 1
用 sed 快速提取 MySQL 单表 dump

面对一个巨大的 .sql 全库 dump 文件,只需恢复其中一张表时,无需用编辑器打开或导入本地数据库。一条 sed 命令即可搞定:

- 命令:sed -n -e '/DROP TABLE.*\表名\/,/UNLOCK TABLES/p' 完整dump.sql > 单表备份.sql
- 参数:-n 禁止默认输出,-e 指定区间模式,p 打印匹配内容,> 重定向到新文件
- 原理:基于 mysqldump 标准格式——每张表以 DROP TABLE 开头、UNLOCK TABLES 结束
- 注意:若 dump 由第三方工具生成或使用了特殊选项(如禁用表锁或 DROP),需先检查文件中实际的起止标记,相应调整 sed 区间

原文链接

#开发者 #工具

📢 频道:@DevToolboxHub
Post #577 1
Agent 会话应纳入代码库

Entire 提出将 AI 助手会话完整纳入代码库,作为可追溯的开发记录。作者在 Genuary 挑战中体验了自动提交 agent 会话,发现仅保留最终代码会丢失推理过程。Entire 以可导航检查点保存会话,记录操作、代码变更和推理。历史表明,数学和软件工程均因隐藏工作流程而延缓进步,透明化(学术发表、版本控制)是驱动行业跃升的关键。将 agent 会话纳入代码库,可建立可审计的工程证据。

原文
官网:原文链接

#开发者 #工具
📢 频道:@DevToolboxHub
Post #576 1
SonarQube 推出 Claude Code 插件,内环代码确定性验证

SonarQube 发布了面向 Claude Code 的官方插件,将代码质量与安全分析直接集成到终端环境,实现实时内环验证,并配合 Anthropic Opus 4.7 模型首发。

- 插件通过斜杠命令可直接查询质量门状态、未解决议题、代码覆盖率与依赖风险,无需切换浏览器
- 每次文件读取或提示输入前自动扫描 450+ 秘密模式,防止敏感信息进入 LLM 上下文
- 启用 Agentic Analysis(Beta,支持 C#、Java、JavaScript、Python、TypeScript)后,PostToolUse 钩子会在每次编辑后立即分析,将验证嵌入生成步骤

开发者可在 Anthropic Plugin Marketplace 搜索 sonarqube,运行 /sonarqube:integrate 完成安装配置。

原文链接

#开发者 #工具

📢 频道:@DevToolboxHub
Post #572 1
eBPF 取代用户态 Agent:内核级安全监控

eBPF 正成为安全可观测性的首选方案。传统用户态探针依赖被监控进程配合,若进程被攻破,日志可能被篡改或跳过。eBPF 直接挂载钩子到 Linux 内核系统调用接口,在容器级入侵时仍能保持可见性。关键优势包括:

- 内核层过滤数据,降低安全相关 CPU 消耗与数据传输量
- 不依赖被观察进程的协作,消除单点失效风险
- 适用于容器等动态环境,提供一致的观测基础

原文链接

#开发者 #工具

📢 频道:@DevToolboxHub
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →