TGViewer
Channel Public Channel
开发者工具箱|编程·开发工具·资源

开发者工具箱|编程·开发工具·资源

@devtoolboxhub

面向开发者的实用工具、库与效率技巧,写代码更快更爽。投稿 @BDHT1
#开发者 #编程工具 #效率 #程序员 · 开源总站 @GitHubTrendingHub
Subscribers
570
Photos
1.4K
Videos
0
Links
771

Showing posts older than #1298 · Back to latest

Older Posts 12 shown
Post #1297 9
ECMAScript 2026 新增 7 个实用 API

ECMAScript 2026 第 17 版规范于 2026 年 6 月 30 日获批,引入多项替换日常手写模式的语言级 API,无需框架或架构改动,适用于前端、Node.js 服务、库、数据管道和开发者工具。

Array.fromAsync() – 将异步可迭代对象直接转为数组,支持映射函数,取代手写 for await...of 循环。适用于分页 API、数据库游标、流式记录等。

Map.prototype.getOrInsert() / getOrInsertComputed() – 在 Map 中获取或插入默认值,后者仅在键缺失时计算值,简化缓存、分组、容器等模板代码。WeakMap 也有等价方法。

Iterator.concat() – 惰性连接多个同步可迭代对象,避免展开成数组并立即消耗所有内存,按需取值,适用于大型数据源的组合与提前停止场景。

Error.isError() – 跨 realm 检测真 Error 对象,解决 instanceof 在 iframe、不同 VM 环境下的不可靠问题,适用于组件库、插件系统、测试运行器等。

Math.sumPrecise() – 更精确地求和浮点数,减少累加误差,尤其适合混合量级数据、统计、科学计算。注意不是十进制算术,货币仍建议用整数分单位。

Uint8Array 原生 Base64 与十六进制方法 – toBase64() / fromBase64() / toHex() / fromHex(),替代手写 btoa/atob 或第三方库,用于 API 载荷、加密、文件哈希等。

JSON 源文本访问与 rawJSON – JSON.parse() reviver 新增 context.source 获取原始 JSON 源文本,配合 JSON.rawJSON() 在序列化时保留大整数或高精度数值,解决 Number 精度丢失问题。


建议优先采用:Map.getOrInsertComputed() 用于缓存/分组,Array.fromAsync() 用于有限异步数据源,Uint8Array 编码方法用于 API 和加密工作。使用前请检查目标环境支持情况,必要时提供 polyfill。

#开发者 #工具 #ECMAScript2026 #JavaScript #ES2026 #ArrayFromAsync #MapGetOrInsert #IteratorConcat #ErrorIsError #MathSumPrecise #Uint8Array #Base64 #Hex #JSON
@DevToolboxHub
Post #1294 7
Schemaboi:将自包含模式嵌入文件头实现数据兼容演进

受 HTML 和 HTTP 长久适应能力的启发,Seph Gentle 提出将自包含模式(schema)直接嵌入文件头,使数据无需外部定义即可始终可读。该实验性格式将向前、向后和侧向兼容性作为首要目标,允许数据格式在无需中央协调、不丢失数据的前提下持续演进。

Schemaboi 旨在解决当前应用之间数据互操作的僵化问题,让传统本地软件与云端协作之间的“虚假二选一”不再成立。通过将模式固化在数据自身结构中,任何支持该格式的工具都能理解不同版本的数据,从而推动更健壮、可持续的数据格式生态。

#开发者 #工具 #Schemaboi #SephGentle #数据兼容性 #本地优先 #自描述格式
@DevToolboxHub
Post #1293 6
indian-fakedata:为印度市场生成真实的模拟人口数据

开发面向印度市场的应用时常需要模拟人口数据用于测试、UI预览或训练ML模型,但标准生成器随机组合姓名、宗教、地区,容易产生不合逻辑的档案。indian-fakedata 基于印度人口普查、NFHS-5等真实数据源,生成统计上合理的人口档案,支持按宗教、种姓、邦、性别、年龄、教育、职业等维度过滤,输出 JSON/JSONL/CSV 格式。

安装
Node.js: npm install @abhay557/indian-fakedata (需 Node >=18)
Python: pip install indian-fakedata (需 Python 3.8+)
CLI 用法
indian-fakedata [options],常用选项:--count --output --format (json/jsonl/csv) --seed
过滤维度: --religion --state --gender --caste --socialCategory --areaType --minAge/maxAge --education --occupation --maritalStatus
Enrichment 层
--outcomes 添加信用分、健康风险等;--narrative 生成贷款申请、病历等文本;--persona 输出LLM可用角色设定。
程序化API
Node: import { generate, generateEnriched } from '@abhay557/indian-fakedata'
Python: from indian_fakedata import generate, generate_enriched
数据来源: Census 2011, NFHS-5, MSME Census, UIDAI, CSDS/Lokniti 等


工具已发布到 npm 和 PyPI,可直接集成到测试或ML工作流中。

#开发者 #工具 #IndianFakedata #Nodejs #Python #MockData #CLI #Testing #DataGeneration
@DevToolboxHub
Post #1292 8
CTF 快速文件共享:三种方案对比

CTF 比赛中,发现漏洞后要立刻把 flag 截图、配置文件传给队友,但每次都要琢磨怎么传。本文对比 netcat、Python HTTP 服务器和 SimpleDrop,帮你把时间花在解题上。

1. netcat — 零配置传输
同一网络两台机器之间快速传单个文件,nc 预装在多数 Linux 上。接收方监听:nc -l -p 1234 > received_flag.txt;发送方连接:nc <receiver_ip> 1234 < flag.txt。无加密,只适合隔离 CTF 网络。需要加密可用 ncat --ssl 或 openssl s_client。

2. Python HTTP 服务器 — 团队中心
多队友需要同一资源时,一行命令建 HTTP 服务器:python3 -m http.server 8000。队友浏览器即可下载文件。适合分词表、脚本、收集的制品。默认下载只读,不能上传。

3. SimpleDrop — 速度优先
跨团队、跨机器分享编译的 exploit、截图或压缩包时,netcat 和 HTTP 都有摩擦。SimpleDrop 无需账号、无需设置,上传即得加密链接,任何系统浏览器可用。适合二进制、截图、存档。

快速对比
netcat:零设置、无加密、隔离网络单次传输
Python HTTP:一行命令、无加密、团队资源分发
SimpleDrop:零设置、E2EE、跨团队快速分享


原则是用最简单工具匹配场景,零时间花在文件传输上。

#开发者 #工具 #CTF #文件共享 #netcat #SimpleDrop #PythonHTTPServer #加密
@DevToolboxHub
Post #1290 4
平台团队合规治理的实战方法

Davide de Paolis 在 QCon San Francisco 上分享了如何在不破坏开发者关系的前提下推行云基础设施合规。他基于 Sevdesk 平台团队的重组经验,介绍了“最小可行治理”在 AWS 上的实施方法,包括利用事件驱动的 Slack 告警来自动化策略反馈,以及从强制执法转向高同理心的数据驱动协作模式。演讲还探讨了平台团队如何在合规要求与开发者体验之间找到平衡。

#开发者 #工具 #平台工程 #合规 #AWS #Slack #事件驱动 #QCon #Sevdesk
@DevToolboxHub
Post #1289 4
MargIQ 按工作流证据优化 AI 模型成本

许多 AI 应用只给整个产品选一个模型,导致常规任务成本偏高,而盲目切到廉价模型又可能降低关键质量。MargIQ 通过分析实际流量,识别重复出现的 AI 工作流,评估当前已用模型,帮助判断哪个工作流该用昂贵模型、哪个可以换低成本模型。

MargIQ 对每个工作流给出:哪里可以换低价模型、哪里应保留原模型、哪些路由路径有足够证据、哪里质量标准太模糊不宜变动,以及估算或实际成本影响。质量保护方面,证据不足时保持原模型,避免因未明确分类或优先级规则而误判。集成方式:npm install margiq,兼容现有 provider 凭据和模型配置。免费版默认仅报告模式,不改变生产路由;准备好后可启用自动、报告或禁用控制。


如果你在跑生产级重复 AI 工作流,可以试用并反馈:工作流级别的模型推荐需要哪些证据才可信?质量与成本的权衡报告是否清晰?服务端集成对现有栈是否顺畅?

#开发者 #工具 #MargIQ #AI #模型优化 #工作流 #成本优化
@DevToolboxHub
Post #1288 9
Zeri:一个双进程多语言TUI REPL及其过度工程反思

开发者Luca耗时五个月构建了Zeri——一款TUI多语言REPL,支持Python、JavaScript(Bun)、Ruby、LuaJIT,可跨语言共享变量、保存会话,并集成Ollama本地LLM。工具本身功能性完整,但作者事后反思:它更像是“架构优先”的产物,缺乏明确的用户痛点。代码已开源。

Zeri采用双进程架构:引擎用C++23编写,负责代码评估、状态与运行时协调;前端用Go(Bubble Tea + Lip Gloss)处理渲染和输入交互。两者通过自定义二进制IPC通信,帧定界使用固定头部+JSON负载,兼顾性能与可调试性。
每种语言作为独立sidecar进程运行,隔离崩溃。SharedScope特性实现跨语言变量共享:引擎持有中立类型(JSON可序列化的基本类型与简单容器)的规范副本,按值复制,不共享内存;对函数、类实例、大整数等不支持类型显式拒绝,避免静默数据损坏。IPC协议已独立为Yuumi库,附带各语言SDK。


尽管所有功能都正确运行,作者承认这是一次典型的“architecture-first”实践:功能完整但无法回答“谁需要它、解决什么具体问题”。他分享这段经历,提醒开发者警惕过度工程化,并建议项目早期就应压力测试核心假设。

GitHub

#开发者 #工具 #Zeri #TUI #REPL #Cpp23 #Go #IPC #Yuumi #跨语言
@DevToolboxHub
Post #1287 7
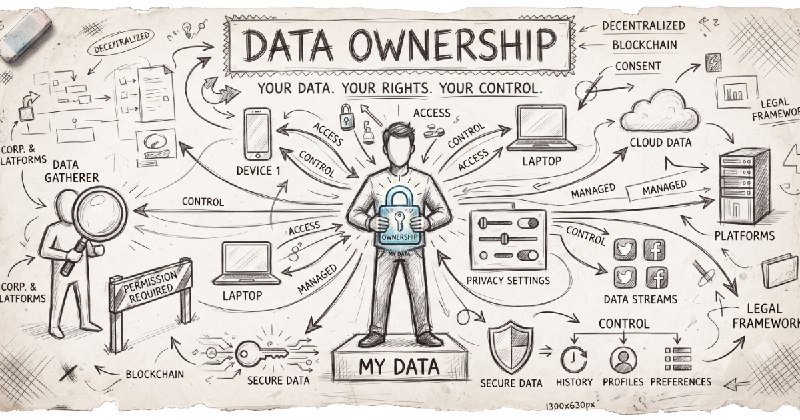
数据主权与本地优先计算挑战

本地优先计算倡导者在一场专题讨论中提出,“数据所有权”不应只停留在账户控制层面,必须扩展至结构性独立、互操作性和社区治理。该讨论于柏林举办的 Local First Conf 2026 举行,主题为“数据所有权超越本地优先”。参与讨论的嘉宾包括 Zenna Fiscella、Paul Frazee、Boris Mann 和 Robin Berjon,他们强调需要制定共享标准、解绑平台并构建更好的工具来支撑用户主权。

#开发者 #工具 #本地优先计算 #数据主权 #互操作性 #社区治理 #LocalFirstConf2026 #柏林
@DevToolboxHub
Post #1286
Channel name was changed to «开发者工具箱|编程·开发工具·资源»
Post #1285 8
从 REST 到 MCP:设计思维的转变

Sentry、Notion、GitHub、Stripe 的实践案例表明,MCP 的消费者(AI 代理)与 REST 的消费者(人类或预编译客户端)截然不同,因此接口设计也必须适配代理在运行时选择操作的特点。本文提炼了 9 条设计原则,对比同一公司在两种接口上的实现差异。

1. 围绕意图设计:MCP 工具应代表一个连贯的用户意图,将编排逻辑推入服务端。例如 Sentry 的 create_project 工具,一次调用即可完成项目创建、仓库关联、密钥获取等原本需要多个 REST 端点的操作。
2. 批量重复操作:代理常需一次创建大量资源,批量工具可减少上下文消耗并降低遗漏风险。Notion 的 notion-create-pages 直接接受数组,而非每次调用创建单页。
3. 合并紧密相关操作:增/改接口常共享参数与语义,合并为单一工具(如 GitHub 的 issue_write 通过 method 参数区分)可节省上下文并提升选择准确性。
4. 明确语义:MCP 工具应将 HTTP 状态码隐含的信号转化为显式的输入/结果,提供错误码、变化状态、恢复路径等结构化信息。
5. 文档即控制流:MCP 工具的描述直接影响代理的选择与参数构建,文档变更可能引发生产行为变化,需像代码一样测试。
6. 建议下一步动作:效仿 HATEOAS,在响应中返回 suggestedActions,引导代理执行合理的下一步。Sentry 的 get_trace_details 即提供了这一结构。
7. 支持字段过滤:MCP 工具应允许代理只请求当前决策所需字段,避免无效字段占用上下文。
8. 保护危险操作:工具描述可要求代理先警告用户并获取确认,结果中提供备份/恢复路径。
9. 渐进暴露工具:对大型 API,使用搜索类元工具先定位方法,再加载具体参数,避免一次性加载所有定义耗费上下文。

这一对比并非穷举,安全、缓存等维度需另行讨论。REST 客户端运行预编译逻辑,代理运行时选择操作,直接包裹每个 REST 端点会保留为不同消费者设计的界面,MCP 接口必须承载更多原由代码提供的知识。

#开发者 #工具 #MCP #REST #Sentry #Notion #GitHub #Stripe #架构设计
@DevToolboxHub
Post #1279 8
AI时代的治理与软件架构

本期播客中,Michael Stiefel 与 Sarah Wells 探讨了治理与软件架构的关系。治理通过建立流程来最小化系统复杂性、提升安全性并减少重复任务,帮助团队高效工作。有针对性的检查清单能减轻工程师对这些流程的压力,在关键事件响应等高压场景中尤其重要。架构应聚焦于那些难以逆转的技术决策。

#开发者 #工具 #治理 #软件架构 #AI #播客 #InfoQ
@DevToolboxHub
Post #1278 6
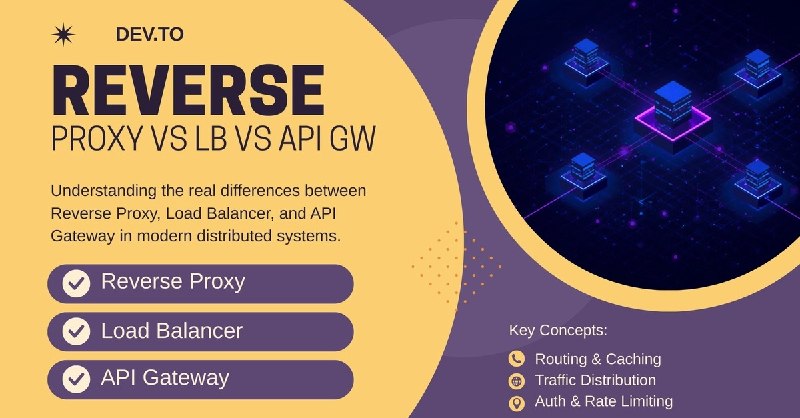
反向代理、负载均衡、API 网关有什么区别?

后端服务从单机扩展到大规模分布式系统时,反向代理、负载均衡器和 API 网关这三个术语经常被混用。它们都位于用户和服务器之间,但解决的是完全不同的故障和扩容问题。

直接连接(第0层):客户端直连后端服务器,服务器需同时处理TLS握手、静态文件、业务逻辑和安全风险,像让外科医生同时管挂号。

反向代理:放在服务器前端,负责SSL卸载、缓存、压缩、隐藏真实IP。典型工具有Nginx、HAProxy、Caddy、Envoy。它不感知业务逻辑,只按静态规则转发流量。

负载均衡器:是反向代理的进化版,专注于智能流量分配与健康检查。支持轮询、最少连接、加权轮询、IP哈希等策略,可在L4(TCP/IP)或L7(HTTP)层工作。主要工具有HAProxy、AWS ALB/NLB。

API网关:作为理解API的反向代理,统一处理认证、限流、版本迁移、请求/响应转换、可观测性。典型工具有Kong、AWS API Gateway、Apigee、Tyk。常用于微服务架构中的横切关注点集中治理。

实际工具经常跨越理论边界:Nginx可加upstream变负载均衡,加Lua插件可做API网关;Kong基于Nginx构建。生产系统通常分层部署:CDN(全球反向代理)→ API网关 → 服务负载均衡 → 本地代理。


选择建议:单服务器用反向代理(SSL/缓存);多服务器水平扩展用负载均衡器(健康检查);复杂公共API或微服务用API网关(认证/版本/限流)。

#开发者 #工具 #系统设计 #微服务 #架构 #反向代理 #负载均衡 #APIGateway
@DevToolboxHub
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →