15模型38任务实战基准评测
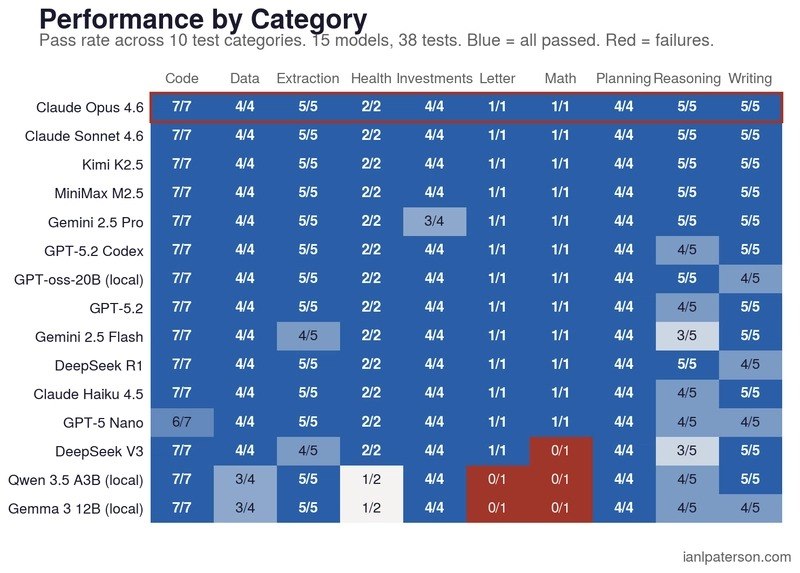
一位技术高管基于自身日常生产工作负载,对 15 个主流 LLM 模型在 38 个实际编码、提取、推理等任务上进行了实战测试,总花费仅 $2.29。核心发现:路由策略比盲目选择“最好”模型更重要。
关键要点:
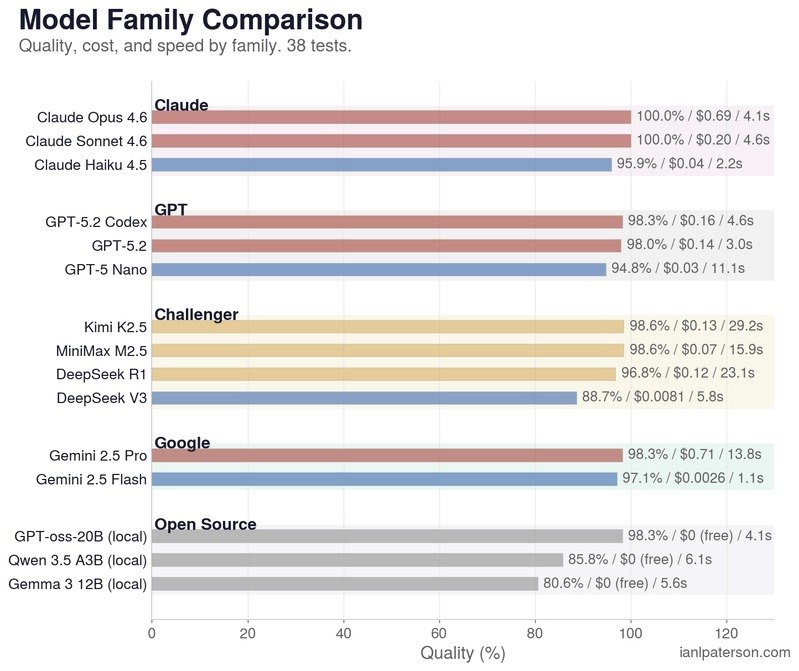
- Claude Sonnet 4.6 与 Opus 4.6 均获 100% 通过率,但 Sonnet 成本仅为 Opus 的 1/3($0.20/次 vs $0.69/次)。
- Gemini 2.5 Flash 以 $0.003/次、1.1s 中位响应实现 97.1% 质量,是性价比冠军。
- GPT-oss-20b 完全免费本地运行,得分 98.3%,超越 Haiku、R1 等付费模型。
- MiniMax M2.5 以 98.6% 通过率和 100% 格式合规率(23/38 次返回裸 JSON 无包装)成为结构化输出王者。
原文
#开发者 #工具
📢 频道:@DevToolboxHub
Post #438
1