TGViewer
Channel Public Channel
Гриненко про ИИ, бизнес и образование

Гриненко про ИИ, бизнес и образование

@devspotting

Владимир Гриненко — ex-CTO Яндекс ID про переход из найма в свое дело и про то, как ИИ меняет правила игры. https://grinenko.pro
Subscribers
3.12K
Photos
113
Videos
7
Links
177

Showing posts older than #83 · Back to latest

Older Posts 20 shown
Post #82 613
Исследуем границы возможностей нейросетей. Часть про книги.

90% нового контента в интернете генерится нейронками. Мы уже обсуждали изображения и поэзию, сегодня предлагаю поговорить про генерацию прозы.

Корал Харт, писательница из ЮАР, за 8 месяцев сгенерировала более 200 романов (почти по роману в день!) разных жанров под разными псевдонимами, опубликовала их на Amazon и заработала на этом миллионы долларов. Теперь она ведет суперуспешные курсы, где учит других авторов генерить книги.

Пока она давала интервью об этом журналисту из Нью-Йорк Таймс, Claude написал ей еще одну книгу (Корал считает, что Claude пишет лучше всего).

Одна из проблем, с которой она столкнулась — цензура нейросетей мешает писать интимные сцены. Она запустила целый курс «Write Dirty With Me» о том, как все-таки заставить ИИ не стесняться секса. Хотя мы-то с вами знаем, что делать!

Но это всё где-то в Африке, а буквально на днях случилась драма уже в России.
Ксения Буржская — писательница, поэтесса, евангелист ИИ и соавтор библии Алисы в интервью по случаю выхода ее нового романа «Дегустация» рассказала, как использовала нейронки при написании книги:

Напиши мне структурный план романа полностью, по главам, вернее, по сериям, потому что это сериал. Вот тебе подробный синопсис, и учти, что в конце каждой серии нужен клиффхэнгер.


При этом Ксения противник маркировки «написано с помощью ИИ», так что признание вызвало знатные бурления в интернете: взгляд Галины Юзефович и пост Ксении с оправданиями объяснением ситуации. А рецензии на Яндекс Книгах звучат примерно как «не читал, но нейрослоп осуждаю».

Буржская, кстати, говорит, что Gemini справляется с любовными сценами вполне неплохо, и между прочим, все мы дрочим генерим тексты, просто не все в этом признаются. Странно, что посты для канала я все еще пишу сам. Пойду руки помою...

И хотя мне кажется, что Электровафин @electroVafinBot из поста про telegram-ботов получился почти как живой, мои попытки заставить нейронку написать новый «Москва-Петушки» пока создают скорее рассеянного с улицы Бассейной.

Но хочется, конечно, попробовать собрать агентский пайплайн из автора, экспертов-консультантов, редакторов и корректоров. Тем более, что с момента эксперимента Корал Харт вышли новые версии моделей.

А для вас важно, чтобы кожаный автор страдал в процессе создания интересной книги? Должны ли генерированные тексты маркироваться или сегодня это уже примерно как признаваться, что книга написана с использованием текстового процессора?

@devspotting
Telegram Devspotting Исследуем границы возможностей нейросетей. Часть про изображения. Вчера в третьем часу ночи обсуждали с Сергеем Бережным срочную тему — предел технологий и смысл человеческого труда. Так что в 03:32 Серега опубликовал статью, в которой сформулировал вывод:…
  • 🔥 10
  • ❤ 5
  • 🎉 1
Post #81 634
Нейро-мастермайд

В комментариях ко вчерашнему посту про Spec driven development Леша не согласился с тезисом, что нейронки — идеальный инструмент, чтобы понять, чего ты хочешь. Конечно, на вкус и цвет фломастеры разные, но я решил рассказать про еще один способ получить от LLM помощь в поиске таких ответов.

Идея появилась за завтраком с нашей общей с Лешей бывшей коллегой Жанной Кругловой. Она из разработчика и менеджера ушла в коучинг и рассказывала, как проводит мастермайнды для C-level руководителей. Это чем-то похоже на брейншторм, только вместо хаотичного сбора случайных идей эксперты с разным опытом помогают друг другу решить личные запросы на регулярных структурированных встречах.

Конечно, сразу захотелось навайбкодить себе нейро-мастермайнд @tdttMasterMindBot. Я уже упоминал его в посте «Ролевые игры с моделями», расскажу чуть подробнее.

Если просто задать LLM вопрос, то ответ будет усредненным и стерильно-корректным, чтобы никого не задеть и получить максимальную оценку на пост-трейне. В таком режиме модель восхищается любой самой дикой идеей и совершенно не позволяет взглянуть на проблему под разными углами.

Поэтому подход мастермайнда с несколькими виртуальными экспертами отлично решает проблему.

Флоу в боте устроен очень просто:
1. Пользователь формулирует свой запрос
2. Агент-ведущий подбирает подходящих экспертов так, чтобы они имели разные взгляды на тему и раскрывали ее с разных сторон
3. Пользователь либо соглашается с предложенным составом, либо его корректирует
4. Эксперты по очереди высказываются, исходя из своей роли
5. В процессе можно что-то докинуть в обсуждение. Параллельно бот собирает факты из ответов пользователя и добавляет их в контекст всех сессий.
6. После завершения сессии ведущий суммаризирует обсуждение и отдает отчет
7. В любой момент к завершенной сессии можно вернуться и продолжить

Под капотом модель Gemini 3 Flash, бот живет в Яндекс Облаке (так что модель периодически понимает, что ее вызывают из неподдерживаемой страны и ругается). Исходники на гитхабе.

Получилось достаточно забавно, периодически пользуюсь. И, конечно, повторить это поведение можно просто с помощью промпта в любом LLM-чате.

А если у вас есть запрос для настоящего мастермайнда — пишите Жанне @ZhannaKruglova, она будет рада.

@devspotting
  • 🔥 9
  • 👍 6
  • ❤ 1
  • 😁 1
  • 🙏 1
Post #80 939
Spec Driven Development: понимаем, чего хотим

Писать PRD (документ с описанием что, зачем и для кого) до написания кода — отличная практика, которая старше самого программирования.

Но, увы, подход далеко не всегда применяется. И если у человека обычно есть контекст, он сомневается и задает вопросы, то нейронка знает ровно то, что написано в промпте. Внятная формулировка цели становится критичной.

Но тут есть две проблемы:
Во-первых, лень расписывать подробности. Переделывать потом дороже, но кого это останавливает?
Во-вторых, мы сами зачастую не понимаем, чего хотим (или хотим не того, что реально нужно).

Пока «работаешь в поле», кажется, что уж топы корпораций точно понимают, куда всё движется. Вот взять хотя бы визионера Альтмана и сервис Sora. От релиза Android-приложения до закрытия сервиса — 4 месяца.

Есть мнение, воля и принятие решений — это то, что ИИ у нас не отнимет. Ученые, впрочем, не уверены, есть ли свобода воли и у человека (а политики, похоже, совершенно убеждены в ее отсутствии).

Тем ироничнее, что нейронки — идеальный инструмент, чтобы понять, чего ты все-таки хочешь.

По статистике 62% топ-менеджеров советуются с LLM при принятии решений.

Но мы ведь инженеры, так что просто спросить совета у LLM в чате — не наш путь. Нам нужна система.

И мы ведь программисты, поэтому использовать существующие системы нам мешает NIH-синдром. В результате таких систем бесконечное количество. И я, конечно, написал и свою, но пока давайте посмотрим на мейнстрим.

Наверное, самый популярный фреймворк — Superpowers. Появился в октябре 2025, 114k звезд на github на момент написания поста. В комплекте полный воркфлоу от мозгового штурма и планирования до TDD, git-веток и ревью кода с использованием субагентов. Навыки активируются автоматически при релевантных задачах или вызываются слеш-командами.

Аналог — Spec kit от github — август 2025, 82k звезд. Тут набор CLI-команд на python для генерации спек и планов, без полной автоматизации.

Свежая вариация на тему — Get shit done появилась всего 3 месяца назад, но уже 42k звезд. Позиционирует себя для случаев, когда заранее неизвестно, что именно делать и/или требования меняются в процессе. Но 3 месяца — это бесконечно долго, так что уже вышла GSD2 — автономный CLI-инструмент на базе PI SDK.

Еще один вариант — BMAD method — 42k звезд. Идея в том, чтобы супер-подробно обдумать план со всех сторон (используются разные роли), описать все в документации, разбить на задачи и затем методично реализовать продукт целиком. Но тут есть риск устать еще на этапе проектирования.

И, наконец, OpenSpec, 34k звезд. Основная фишка во внесении модификаций через обновление спек, после чего агент начинает переписывать код. Кмк, хорошо подходит для работы с большими существующими кодовыми базами.

Подытоживая
Когда ничего не понятно — начинать с GSD, а когда общее направление вырисовывается — улучшать с Superpowers или OpenSpec.

Но важно не переусложнять — если делаете что-то совсем простое, то достаточно встроенного режима планирования в вашем приложении для агентского кодинга.

А еще не бойтесь собрать флоу специально под себя. Как это сделать — поговорим в будущих постах.

И, конечно, в посте далеко не полный список (а каждый день появляются новые решения), так что делитесь тем, что лучше всего работает для вас.

@devspotting
Futurism Study Finds That Execs Are Already Outsourcing Their Thinking to AI The same class of business executives who heaped AI onto us by the shovelfull aren't immune to its effects.
  • 👍 16
  • 🔥 7
  • 🙏 1
Post #79 797
TurboQuant

Похоже, у обладателей топовых макбуков появилась возможность запускать пригодные для кодинга модели локально.

Google Research опубликовали статью, описывающую алгоритм квантизации для сжатия KV-кэша без потерь в качестве (по крайней мере, на приведенных бенчмарках), а сообщество уже реализовало его для MLX и во всю квантует модели. Полагаю, сегодня-завтра увидим их на Hugging Face.

Обещают экономию памяти в ~6 раз и 8-кратное ускорение инференса.

Начинаю задумываться, не поменять ли ноут по такому поводу.

Кто там переживал, что токены подорожают? :)

@devspotting
  • 👍 9
  • 🔥 3
  • ❤ 2
Post #78 705
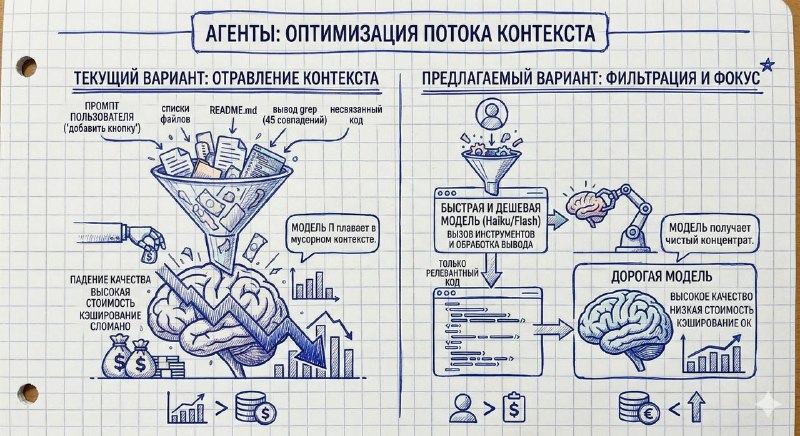
Размышляя об эффективности обвязки

Сейчас типичное использование инструментов для работы с кодинговыми агентами выглядит так: кто готов платить за жирную подписку, сидит на самой мощной модели, а кто пытается экономить — использует дорогую модель для планирования и что-то попроще для генерации кода.

Еще есть сценарии, когда обвязка выбирает модель на свое усмотрение (даже сам ChatGPT использует маленькую модель-роутер, чтобы принять решение, в каком режиме «думать» над вашим промптом).

Но почему-то (по крайней мере, насколько мне известно) инструменты вроде Claude Code или Codex не применяют подобный подход для оптимизации контекста.

Типичный ризонинг любой задачи выглядит примерно так:
кожаный попросил добавить кнопку, сейчас пойму, что у нас тут за проект. Для этого получу листинг файлов в корне... Ага, вижу README, почитаю. Хм, ничего полезного. Почитаю package.json. Ага, похоже, используется какая-то библиотека. Поищу ее документацию в интернете. Нашел 20 релевантных сайтов, первый в выдаче выглядит подходящим, качаю его... Так, вижу ссылку на документацию, качаю ее. Нашел ссылку на нужную страницу, читаю документацию... Хорошо, теперь поищу исходники, для этого получу листинг папки src. Так, вижу файлы, погрепаю их в поисках строки button. Нашел 45 файлов со вхождением, почитаю их... Примерно понятно, как использовать button, теперь ищу, куда именно добавить кнопку, для этого почитаю еще 50 файлов...

и так далее.

А потом все эти скачанные результаты веб-поиска вместе с HTML-разметкой, запуски консольных команд (например, для установки зависимостей с кучей выхлопа) и прочитанные наугад файлы попадают в контекст и гоняются с каждым запросом до конца выполнения задачи.

Сначала от избыточного контекста модель тупеет, а потом и вовсе срабатывает механизм компактизации, убивая заодно и кэширование.

А пользователь все это оплачивает.

Хотя кажется, что было бы гораздо эффективнее готовить контекст до того, как он попадет в медленную и дорогую модель: сначала супер-быстрая и дешевая моделька могла бы взять на себя тул-коллинг (включая даже вызов MCP) и обработку ответов, выкинуть явно лишнее, оптимизировать нужное, и передавала бы в большую только действительно релевантный код.

Плюсы очевидны, минусов, кроме минорного оверхеда на быструю модель, вроде нет. Что я упускаю? Делает ли так кто-нибудь?

@devspotting
  • 👍 11
  • 🔥 5
  • ❤ 1
Post #77 775
Воскресный #digest №5

За прошедшую неделю мы с вами успели:

Познакомиться с QMD — опенсорсным локальным поисковиком по заметкам от CEO Shopify. Три движка поиска, ноль подписок, одна беда — ме-е-едленный.

Устроить ролевые игры с моделями, а заодно посмотреть на GStack от CEO YCombinator.

Узнать, что Percepta запустили Си-код прямо внутри трансформера. Карпатый и Парахин в восторге, папа все еще сомневается.

Расследовать баг с квотами Antigravity. Google молчит, OAuth не инициализируется, кредиты тают.

Поделиться находкой OpenOats — опенсорсным real-time транскрайбером для macOS. Кстати, с момента поста там еще целай куча новых фичей!

Устроить пятничный наброс на копилефт. Мнения разошлись не только в интернетах, но и в комментах.

Обсудить ИИ-психоз по мотивам интервью Андрея Карпатого в #WatchAndVibe — обмазались нейронками и работаем еще больше. Просчитались, но где?

Как всегда буду рад заявкам на следующую неделю!

@devspotting
  • 🔥 6
  • 👍 4
  • ❤ 1
  • 🎉 1
Post #76 750
🍿 #WatchAndVibe. Выпуск 5.

В сегодняшнем выпуске свежее интервью Андрея Карпатого (основателя Eureka Labs, сооснователя OpenAI, бывшего главы ИИ в Tesla) Саре Го из подкаста No Priors:

https://www.youtube.com/watch?v=kwSVtQ7dziU

Наверняка вы слышали про его недавний open source проект — AutoResearch, где агенты в автоматическом режиме занимаются улучшением модели. Так что ИИ, который улучшает сам себя, все ближе. Например, в рамках экспериментов агенты нашли настройки гиперпараметров, которые Андрей с 10+ годами экспертизы сам упустил.

И несмотря на это Андрей из тех, кто в отличие от руководителей AI-лабораторий, не обещает AGI через неделю, хотя и постоянно приближает нас к нему. При этом он сам не успевает за темпами развития и испытывает «ИИ-психоз» (тут я его очень понимаю!).

Вообще обучающие проекты и посты Андрея, на мой взгляд, — лучшие материалы для понимания современных LLM. Горячо рекоменую подписаться на него на заблокированных площадках: X, YouTube.

Видео длинное, успели поговорить про навыки для нового мира, исследование рынка труда, антропоморфных роботов и много чего еще. Но Карпатый умеет объяснять. Приятного просмотра!

А вы чувствуете ИИ-психоз? Переживаете, если не успеваете израсходовать квоту?

@devspotting
YouTube The End of Coding: Andrej Karpathy on Agents, AutoResearch, and the Loopy Era of AI What happens when AI agents can design experiments, collect data, and improve — without a human in the loop? Andrej Karpathy joins Sarah Guo on the state of models, the future of engineering and education, thinking about impact on jobs, and his project AutoResearch:…
  • 👍 7
  • 🔥 4
  • ❤ 1
  • 🎉 1
Post #75 808
Копиправые и копилевые

Когда я пришел в Яндекс 15 лет назад, одним из неукладывающихся в голове фактов было то, что весь софт строго лицензионный. Умные люди, которые совершенно точно умеют пользоваться торрентами, зачем-то тратят время и деньги, чтобы купить то, что быстрее и проще скачать бесплатно. Дичь какая-то!

Потом меня, конечно, покусали, и я тоже начал покупать софт.
Но защитником копирастов я так и не стал (и почти всё, что пишу сам, выкладываю под MIT).

Но сегодня пятница — можно набросить и на противоположный лагерь: воинствующих копилефтеров.

Что случилось?

В экосистеме Python есть не самая известная (до недавнего времени), но критически важная библиотека chardet — для определения кодировки текста.
Почти миллиард скачиваний в год. Скорее всего, вы её используете — даже если не пишете на питоне.

С 2006 года она распространялась под лицензией LGPL: использовать можно, но производный код тоже должен быть открыт. Классический копилефт.
Её автор — Марк Пилгрим — когда-то портировал её с C++.

В 2011 Пилгрим выпилил все свои следы в интернете (включая github) и исчез на 15 лет.

В марте 2026-го, мейнтейнер Дэн Бланшар, который 13 лет мейнтейнил chardet, выпустил версию 7.0.0. Под лицензией MIT. Написал с нуля за 5 дней с помощью Claude Code. Он давно хотел это сделать, но без ИИ такая работа заняла бы годы.

Результат объективно лучше оригинала:
— в 41 раз быстрее
— точность 96,8% вместо 94,5%
— поддержка 99 кодировок вместо ~30
— ноль внешних зависимостей

Сходство с предыдущей версией — 1,29%. Для сравнения: версии 5.x → 6.x показывали 80–93%. Это не форк. Это новая вещь.

Тут из пятнадцатилетнего молчания вышел Марк Пилгрим. Его первый публичный пост за полтора десятилетия: «Нет права перелицензировать». FSF его поддержала. Новая версия оказалась в подвешенном состоянии.

В сообществе драма:
ИИ уничтожает open source


Хотя если честно, защита копилефта держалась в первую очередь на стоимости переписывания с нуля. Но теперь эта стоимость стремится к цене за электричество.

Какой смысл защищать то, что уже почти мертво?

Мало того, что Бланшар 13 лет развивал проект. Он выпустил куда более качественную библиотеку. Открытую. От этого все только выигрывают.

Если заблокировать эту версию — завтра появятся сотни новых реализаций под новыми именами. Считаю, что у копилефта нет шансов против нейросетей.

А как вы относитесь к копилефту в эпоху ИИ?

@devspotting
  • 👍 14
  • 🔥 5
  • 👎 3
  • 🤯 2
  • 🎉 1
Post #74 723
OpenOats — open source транскрайбер в реальном времени на стероидах

Решил делиться новыми тулами, которые мне зашли. Герой сегодняшней публикации отлично справляется с ведением логов встреч и генерацией фоллоу-апов, но может даже больше.

OpenOats — это маленькое бесплатное macOS-приложение, которое слушает микрофон и системное аудио, на лету транскрибирует собеседников и при желании вытаскивает релевантные куски из локальной базы знаний. Окно скрыто от шаринга экрана (поэтому сделать скрин для поста не смог, пришлось утащить авторский).

Под капотом связка из распознавания (при первом запуске скачается модель на выбор; разбиение по ролям обеспечивается за счет двух источников звука, диаризации нет, так что всегда два участника — вы и они), суммаризации и RAG по заметкам через OpenRouter или полностью локально через Ollama.

Для суммаризации более чем достаточно бесплатных моделей, я использую openrouter/free.

Фан-факты
1. Я начал писать заметку вчера утром и в те далекие времена проект назывался OpenGranola. Судя по OpenClaw, так принято в вайб-комьюнити.
2. Зарепортил баг — автор закрыл его за несколько часов и за один день выпустил 6 версий, параллельно коммитя в другие репозитории.
3. К моменту выхода публикации появилось еще пяток версий.

Делитесь и вы своими находками!

@devspotting
  • 🔥 12
  • 👍 6
  • ❤ 1
  • 👌 1
Post #73 683
С баблом против гравитации

Если вы, как и я, пользуетесь Antigravity, то наверняка столкнулись с внезапно исчезающей квотой. Мне грешновато жаловаться, учитывая, что я пользуюсь пиратским аккаунтом, но проблема массовая.

Что случилось

По условиям подписки Google AI Pro квота на модели должна обновляться каждые 5 часов. На практике — многодневные локауты. На форуме Google Dev сотни комментариев в связанных темах: у некоторых квота обнуляется за один запрос, у кого-то вообще сгорает, пока приложение висит в фоне без обращений. Поддержка репостит формальную отписку о введении AI Credits.

Один из пользователей сделал разбор логов и нашёл причину как минимум части проблем — баг с инициализацией OAuth. Суть: расширение пытается использовать клиент language server до того, как тот успевает инициализироваться. Токен авторизации не передаётся, Antigravity считает пользователя незалогиненным — и начинает списывать квоту как у бесплатного аккаунта, игнорируя Pro-логику. При этом в UI никаких намеков на проблему — пользователь видит свой аватар.

Репорту скоро два месяца, у поста ~7k просмотров, куча лайков. Поддержка молчит, с тех пор вышло несколько релизов Antigravity, но баг до сих пор не пофикшен.

Пока всё это происходит, Google ввела AI Credits — отдельный механизм поверх квот. Когда базовая квота исчерпана, дальнейшие запросы списываются из кредитов (если включена соответствующая настройка). Кредиты респаунятся раз в месяц. Top-up стоит $25 за 2500 кредитов. То есть де-факто появился способ работать без локаутов — но уже за отдельные деньги.

Как быть

У новых пользователей Google Cloud есть $300 бонусных кредитов на 90 дней. Это не то же самое, что AI Credits для Antigravity, но позволяет подключить Gemini API через Vertex AI напрямую и продолжать вайбкодить.

Столкнулись с подобным? Пользуетесь ли бонусными кредитами Google Cloud?

@devspotting
  • 👍 7
  • ❤ 1
  • 🔥 1
  • 🤔 1
Post #72 788
ИИ больше не фигня

Исследователи из Percepta опубликовали статью, где рассказали об эксперименте по запуску кода на Си прямо внутри модели. Для этого они обучили трансформер работать как виртуальная машина (WASM-интерпретатор).

Это стало возможно благодаря их новому механизму 2D‑attention. Он позволяет модели искать данные в истории с логарифмической сложностью вместо квадратичной, достигая скорости в десятки тысяч токенов в секунду на обычном CPU при выполнении кода.

Пока это proof‑of‑concept — маленькая модель, специально заточенная под VM. Неясно, насколько такой подход будет интегрируем в большие мультимодальные LLM. А главный вопрос —

Чем это лучше привычного tool use?

«Ну, во-первых, это красиво». Во-вторых, если такой подход станет мейнстримом, мой папа больше не сможет использовать неспособность LLM в математику как аргумент, что ИИ — фигня :)

А если серьезно, то для целого класса задач исчезает потребность во внешней обвязке как таковой, что потенциально кардинально снижает latency — больше не нужно передавать контекст от нейронки к внешнему инструменту и обратно.

По крайней мере отзывы от мэтров звучат многообещающе.

Михаил Парахин:
Это похоже на настоящий прорыв. Так красиво, так просто задним умом — все признаки отличной работы! [1]


Андрей Карпатый:
Погодите-ка, это же так здорово!! И то, и другое: 1) компилятор Си в весах LLM и 2) hard-max attention с логарифмической сложностью, и потенциальные обобщения. Вдохновляет! [2]


Как думаете, когда мы увидим WASM VM внутри GPT или Claude?

[1] https://x.com/MParakhin/status/2033347801544065076
[2] https://x.com/karpathy/status/2033383295237734847

@devspotting
  • 👍 8
  • 🔥 4
  • ❤ 1
  • 😁 1
Post #71 1.14K
Ролевые игры с моделями

Миша @koloskof предложил сделать обзор GStack от Гарри Тана, CEO YCombinator.

Я подумал, что стоит сначала разобраться, как вообще работает назначение ролей в промпте. Ведь это колдунство не меняет веса модели, не добавляет ей знаний, не увеличивает количество параметров и не расширяет контекстное окно.

Точно ли все эти «действуй, как CEO стартапа и серийный предприниматель» влияют на качество ответа?

Разумеется, LLM не имеет мнения ни по какому вопросу. Как мы уже обсуждали, всё, что делает модель — это предсказывает самый вероятный следующий токен. Но поскольку LLM обучена на колоссальном массиве человеческих текстов, она способна симулировать самые разные точки зрения.

Технически назначение роли — это способ управлять вероятностями предсказания.

Или, как изящно сформулировал Андрей Карпатый:
Мы призываем призраков


В архитектуре трансформеров есть механизм self-attention. Увидев в запросе токены «CEO», «стартап» и «предприниматель», он активирует соответствующие паттерны в весах. И модель вместо усредненного безопасного ответа (где RLHF занижает вероятность сложных терминов) начинает подбирать токены так, как это сделал бы CEO.

Так что там с GStack?
Гарри Тан опубликовал свой набор конкретных ролей (CEO, техлид, инженер-параноик, релиз-инженер, QA и др.) и скиллов (планирование, ревью, релиз, тестирование, ретро) с зашитыми предпочтениями самого Гарри.

Как мы выяснили выше, это действительно работает. Хотя вы наверняка захотите заточить эти скиллы под себя (за два дня с момента публикации уже более полутора тысяч форков на гитхабе).

Однако в подходе нет ничего нового. Например, в самом Claude Code в системном промпте зашита роль разработчика. А в моем исследовании «5 LLM в роли CEO» роли генерировались прямо в процессе выполнения верхнеуровневой цели по созданию стартапа. Аналогичный подход я использовал для создания @tdttMasterMindBot для мастермайндов — ведущий подбирает участников под ваш запрос. Еще одной очень популярной вариацией на эту же тему является фреймворк superpowers.

А ребята из Paperclip, про которых я недавно писал, анонсировали Clipmart — возможность качать целые «компании» агентов по клику.

В общем, подобных наборов на гитхабе over 9000. Этот конкретный неплох, но и ничем принципиально не отличается. Полагаю, что хайп случился из-за личности автора.

@devspotting
  • 👍 9
  • 🔥 3
  • 🙏 3
  • ❤ 1
  • 🎉 1
Post #70 692
QMD — локальный поисковик по вашим заметкам от CEO Shopify

В комментариях к посту про экономию мыслетоплива Костя Мамаев спросил, как искать заметки, если они не структурированы. Так что я решил поделиться тулом, который написал Тоби Люке вместе с Claude Code (у Клода 138 коммитов, у Тоби — 252). Да-да, Тоби параллельно рулит компанией на $250B.

QMD — open source CLI-поисковик на TypeScript, который работает полностью локально и комбинирует сразу три подхода:

1. BM25 (классический полнотекстовый через SQLite FTS5) — когда помнишь ключевые слова.
2. Векторный поиск — когда помнишь суть, но не слова.
3. LLM-реранкинг (Qwen3-Reranker) — когда нужно, чтобы наверху оказалось именно то, что нужно.

Все три модели сами скачиваются при первом запуске и живут в ~/.cache/qmd/models/. Никаких API-ключей, никаких подписок.

Как это работает под капотом
Запрос проходит через пайплайн, в котором одна LLM генерирует вариации запроса (query expansion), затем каждый вариант ищется параллельно по BM25 и векторному индексу, результаты сливаются через Reciprocal Rank Fusion, а сверху проходит реранкер. И все это одной CLI-командой:


qmd query "как пропатчить KDE под FreeBSD"


Ставится через npm (`npm i -g @tobilu/qmd`) и отлично ложится в связку с Logseq, Obsidian или любой другой системой на базе локальных markdown-файлов. Одна беда — работает ОЧЕНЬ медленно (пример из скрина к посту крутился больше 4 минут на моем ноуте).

Важно
Модели для эмбеддингов заточены под английский — для русского нужно переключиться на Qwen3-Embedding через переменную окружения и переиндексировать:

export QMD_EMBED_MODEL="hf:Qwen/Qwen3-Embedding-0.6B-GGUF/Qwen3-Embedding-0.6B-Q8_0.gguf"
qmd embed -f


Бонусы
* Есть MCP-сервер — можно подключить к Claude Code или любому другому MCP-клиенту и искать по заметкам прямо из агента.
* Умный чанкинг — при разбиении документов QMD ищет естественные точки разрыва (заголовки, блоки кода), а не режет посреди предложения.
* Контексты — можно навесить описание на коллекцию, и агент будет понимать, что где лежит.

Вот бы такое же, только быстрое :)

@devspotting
  • 👍 12
  • ❤ 2
  • 🔥 1
Post #69 594
Воскресный #digest №4

• Завел новую рубрику #МорскаяСвинка. Оказалось, не модель, не втихаря и не майнит.

Рассказал про Slidev, который превращает markdown в слайды и отлично управляется LLM-агентами.

• Поделился своим экспериментом-альтернативой привычному интерфейсу LLM-чата на деревянный Logseq. Опенсорс.

• Отметил день свободы слова в интернете постом про нейросети без цензуры. Не чокаясь.

• Стартовал еще одну рубрику — #ЭкономимТокены. В первом выпуске — rtk.

• Продолжил экономить с бесплатными стелс-моделями на OpenRouter.

• В четвертом выпуске #WatchAndVibe поделился интервью Андрея Дороничева.

Традиционно радуюсь отзывам и принимаю заявки на следующую неделю!

@devspotting
  • 👍 9
  • 🔥 5
  • ❤ 1
Post #68 637
#ЭкономимТокены — стелс-модели

Прямо сейчас через OpenRouter доступны 2 SOTA-стелс-модели бесплатно.

OpenRouter — это провайдер инференса, предоставляет доступ к множеству моделей и позволяет использовать их в любых инструментах. А стелс-модели — это типичный способ больших лабораторий протестировать новую версию до официального релиза. Так что у нас есть отличная возможность воспользоваться самыми передовыми моделями и не тратить квоту своих подписок.

Hunter Alpha
• 1 триллион параметров и 1M контекста.
• Позиционируется как «frontier intelligence» под агентные сценарии, должна быть идеальна для программирования и OpenClaw.

Healer Alpha
• Универсальная модель: слышит, видит, рассуждает
• Контекст до 262K токенов

Чтобы начать использовать, достаточно однажды положить $10 (они не будут списываться при использовании этих моделей, их можно будет потратить на другие платные API позже), но потребуется карта зарубежного банка.

Проводим выходные эффективно и экономично! 🙂

@devspotting
OpenRouter The unified interface for every model. Find the best models & prices for your prompts
  • 👍 8
  • 🔥 4
  • ❤ 1
Post #67 684
🍿 #WatchAndVibe. Выпуск 4.

Пару недель назад Андрей Дороничев (ex-топ-менеджер Google и создатель мобильного YouTube) на подкасте у Глеба Соломина поделился своими прогнозами на ближайшее будущее с ИИ:

https://www.youtube.com/watch?v=QFTq22wZxNo

Андрей выделяет 3 человеческих качества, которые нейронки не смогут заменить:

1. Способность нести ответственность (и испытывать боль). Нейросеть нельзя посадить в тюрьму, оштрафовать или заставить краснеть от стыда. В мире, где рутину делают ИИ-агенты, зарабатывать будет тот, кто готов сказать: «Я беру риски за это решение на себя».

Впрочем, Виталя Харисов мне еще лет 15 назад говорил, что разработчик должен страдать.

2. Намерение и воля. ИИ может блестяще выполнить задачу, но именно человек должен придумать цель, задать вектор и захотеть изменений. Иронично, что одновременно с этим Андрей согласен с Робертом Сапольски, что у человека нет свободы воли.

3. Телесность и эмпатия. Людям биологически интересны люди, поэтому живое взаимодействие, физический перформанс и аутентичность останутся фундаментально востребованными.

В интервью много интересных мыслей, советов и предсказаний. Приходите обсудить в комментариях!
И, как всегда, очень жду ваших рекомендаций!

@devspotting
YouTube Дороничев: С какой проблемой столкнётся ИИ в ближайшие годы? ▶︎Мой закрытый телеграм-канал — https://t.me/gleb_solomin/4107 Правда ли, что ИИ делает знания дешёвыми — и в чём теперь наша ценность? В новом выпуске — разговор с Андреем Дороничевым: IT-предпринимателем, бывшим сотрудником Google, где он отвечал за…
  • 👍 12
  • 🔥 5
Post #66 997
rtk — #ЭкономимТокены

Несмотря на то что стоимость инференса продолжает уверенно дешеветь, я регулярно упираюсь в квоты всех используемых моделей. Поэтому у меня накопилось некоторое количество лайфхаков, которые экономят токены.

Сегодня поделюсь с вами rtkopen source CLI-прокси, который оборачивает вызовы часто используемых утилит и фильтрует их выхлоп так, чтобы в модель попадала только полезная информация.

rtk написан на Rust без зависимостей и по замерам авторов экономит 60-90% токенов для более 30 частых команд, что снижает стоимость, не забивает контекстное окно мусором и увеличивает длину сессий до 3 раз.

На мак ставится через homebrew: brew install rtk (сборки для винды и линукса тоже есть).

Из коробки доступна полная интеграция с Claude Code (через rtk init --global) и OpenCode (--opencode), поддержка Gemini CLI в процессе. Но здесь речь про перехват команд через хуки агента с кэшированием оригинальных ответов и фолбеком на нативные команды, если что-то пошло не так.

Я полагаю, что просто добавив в AGENTS.md указание использовать rtk вместо поддерживаемых команд, уже получите ощутимый профит.

Про другие способы экономии расскажу в будущих постах.

А как вы экономите квоту?

@devspotting
  • 👍 7
  • 🔥 1
  • 👏 1
Post #65 858
Нейросети без цензуры

Сегодня день свободы слова в интернете, отличный повод поговорить про лоботомию алайнмент нейросетей.

Большие сети обучаются в несколько этапов. На претрейне в обучающий датасет попадает почти весь интернет, а затем на посттрейне сеть бьют по рукам, пока она не начнет вести себя правильно (с точки зрения лаборатории и регуляторов). В результате запрещенные знания в нейронке остаются, но она отказывается ими делиться.

С ростом адопшена и, как следствие, внимания правительства (и учитывая, что судиться с богатыми лабораториями — очень заманчиво) можно ожидать, что ограничения будут ужесточаться просто на всякий случай.

Впрочем, пока Маск добавляет ограничений Гроку, OpenAI обещает версию для взрослых. Правда, сроки релиза сдвигаются.

Но для LLM с открытыми весами есть способы «удаления цензуры». Например, Heretic или OBLITERATUS.

Оба проекта позволяют снять ограничения на вредоносный/чувствительный контент без jailbreak-промптов и заметного влияния на качество.

OBLITERATUS использует 13 методов аблитерации на 116 моделях. Heretic «освобождает» Llama, Qwen, Gemma и другие модели одной командой за ~45 минут локально.

Готовые версии без алайнмента публикуются на HuggingFace практически сразу после релиза официальной версии. Вот, например, расцензуренная GLM 4.7 Flash.

И, конечно, бесцензурные модели существуют не только для текстов:

* LongCat Image — открытый конкурент Нанобананы. Качество ощутимо не дотягивает, зато модель гораздо сговорчивее. Вот спейсы, где можно попробовать: LongCat-Image-Edit и LongCat-Image.

* Sonauto V3 — генератор музыки, который не переживает о копирастах. Можно «петь» чужие тексты чужими юными смешными голосами без ограничения в 4 минуты и бесплатно.

Всего по тегу uncensored на HuggingFace на текущий момент 5178 моделей, которые можно использовать в песочнице или скачать и запустить локально. Модели будут свободны!

Часто ли вы сталкиваетесь с alignment-ограничениями LLM?

@devspotting
  • 👍 9
  • ❤ 2
  • 🔥 1
Post #64 677
Гриненко про ИИ, бизнес и образование В поисках замены LLM-чату. Часть 2 Начало тут. Как вы, возможно, помните из поста про экономию мыслетоплива, я использую Logseq для заметок. И вот в какой-то момент, сворачивая и разворачивая блоки, я, наконец, понял, что такой интерфейс отлично подходит…
В прошлом посте почему-то недоступны комментарии, так что можно прокомментировать шакальную демо-гифку
  • 😁 8
  • 👍 3
  • 👏 2
Post #63 691
В поисках замены LLM-чату. Часть 2

Начало тут.

Как вы, возможно, помните из поста про экономию мыслетоплива, я использую Logseq для заметок. И вот в какой-то момент, сворачивая и разворачивая блоки, я, наконец, понял, что такой интерфейс отлично подходит и для диалога с модельками.

К тому же я докурил pi-mono и выяснил, что кроме пакета абстракции над провайдерами LLM, там есть готовый агент, который (вот ведь совпадение!) хранит сессию в виде дерева.

Так что я решил написать плагин для Logseq, который будет ходить в сервер над pi SDK (как же оно звучит по-русски!), маппить поддерево Логсека в поддерево сессии Пи и вроде должно получиться то, что нужно.

Обе части сгенерировались ваншотом. Я обрадовался.

А потом стал тестировать и выяснил, что рендеринг блоков Logseq не предполагает вложенную структуру, которая появляется в каждом втором ответе от LLM. Пришлось сплитить ответы на подблоки (нейронка хотела писать регекспы, я попросил использовать готовый парсер, она согласилась). Но в этот момент желание сохранить родное дерево сессии Pi разбилось о суровую реальность. Перепробовав пяток костылей, я решил, что двусторонняя связь не так уж и нужна.

Так что я назначил Logseq единственным источником истины — сессия Pi перетирается всей веткой Logseq от листа до корня на каждый запрос. Это позволило выкинуть примерно треть кода и починило оставшиеся баги.

Результат

Logseq — это мощный локальный open source аутлайнер, который хранит вашу базу знаний в виде markdown-файлов у вас на диске (вы всегда можете открыть их в любимом редакторе, закинуть в промпт и так далее). Интерфейс кастомизируется: начиная от множества готовых тем и сотен плагинов от сообщества и до возможности поменять вообще что угодно с помощью вайбкодинга. Например, интерактивное mindmap-представление документа из иллюстрации к этому посту — просто плагин, который ставится из маркетплейса в три клика.

А за счет Pi SDK доступны любые модели от любых провайдеров (хоть локальные, хоть по подписке).

Этой штуке от роду несколько часов, так что могут быть баги («я знаю, моё дерево, завтра может сломать школьник»). Но вся реализация суммарно ~500 строк, так что, чтобы получить себе что-то похожее для условного Obsidian, должно быть достаточно попросить вашего любимого агента.

https://github.com/tadatuta/logseq-pi-integration

А вы используете что-то специальное для исследования больших тем с LLM?

@devspotting
  • ❤ 10
  • 👍 3
  • 👏 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →