Random Forest vs Gradient Boosting — реальное сравнениеСамый частый вопрос в табличных данных:
что выбрать — Random Forest или Gradient Boosting?
Ответ, который никто не любит:
зависит от задачи.
Но давай разберёмся по-честному, без мифов.
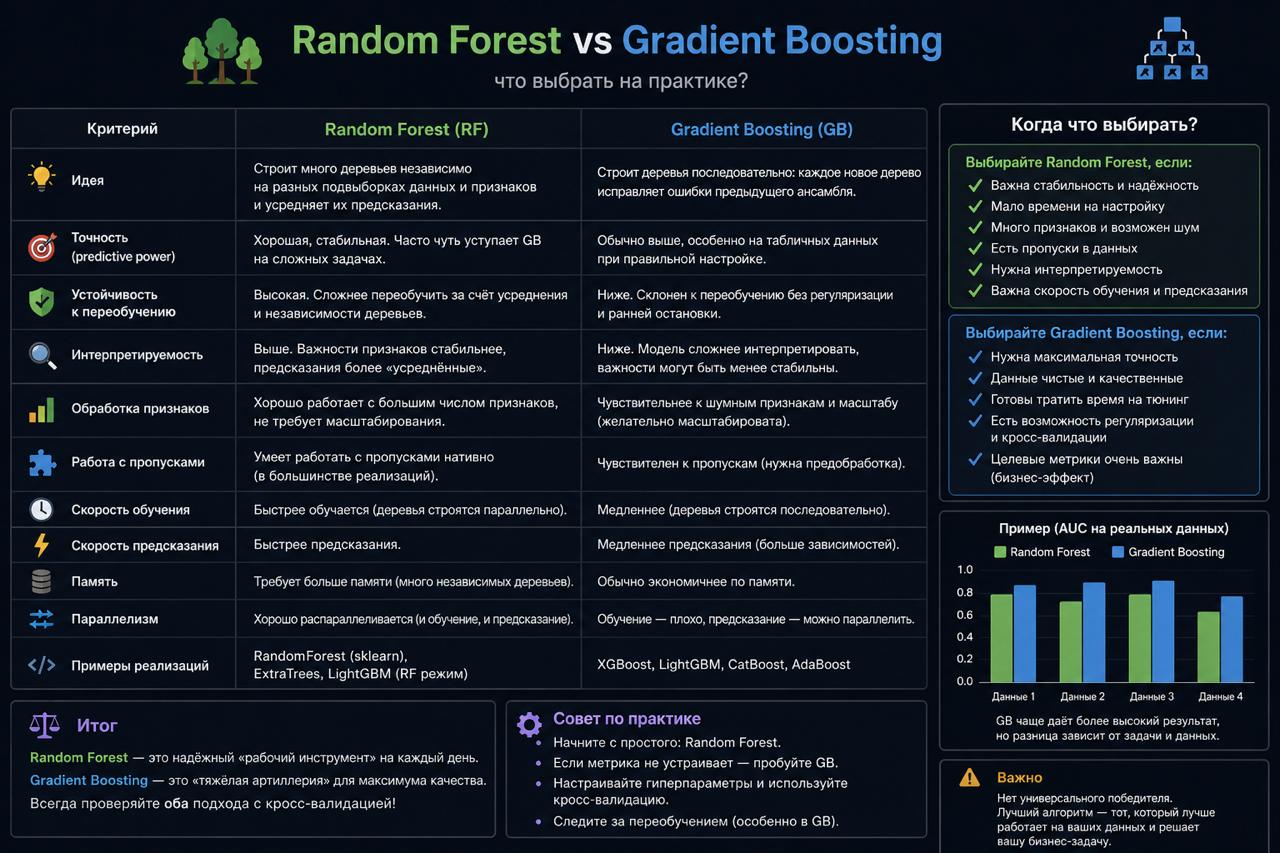
Что такое Random ForestЭто ансамбль деревьев, где:
👉 каждое дерево обучается независимо
👉 используются случайные подвыборки данных и фич
Идея: уменьшить variance за счёт усреднения.
Что такое Gradient BoostingЭто ансамбль деревьев, где:
👉 каждое следующее дерево исправляет ошибки предыдущего
👉 обучение идёт последовательно
Идея: минимизировать ошибку шаг за шагом.
Главное отличие👉 Random Forest → деревья независимы
👉 Gradient Boosting → деревья зависят друг от друга
👉 RF = параллель
👉 GB = последовательность
Качество моделиВ большинстве задач:
👉 Gradient Boosting выигрывает
Почему:
👉 лучше улавливает сложные зависимости
👉 оптимизирует ошибку напрямую
Поэтому:
👉 XGBoost
👉 LightGBM
👉 CatBoost
Стали стандартом индустрии.
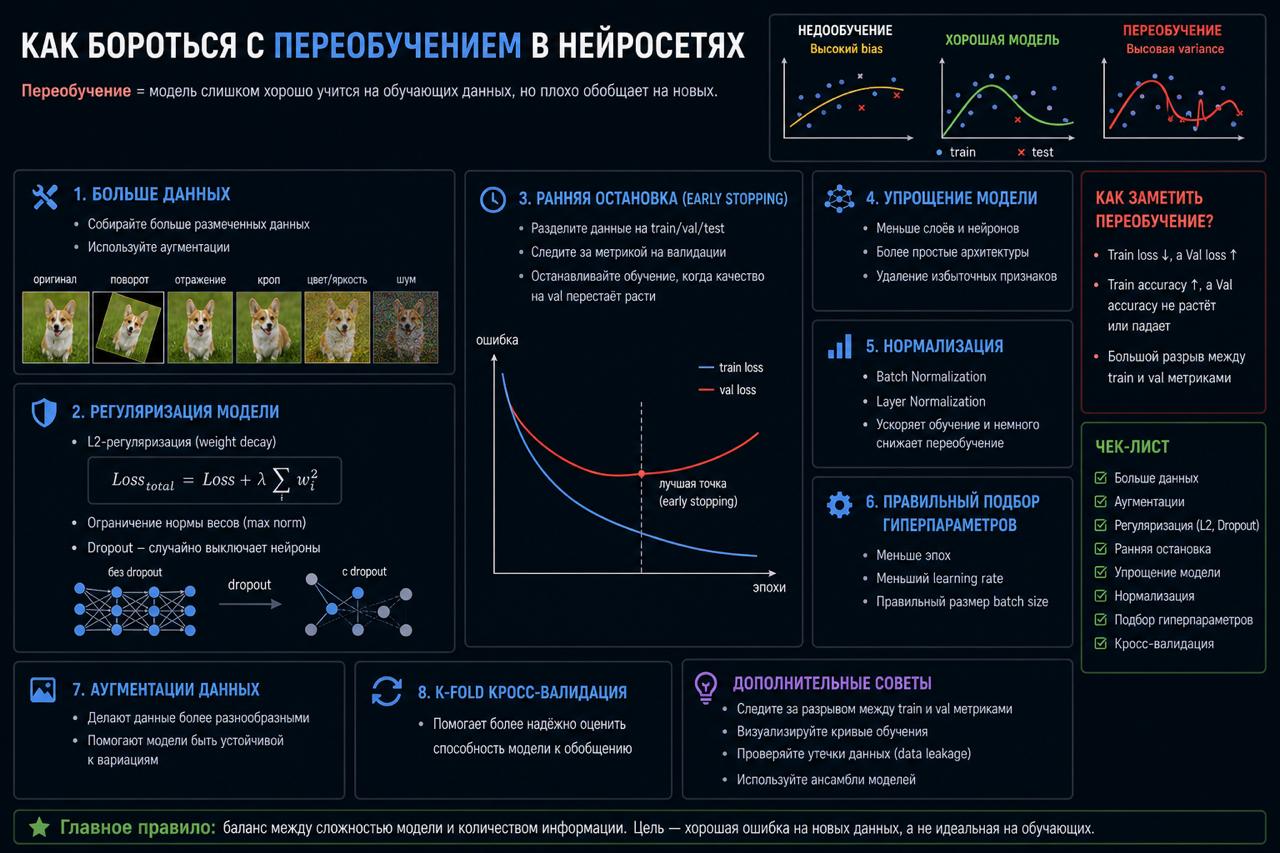
ПереобучениеRandom Forest:
👉 устойчив к переобучению
👉 работает «из коробки»
Gradient Boosting:
👉 легко переобучается
👉 требует настройки
GB мощнее, но опаснее.
СкоростьОбучение:
👉 RF → быстрее и параллелится
👉 GB → медленнее (последовательность)
Инференс:
👉 часто сопоставим
Чувствительность к даннымRandom Forest:
👉 менее чувствителен к шуму
👉 проще в использовании
Gradient Boosting:
👉 чувствителен к:
👉 шуму
👉 выбросам
👉 плохим фичам
Зато раскрывает хороший feature engineering.
Когда выбирать Random Forest👉 нужен быстрый baseline
👉 мало времени на тюнинг
👉 данные шумные
👉 нужна стабильность
«Запустил и работает».
Когда выбирать Gradient Boosting👉 нужна максимальная точность
👉 есть время на тюнинг
👉 данные относительно чистые
👉 важен результат
«Выжать максимум».
Главный инсайт
Random Forest — надёжный середняк.
Gradient Boosting — инструмент для победы.
В одном предложении
Хочешь быстро и стабильно → Random Forest.
Хочешь максимум качества → Gradient Boosting.