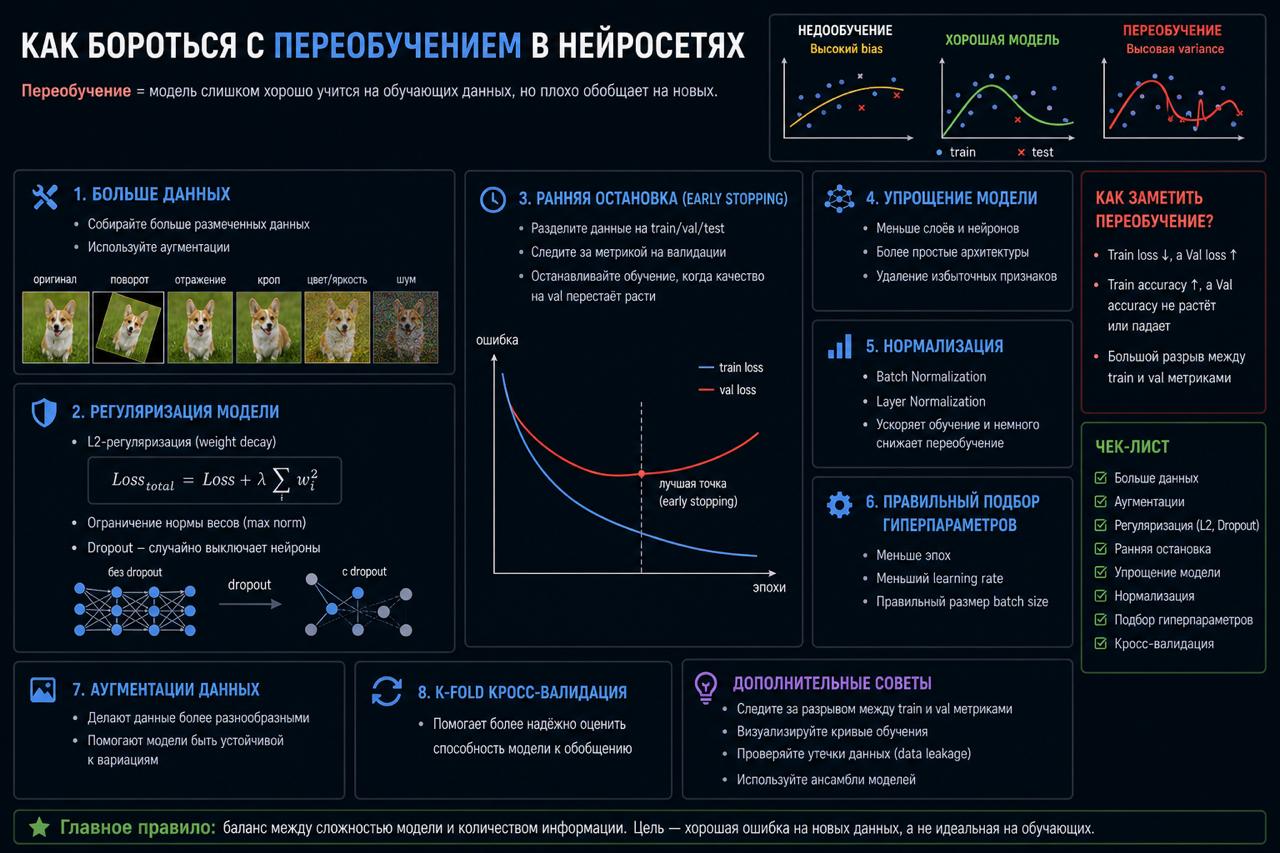
Переобучение — это момент, когда модель:
👉 идеально знает train
👉 и плохо работает на новых данных
Она запоминает, а не обобщает.
Разберём, как с этим бороться на практике.
1. Больше данных
Самый надёжный способ.
Если данных мало:
👉 собирай новые
👉 делай data augmentation
👉 используй синтетические данные
Больше разнообразия = меньше шансов запомнить шум.
2. Regularization
Добавляем штраф за сложность модели.
Основные варианты:
👉 L2 (weight decay)
👉 L1
Меньше веса → проще модель → меньше overfitting.
3. Dropout
Во время обучения случайные нейроны «выключаются».
Что происходит:
👉 модель не может полагаться на конкретные связи
👉 учится быть более устойчивой
Обычно используют:
👉 0.2 – 0.5
4. Early Stopping
Следим за валидацией:
👉 train loss падает
👉 val loss сначала падает, потом растёт
Останавливаем обучение в момент роста val loss.
Это один из самых эффективных методов.
5. Упростить модель
Иногда решение очевидное:
👉 меньше слоёв
👉 меньше параметров
👉 проще архитектура
Большая модель легче переобучается.
6. Data Augmentation
Особенно важно для:
CV:
👉 повороты
👉 шум
👉 кропы
NLP:
👉 перефразирование
👉 замены
Модель видит больше вариантов одного и того же.
7. Batch Normalization
Помогает:
👉 стабилизировать обучение
👉 немного снижает переобучение
Не основное решение, но усиливает остальные.
8. Правильная валидация
Если плохой split — ты не заметишь проблему.
Используй:
👉 train / val / test
👉 k-fold при малых данных
Иначе будешь оптимизировать иллюзию.
Главный инсайт
Переобучение — это сигнал:
👉 либо мало данных
👉 либо модель слишком сложная
👉 либо обучение настроено неправильно
В одном предложении
Чтобы уменьшить переобучение —
добавь данных или убери сложность модели.