
Qwen3-Max-Thinking: внезапно очень сильный игрок на фронтире
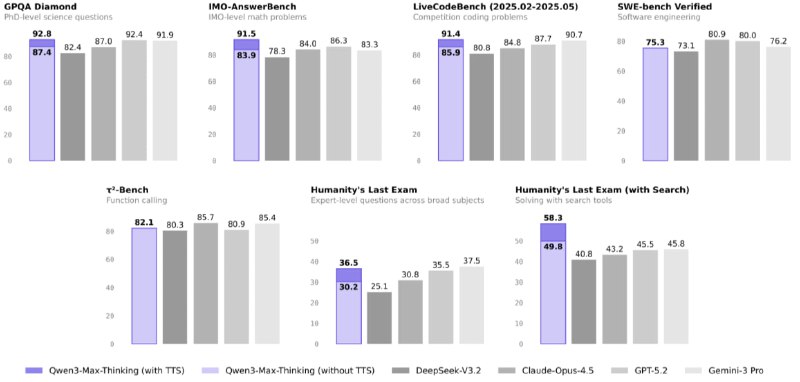
Вышла Qwen3-Max-Thinking и мимо неё реально сложно пройти. По метрикам выглядит бодро: HLE 30.2 — примерно уровень Claude Opus 4.5, а с test-time scaling ещё выше; SWE Verified 75.3 — чуть ниже опуса, где-то рядом с Gemini 3 Pro; IMO 83.9 — вообще бьёт Gemini 3 Pro. Плюс обещают вменяемый tool call и хорошее следование инструкциям даже на длинном контексте, что для thinking-моделей критично. Весов, правда, нет (модель гигантская), но поиграться можно в чате. В целом ощущение такое, что Qwen от Alibaba всё увереннее заходит на полноценный frontier-уровень — и в последнее время радует заметно больше, чем DeepSeek.
Data Science
Post #5469
3.78K

- 👍 9
- ❤ 4
- 🐳 1