Стратегии повышения производительности системы(продолжение
предыдущего поста)
1. Применение CAP-теоремы и PACELC-теоремы для выбора баланса характеристик системы-
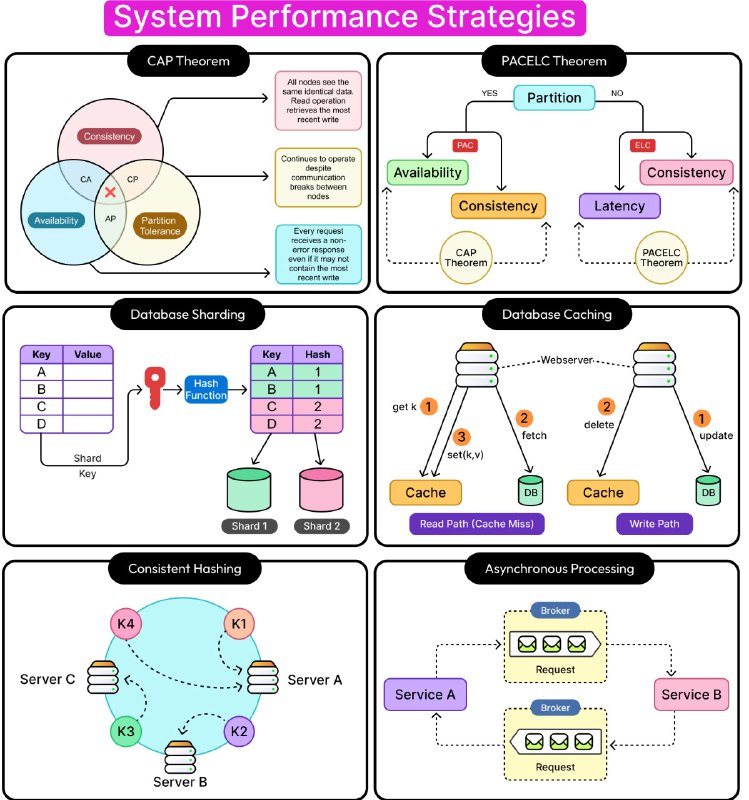
CAP-теорема утверждает, что распределённая система может одновременно обеспечить только два из трёх свойств:
-
Consistency (согласованность) — все узлы видят одинаковые данные;
-
Availability (доступность) — каждый запрос получает ответ, даже если он не содержит самых актуальных данных;
-
Partition Tolerance (устойчивость к разделению) — система работает при разрывах связи между узлами.
Варианты выбора: -
CP-системы (Consistency + Partition Tolerance) — приоритет точности данных (например, в финансах).
-
AP-системы (Availability + Partition Tolerance) — приоритет доступности, временная несогласованность данных допустима (например, в развлекательных сервисах).
-
CA-системы (Consistency + Availability) — возможны только при исключении сетевого разделения
-
PACELC-теорема расширяет CAP-теорему:
- При
разделении сети (P) система выбирает между
доступностью (A) и
согласованностью (C).
- В
штатном режиме (E) — между
задержками (L) и
согласованностью (C). Это позволяет оптимизировать производительность за счёт снижения задержек в обычных условиях работы
2. Шардирование базы данных (Database Sharding)-
Суть: распределение данных по нескольким инстансам или серверам базы данных, где каждый шард содержит уникальный поднабор данных.
-
Преимущества: - Горизонтальное масштабирование — система легко адаптируется к росту нагрузки и объёму данных.
- Уменьшение нагрузки на отдельные узлы за счёт распределения запросов.
-
Механизм: использование
функции хеширования (Hash Function) для распределения ключей (Keys) по шардам (Shards) на основе вычисленного хеша.
-
Пример на изображении: ключи A, B, C, D распределяются по двум шардам (Shard 1 и Shard 2) с помощью хеш-функции.
3. Кэширование базы данных (Database Caching)-
Суть: хранение часто используемых данных в кэше для ускорения доступа к ним.
-
Компоненты: -
Webserver отправляет запросы к кэшу и базе данных.
-
Cache хранит копии данных для быстрого доступа.
-
DB — исходная база данных, к которой обращаются при «промахе кэша» (Cache Miss).
-
Процессы: -
Read Path (Cache Miss): если данные отсутствуют в кэше, система обращается к БД, забирает данные, сохраняет их в кэше и возвращает клиенту.
-
Write Path: при записи данных сначала обновляется кэш, затем — БД.
-
Преимущества: - Снижение нагрузки на БД.
- Уменьшение времени отклика системы.
- Повышение пропускной способности.
4. Согласованное хеширование (Consistent Hashing)-
Суть: метод распределения данных по узлам с минимизацией перераспределения при добавлении/удалении узлов.
-
Как работает: - Пространство ключей представляется как кольцо (на изображении — круг с ключами K1, K2, K3, K4).
- Узлы (серверы) также распределяются по этому кольцу.
- Каждый ключ назначается ближайшему по кольцу узлу.
-
Преимущества: - Балансировка нагрузки между узлами.
- Устойчивость к отказам узлов — данные перераспределяются только на соседние узлы.
- Лёгкость масштабирования — добавление/удаление узлов требует перераспределения лишь небольшой части данных.
5. Асинхронная обработка (Asynchronous Processing)-
Суть: отделение тяжёлых вычислительных задач от основного потока выполнения для повышения отзывчивости системы.
-
Компоненты: -
Service A и
Service B — сервисы, обменивающиеся сообщениями.
-
Broker — посредник (очередь сообщений), который буферизирует запросы.
-
Механизм: - Сервис A отправляет запрос в брокер.
- Брокер сохраняет запрос и передаёт его сервису B, когда тот готов обработать.
- Сервис B обрабатывает запрос асинхронно, не блокируя основной поток сервиса A.
-
Преимущества: - Повышение пропускной способности — система не ждёт завершения операций.
- Разделение ответственности между сервисами.
- Устойчивость к временным сбоям — брокер сохраняет запросы до их обработки.