Шардинг базы данных (Database Sharding)
(продолжение предыдущего поста)
1. Что такое шардинг?
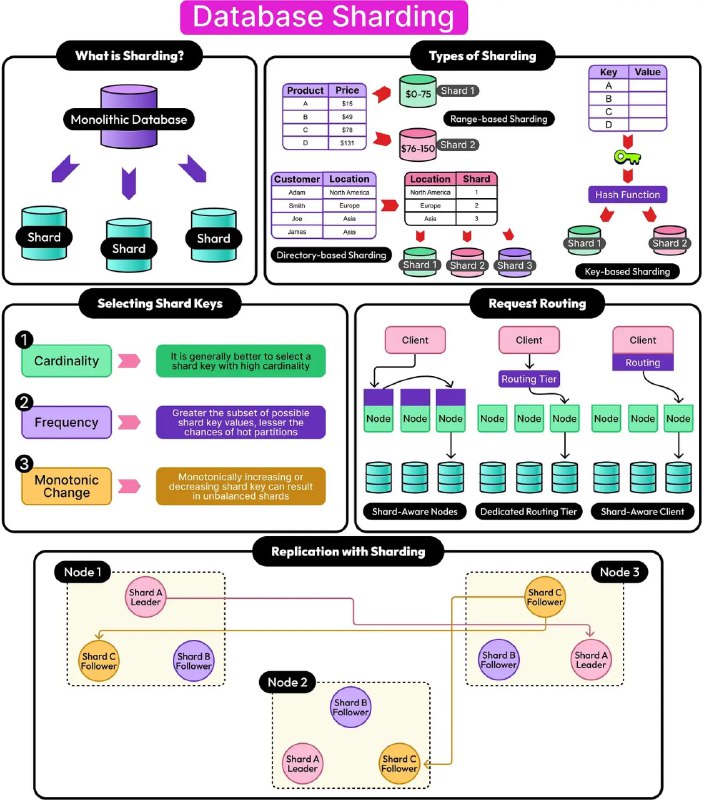
Шардинг — это процесс разделения монолитной базы данных (Monolithic Database) на несколько меньших частей, называемых шардсами (shards). Цель шардинга — распределить нагрузку и увеличить масштабируемость системы. На изображении показано, как одна большая база данных разделяется на несколько шардов.
2. Типы шардинга
Существует несколько способов распределения данных по шардам:
- Range-based Sharding (шардинг по диапазонам): данные распределяются по шардам на основе диапазонов значений. Например, продукты с ценой от $0 до $75 попадают в Shard 1, а с ценой от $76 до $150 — в Shard 2. Это удобно, когда данные можно логично разделить по числовым диапазонам.
- Directory-based Sharding (шардинг на основе каталога): данные распределяются по шардам согласно определённым категориям (например, по географическому расположению клиентов). На изображении показано, как клиенты из разных регионов (North America, Europe, Asia) направляются в соответствующие шарды (Shard 1, Shard 2, Shard 3).
- Key-based Sharding (шардинг по ключу): используется хеш-функция (Hash Function) для распределения данных по шардам на основе уникального ключа. Например, ключ (Key) определяет, в какой shard попадёт запись. Это позволяет равномерно распределить нагрузку, если хеш-функция хорошо сбалансирована.
3. Выбор ключей шардинга (Shard Keys)
При выборе ключа шардинга важно учитывать три аспекта:
- Cardinality (кардинальность): лучше выбирать ключ с высокой кардинальностью (большим количеством уникальных значений). Это помогает избежать перегрузки отдельных шардов.
- Frequency (частота использования): чем больше подмножество возможных значений ключа, тем меньше вероятность «горячих разделов» (hot partitions) — ситуаций, когда один шард получает непропорционально много запросов.
- Monotonic Change (монотонное изменение): если ключ монотонно увеличивается или уменьшается (например, временные метки), это может привести к неравномерному распределению данных (один шард будет постоянно получать новые записи). Следует избегать таких ключей.
4. Маршрутизация запросов (Request Routing)
Чтобы система знала, к какому шарду обращаться, используется механизм маршрутизации запросов. Существуют три основных подхода:
- Shard-Aware Nodes (узлы, осведомлённые о шардах): узлы сами знают, где находятся данные, и напрямую обращаются к нужным шардам.
- Dedicated Routing Tier (выделенный уровень маршрутизации): специальный слой маршрутизации (Routing Tier) определяет, к какому шарду направить запрос. Это упрощает логику клиентов.
- Shard-Aware Client (клиент, осведомлённый о шардах): клиент сам решает, к какому шарду отправить запрос, основываясь на логике шардинга.
5. Репликация с шардингом (Replication with Sharding)
Для обеспечения отказоустойчивости и доступности данных используется репликация. На изображении показано, как данные шардов реплицируются между узлами (Node 1, Node 2, Node 3):
- Leader (лидер): основной узел, который обрабатывает записи (writes) для шарда.
- Follower (фолловер): реплицирует данные лидера, может обрабатывать только чтения (reads). Если лидер выходит из строя, один из фолловеров может стать новым лидером.
Например:
- Shard A Leader на Node 1 реплицируется на Shard A Follower на Node 2 и Node 3.
- Аналогично для Shard B и Shard C.
Итог
Шардинг позволяет:
- распределить нагрузку между несколькими серверами;
- увеличить производительность и масштабируемость системы;
- обеспечить отказоустойчивость за счёт репликации;
- оптимизировать доступ к данным с помощью грамотной маршрутизации запросов.
Ключевой момент — правильный выбор ключей шардинга и стратегии распределения данных, чтобы избежать «горячих разделов» и обеспечить равномерную нагрузку на систему.
Post #3441
1.89K