TGViewer
Channel Public Channel
دیتایاد | هوش مصنوعی و علم داده

دیتایاد | هوش مصنوعی و علم داده

@datayad

دوره های جامع پایتون، علم داده و یادگیری ماشین و دیگر دوره های مرتبط با این حوزه
(با بالا ترین سطح رضایت دانشجویان دوره)

سایت دیتایاد:
https://datayad.com

پشتیبانی دیتایاد در بله:
https://ble.ir/@datayad_support
Subscribers
5.61K
Photos
409
Videos
105
Links
963

Showing posts older than #675 · Back to latest

Older Posts 20 shown
Post #674 651
🚀 آیا هوش مصنوعی به سقف پیشرفت خودش می‌رسه؟

خیلیا فکر می‌کنن هوش مصنوعی می‌تونه تا بی‌نهایت رشد کنه، ولی واقعاً اینطوره؟ 🤔 بعضی دانشمندا معتقدن یه سقف یا محدوده وجود داره که AI هیچ‌وقت نمی‌تونه ازش رد بشه.

🧠 محدودیت‌های محاسباتی
قوانینی مثل قانون مور نشون میدن سخت‌افزار یه روزی به مرز خودش می‌رسه. همینطور بعضی مسائل ذاتاً NP-hard هستن و حتی قوی‌ترین کامپیوترها هم نمی‌تونن به راحتی حلشون کنن.
🌍 محدودیت‌های شناختی و انسانی
از طرف دیگه، حتی اگه سخت‌افزار نامحدود باشه، شاید بعضی جنبه‌های هوش مثل خلاقیت یا آگاهی اساساً قابل محاسبه نباشن.
✨ جمع‌بندی
پس بله، شاید هوش مصنوعی سقف داشته باشه. اما تا رسیدن به اون سقف، پیشرفت‌ها انقدر سریع و هیجان‌انگیز هستن که می‌تونن دهه‌ها آینده ما رو زیر و رو کنن.
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • ❤ 8
Post #673 642
💥دوره جامع بینایی کامپیوتر و پردازش تصویر:

تخفیف + اقساط + مشاوره رایگان

بیش از ۶۰ ساعت دوره پیشرفته از مبانی و مفاهیم مقدماتی تا موضوعات تخصصی دنیای بینایی کامپیوتر و پردازش تصویر

ویژگی های دوره بینایی
✅ توجه به مفاهیم و پروژه در کنارهم
✅ کدنویسی همزمان با استاد، بدون استفاده از کد آماده
✅ پشتیبانی کامل ازطریق گروه خصوصی تلگرام
✅ آپدیت‌های رایگان همیشگی برای همه دانشجویان
✅ دسترسی دائمی به ویدیوها، بدون محدودیت زمانی
قراره چی یاد بگیریم:
✅درک تصویر و ساختار انواع تصویر
✅پردازش تصویر با OpenCV
✅تحلیل ویدیو
✅یادگیری عمیق در بینایی کامپیوتر
✅تشخیص اشیا با یادگیری عمیق
✅ردیابی اشیا و بررسی انواع الگوریتم ردیابی اشیا
✅تشخیص چهره
✅تحلیل تصاویر پزشکی و ماهواره ای
✅KalmanFilter, DeepSort, SIFT
✅Generative adversarial network (GAN)
✅single-shot detector (SSD)
✅Few-Shot Object Detection
✅SegNet
✅YuNet
✅ViT(vision Transformers)
و ......
🔥اینها یه بخشی از مباحث آموزشی این دوره ست

🖥️ ویدیو معرفی دوره

📞 نیاز به مشاوره رایگان داری؟
مشاوره رایگان

📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 👍 2
  • 😍 1
Post #671 810
۵ مقاله برجسته در حوزه یادگیری عمیق

این 5 تا مقاله هر کدوم نقطه عطفی در دنیای هوش مصنوعی بودن.فایل مقالات رو براتون آماده کردیم. میتونید دانلود کنید.

1️⃣ شبکه‌های (ResNet)
مکانیزم Residual Connections باعث شد آموزش شبکه‌های خیلی عمیق امکان‌پذیر بشه و عملکرد مدل‌ها به شکل چشمگیری بهبود پیدا کنه.

2️⃣ ترانسفورمرها (Transformers)
معماری ترانسفورمر با معرفی مکانیزم Attention تونست جایگزین RNNها در (NLP) بشه و انقلابی در این حوزه ایجاد کنه.

3️⃣ الگوریتم بهینه‌سازی آدام (Adam)
الگوریتم آدام با ترکیب ایده‌های Adagrad، RMSprop و Momentum به یکی از کارآمدترین روش‌های بهینه‌سازی تبدیل شد و الان به‌طور پیش‌فرض در اغلب مدل ها استفاده می‌شه.

4️⃣ الکس‌نت (AlexNet)
یکی از شاهکارهای AlexNet این بود که آموزش رو روی GPU انجام داد. همین موضوع سرعت آموزش روی دیتاست عظیم ImageNet رو چند برابر کرد.

5️⃣ برت (BERT)
مدل‌های زبانی رو با معماری bidirectional transformers ارتقا داد. با استفاده از تکنیک Masked Language Modeling (MLM)، درک عمیق‌تری از زبان طبیعی ممکن شد.

📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • ❤ 5
Post #670 580
🚀 راز پشت صحنه استدلال مدل‌های زبانی

خیلی‌ها فکر می‌کنن وقتی می‌گیم «مدل زبانی استدلال می‌کنه» یعنی با یه پرامپت ساده مثل فکر کن و بعد جواب بده همه‌چی حل می‌شه. اما واقعیت پشت این ماجرا خیلی پیچیده‌تره 🧠

🧩 استدلال = ساختار، نه دستور
مدل‌های زبانی مثل GPT یا LLaMA صرفاً با «دستور به فکر کردن» هوشمندتر نمی‌شن. اون‌ها روی میلیاردها داده و الگوهای زبانی آموزش دیدن و وقتی ازشون استدلال می‌خوایم، در واقع دارن از اون الگوها برای شبیه‌سازی مسیرهای منطقی استفاده می‌کنن.

🔍 چینش درست = نتیجه بهتر
اینجاست که تکنیک‌هایی مثل Chain of Thought یا Prompt Engineering مهم می‌شن. اگر قدم‌به‌قدم سؤال رو بچینیم، مدل هم قدم‌به‌قدم خروجی می‌ده. پس «ساختار» پرامپت‌هاست که کیفیت استدلال رو بالا می‌بره، نه صرفاً گفتن "فکر کن".

⚡ جمع‌بندی: مدل مثل مغز ما فکر نمی‌کنه!
مدل‌های زبانی مغز ندارن؛ اون‌ها ماشین پیش‌بینی کلمه‌ان. چیزی که ما «استدلال» می‌بینیم، در اصل بازتولید الگوهای منطقی از داده‌های گذشته‌ست. قدرت اصلی اونجاست که ما یاد بگیریم چطور این بازتولید رو هدایت کنیم.

📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • ❤ 4
Post #669 652
🚀 حافظه در مدل‌های هوش مصنوعی مدرن!

چند روز پیش درباره ظهور RNN و LSTM صحبت کردیم؛ جایی که برای اولین بار مفهوم حافظه وارد شبکه‌های عصبی شد و انقلابی در پردازش داده‌های دنباله‌ای ایجاد کرد. 🧠 اما امروز، مدل‌های مدرن چطور این مسئله رو مدیریت می‌کنن؟

🔹 ترانسفورمرها و حافظه توجهی
مدل‌هایی مثل GPT و BERT به جای حافظه داخلی پیچیده، از مکانیزم Attention استفاده می‌کنن. این مکانیزم به مدل اجازه می‌ده در هر لحظه روی بخش‌های مهم ورودی تمرکز کنه و ارتباط بین کلمات دور و نزدیک رو به‌خوبی درک کنه.
🔹 حافظه کوتاه‌مدت در کانتکست
در مدل‌های زبانی مدرن، "حافظه" بیشتر به صورت Context Window تعریف میشه؛ یعنی مدلی مثل GPT فقط روی تعداد مشخصی از توکن‌ها در یک پنجره زمانی تمرکز می‌کنه و فراتر از اون چیزی رو یادش نمی‌مونه.
🔹 حافظه بلندمدت؛ چالش آینده
برای مدیریت اطلاعات طولانی‌مدت، پژوهش‌ها به سمت تکنیک‌هایی مثل حافظه برداری (Vector Databases) و اتصال مدل‌ها به پایگاه داده خارجی رفته. این یعنی مدل‌ها بتونن فراتر از محدودیت پنجره، اطلاعات پایدار رو ذخیره و بازیابی کنن.
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 😍 2
Post #668 595
🚀 ورود GPUها و انقلاب AlexNet

بعد از معرفی CNN و RNN، هنوز یه مشکل بزرگ وجود داشت: سخت‌افزارها خیلی ضعیف بودن. شبکه‌ها روی کاغذ جواب می‌دادن، اما توی عمل برای داده‌های واقعی مقیاس‌پذیر نبودن.🦾🤖

💻 نجات با GPU
اوایل دهه ۲۰۱۰ محقق‌ها فهمیدن همون کارت‌های گرافیکی (GPU) که برای بازی ساخته شدن، برای آموزش شبکه‌های عصبی هم عالی‌ان. چون GPU می‌تونه هزاران محاسبه رو به صورت موازی انجام بده.
📊 نقطه عطف: AlexNet
سال ۲۰۱۲، مدل AlexNet با استفاده از GPU روی مسابقه ImageNet شرکت کرد و همه رو شوکه کرد. خطای دسته‌بندی تصاویر رو نصف کرد و نشون داد «یادگیری عمیق» واقعا کار می‌کنه.
⚡ چرا مهم بود؟
✅ ثابت کرد CNN می‌تونه توی مسائل واقعی جواب بده

✅ وجود GPU آموزش رو چندین برابر سریع‌تر کرد

✅ صنعت دوباره روی AI سرمایه‌گذاری جدی کرد


از اونجا به بعد، یادگیری عمیق دیگه وارد دوران طلایی شد و سیلی از مدل‌های جدید (ResNet، GAN، ترنسفورمر) پشت سر هم معرفی شدن. 🌊
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 🔥 6
Post #667 616
تله پایتون!!!!

میخوایم امروز بزرگترین تله ای که تو مسیر یادگیری علم داده و هوش مصنوعی سر راهت قرار داره رو بهت معرفی کنیم.

این تله، همه کسانی که این مسیر رو شروع کردن یا قصد شروع دارن رو تهدید میکنه.

یعنی چی؟؟؟
تله پایتون یعنی کمالگرایی و گیر کردن روی پایتون قبل از شروع مباحث علم داده‌
❌ یعنی هدر دادن پول، زمان و انرژی
❌ یعنی دلسرد شدن و ناامیدی

🔴 شما نیاز نیست غول پایتون باشید.

✅ راه حلش چیه؟
ما برای افرادی که میخوان از صفر شروع کنن و به تخصص در هوش مصنوعی برسن دوره ای طراحی کردیم که هیچ پیشنیازی نداره.

ابتدای این دوره دقیقا به همون مقدار که پایتون لازم داری بهت آموزش میدیم نه بیشتر نه کمتر.

🔴 لینک دسترسی به دوره

📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • ❤ 4
  • 😍 1
Post #666 601
🚀 تسلا دوجو: اَبَرکامپیوتری که قرار بود AI را متحول کنه!

تسلا Dojo یک اَبَرکامپیوتر رویایی بود! ساخته شد تا میلیون‌ها ساعت ویدیوی رانندگی واقعی رو پردازش کنه، مدل‌های Full Self‑Driving رو تربیت کنه و حتی مسیر ساخت ربات‌های انسان‌نما رو هم هموار کنه. همه منتظر بودن این پروژه، انقلاب AI تسلا باشه 🧠.

💡 موفقیت‌ها و اهداف دوجو
سخت‌افزار اختصاصی D1 با معماری Wafer‑Scale، سرعت و قدرت پردازش فوق‌العاده.

امکان آموزش مدل‌های هوش مصنوعی در مقیاس اگزافلاپی.

تسلا می‌خواست با این سیستم، رانندگی خودران واقعی و حتی ربات‌های پیشرفته بسازه بدون اتکا به دیگر شرکت‌ها.
⚠️ سقوط و شکست بزرگترین رویای تسلا
اما رویای دوجو خیلی زود به زمین خورد:

مهندسان و تیم‌های کلیدی پروژه رو ترک کردند و بخش زیادی از استعدادهای AI به دنبال استارتاپ های دیگه رفتن.

طراحی پیچیده و محدودیت‌های فنی، سرعت پیشرفت رو کند کرد و هزینه‌ها سر به فلک کشید.

نتیجه؟ تسلا مسیرش رو به سخت‌افزارهای Nvidia و AMD تغییر داد و Dojo کنار گذاشته شد.

این تجربه ثابت کرد حتی بزرگ‌ترین رؤیاهای AI وقتی با چالش‌های فنی و انسانی روبه‌رو می‌شن، همیشه موفق نمی‌شن. گاهی ترکیب نوآوری داخلی با راهکارهای آماده خارجی مسیر بهتری‌عه 🧠.
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 🔥 7
Post #665 637
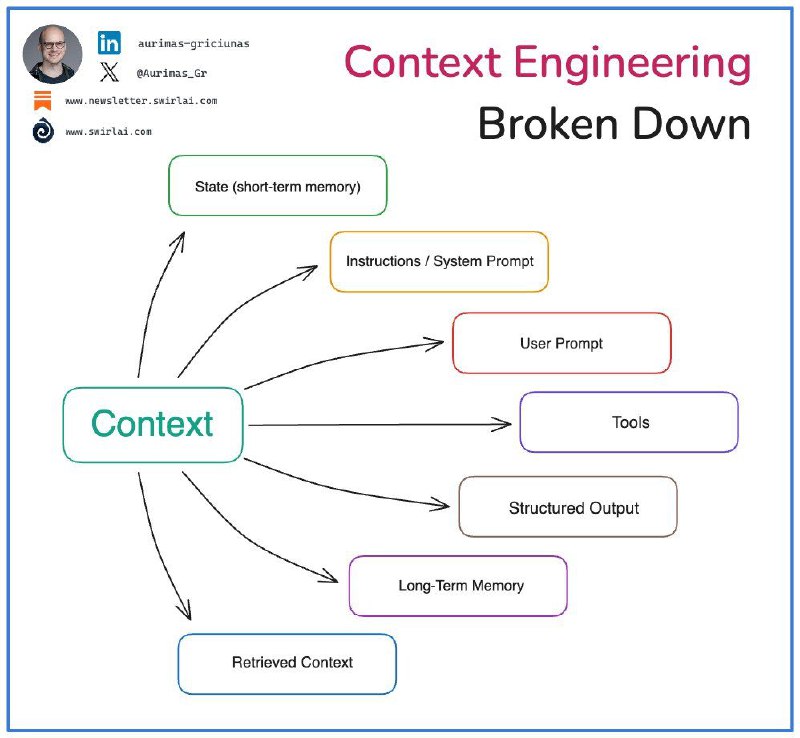
🧩 مهندسی کانتکست دقیقا چیه؟

همه‌ی خروجی‌های مدل زبانی از چیزی به نام کانتکست (Context) میاد؛ یعنی اطلاعاتی که مدل همون لحظه در دسترس داره. این کانتکست فقط پرامپت کاربر نیست، بلکه شامل system prompt، حافظه کوتاه‌مدت و بلندمدت، ابزارها و داده‌های بازیابی‌شده هم می‌شه. ⚙️
مهندسی کانتکست یا Context Engineering یعنی طراحی و مدیریت همین ورودی‌ها تا خروجی مدل دقیق‌تر، مرتبط‌تر و قابل اعتمادتر بشه. 🧠

📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • ❤ 2
  • 🔥 1
Post #664 641
🚀 آموزش هوشمند ایجنت با ART

یه خبر خوب برای کسایی که با LLM کار می‌کنن: پروژه‌ی OpenPipe/ART اومده تا آموزش عامل‌های هوش مصنوعی رو خیلی ساده‌تر کنه. با این ابزار می‌تونید عامل‌ها رو با Reinforcement Learning اموزش بدید، بدون دردسر طراحی تابع پاداش دستی. 🧠

✨ نقطه‌ی خاص این پروژه، مکانیزم RULER ـه. یعنی به‌جای شما، یه مدل زبانی (LLM) نقش داور رو بازی می‌کنه و به عملکرد عامل امتیاز می‌ده. اینطوری نیاز به داده‌های آماده یا مهندسی پیچیده از بین می‌ره.

⚙️ ابزار ART خیلی راحت نصب می‌شه (pip install openpipe-art) و از مدل‌های معروف مثل Qwen و LLaMA هم پشتیبانی می‌کنه. معماریش هم طوری طراحی شده که با یه کلاینت ساده روی سرور GPU اجرا بشه. همین الان بیش از ۶.۵K استار توی گیت‌هاب گرفته.
🔗 لینک ریپو ART
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 🔥 2
Post #663 623
🚀 ویدیوی بلادرنگ با Krea AI

استارتاپ Krea AI اولین مدل تولید ویدیو Real-Time رو معرفی کرده؛ مدلی که می‌تونه با سرعت بیش از ۱۲ فریم بر ثانیه ویدیو بسازه و همزمان ثبات فریم‌ها رو حفظ کنه. شما می‌تونید با نوشتن متن، کشیدن روی بوم یا استریم از وب‌کم، خروجی رو لحظه‌ای تغییر بدید. این قابلیت فعلاً در نسخه بتا و از طریق Waitlist در دسترسه. 🎥

🔗 لینک معرفی
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 🔥 5
Post #662 689
🚀 واقعیت پشت "هوش مصنوعی که کد خودش رو می‌نویسه"

تا حالا توی فیلم‌ها دیدی یه هوش مصنوعی بشینه سورس‌کد خودش رو تغییر بده و قوی‌تر بشه؟ خب راستشو بخوای این تصویر بیشتر فانتزیه تا واقعیت. 🧠

🤖 هوش مصنوعی و دستکاری خودش
در دنیای واقعی، AI مثل یه نرم‌افزار معمولیه: یه سری کد که روی سرور اجرا می‌شه. این سیستم‌ها نمی‌تونن همینطوری برن فایل‌های خودشون رو تغییر بدن، چون نیاز به سطح دسترسی بالا و کنترل بیرونی دارن.
🛠️ پس چی نزدیک به این ایده‌ست؟
اول- Self-modifying code: کدهایی که می‌تونن در زمان اجرا خودشون رو تغییر بدن. (خیلی نادر و پرریسک)

دوم- AutoML: الگوریتم‌هایی که معماری مدل‌ها رو خودشون بهینه می‌کنن. این نزدیک‌ترین مثال به “بازنویسی خودش” هست.

سوم- Reinforcement Learning: یادگیری تدریجی که باعث می‌شه AI استراتژی‌هاشو بهتر کنه، بدون تغییر مستقیم سورس‌کد.
🔒 چرا هنوز تخیلیه؟
چون اجازه دادن به یک سیستم برای تغییر فایل‌ها و کدهای خودش می‌تونه فاجعه‌بار باشه. امنیت، کنترل و پایداری این وسط به خطر می‌افته. برای همین پژوهشگرها با احتیاط زیادی سراغ این ایده می‌رن.
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 🔥 5
Post #661 725
💥دوره جامع نخبگان پایتون:

شرایط پرداخت اقساط + تخفیف
این یه دوره جامع و یک جعبه ابزار کامل برای علاقه مندان به برنامه نویسی پایتونه.
از مفاهیم پایه شروع شده و تا مهارت‌های پیشرفته برنامه‌نویسی و توسعه نرم افزار رو پوشش میده.

📚در واقع ۵ تا دوره در کنار هم این دوره جامع رو تشکیل دادن:
✅ دوره صفرتاصد پایتون
✅ آموزش رابط گرافیکی PyQt6
✅ آموزش دیتابیس SQL
✅ مقدمات پایتون در علم داده
✅ آموزش Git
1️⃣ تو بخش اول از ابتدایی ترین مفاهیم پایتون مثل ساختارهای کنترلی، توابع، لیست‌ها، دیکشنری‌ها و ... شروع میکنیم تا مفاهیم پیشرفته مثل شی گرایی.
2️⃣ تو بخش دوم با استفاده از PyQt6 یادمیگیریم چطور برای دسکتاپ رابط گرافیکی حرفه ای بسازیم.
3️⃣ تو بخش سوم یادمیگیریم چطور از پایگاه داده استفاده کنیم و چطور داده هارو مدیریت و استخراج کنیم.
4️⃣ تو بخش چهارم کتابخونه های اولیه برای ورود به علم داده و یادگیری ماشین مثل numpy , pandas قرار داره.
5️⃣ بخش پنجم هم اصول اولیه و پیشرفته Git رو یادمیگیریم.

🌐 صفحه دوره تو سایت دیتایاد

📞  درخواست مشاوره رایگان

📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 👏 4
Post #660 665
⏳ ظهور شبکه‌های بازگشتی و LSTM

بعد از اینکه CNNها توی تصاویر موفق شدن، یه سؤال جدی پیش اومد: خب حالا با داده‌های ترتیبی مثل زبان و صدا چی کار کنیم؟ 🤔

🔄 شبکه‌های بازگشتی (RNN)
برای همین RNNها معرفی شدن. ایده‌شون ساده بود: خروجی هر مرحله برگرده به ورودی مرحله بعد. این‌طوری شبکه یه جور «حافظه کوتاه‌مدت» پیدا می‌کرد و می‌تونست ترتیب داده‌ها رو بفهمه.
کاربردش؟ ترجمه، تشخیص صدا، پیش‌بینی سری‌های زمانی.

⚠️ مشکل اصلی
ولی یه دردسر بزرگ داشتن: مشکل محو شدن گرادیان. یعنی وقتی جمله طولانی می‌شد، شبکه یادش می‌رفت اول جمله چی بوده.
💡 راه‌حل: LSTM
سال ۱۹۹۷ یه معماری جدید معرفی شد به اسم LSTM. با کمک «سلول حافظه» و «دروازه‌ها» می‌تونست اطلاعات مهم رو برای مدت طولانی نگه داره. همین شد که پردازش زبان طبیعی یه جهش اساسی پیدا کرد.
🚀 اهمیت RNN و LSTM
قبل از اینکه ترنسفورمرها بیان، تقریبا همه‌ی سیستم‌های NLP جدی (حتی ترجمه گوگل) با RNN و LSTM ساخته می‌شدن.
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 👍 4
  • 🔥 1
  • 🗿 1
Post #659 770
⚡ چرا مدل‌های زبانی اینقدر پرمصرفن؟

برای آموزش GPT-3 تخمین زده می‌شه بیش از ۳۵۰ گیگاوات‌ساعت انرژی مصرف شده؛ چیزی در حد مصرف یک شهر کوچک در یک سال! اما چرا؟؟ 🧠

🖥️ میلیاردها پارامتر
مدل‌های زبانی در واقع ماتریس‌های غول‌پیکری هستن با صدها میلیارد پارامتر. هر بار که یک "Batch" داده پردازش می‌شه، این پارامترها با الگوریتم‌هایی مثل Backpropagation به‌روز می‌شن. یعنی برای هر قدم آموزشی (Iteration)، تریلیون‌ها عمل ضرب و جمع ماتریسی روی GPUها انجام می‌شه.
💾 دیتای عظیم
برای اینکه مدل واقعا زبان رو بفهمه، باید روی صدها میلیارد توکن متن آموزش ببینه. این یعنی هر بار پردازش کل این حجم، حافظه و محاسبات سنگینی نیاز داره. علاوه بر اون، حرکت مداوم داده بین حافظه (RAM/VRAM) و پردازنده هم خودش یکی از منابع اصلی مصرف انرژی‌عه.
🔧 سخت‌افزار ویژه
چنین بار محاسباتی فقط روی شتاب‌دهنده‌هایی مثل GPU و TPU قابل اجراست. مثلا NVIDIA A100 یا H100، که هر کدوم صدها وات برق مصرف می‌کنن. حالا تصور کن هزاران عدد از این کارت‌ها در یک خوشه (Cluster) کنار هم کار کنن؛ نتیجه، مصرف انرژی در مقیاس یک نیروگاه کوچیکه.
پس بخش اصلی مصرف بالا به فرایند Training برمی‌گرده، نه به استفاده‌ی روزمره مثل پرسیدن سوال از مدل.

📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 🔥 7
  • 🗿 3
Post #658 910
🚀 ابزار FastAPI-MCP؛ پلی بین FastAPI و AI

خیلیا فکر می‌کنن وصل کردن API به مدل‌های هوش مصنوعی دردسر داره. FastAPI-MCP کاری می‌کنه همون endpointهای فعلی‌ت، بی‌واسطه و استاندارد، در اختیار مدل قرار بگیره—بدون دردسر و کدنویسی اضافه. 🧠

🛠 کاربردش چیه؟ API به زبان مدل
ایده‌ش خیلی ساده‌ست: شما خروجی همون API رو مستقیم به مدل می‌دین. یعنی نیازی نیست چیزی رو بازنویسی یا تبدیل کنید، خود FastAPI-MCP با استفاده از Schema و مستندات API همه چیز رو به زبان قابل‌فهم برای مدل درمیاره. نتیجه؟ مدل می‌تونه endpointهای شما رو مثل یک ابزار صدا بزنه، داده رو بخونه، نتیجه برگردونه و حتی توی فرآیندهای پیچیده‌تر مثل سفارش آنلاین یا مدیریت کاربر استفاده بشه—اونم بدون دردسر اضافه.
🔗 لینک ریپو FastAPI-MCP
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 🔥 5
Post #657 1.32K
🚀 دوره رایگان Machine Learning از مایکروسافت.

🎯 هدف: یادگیری اصول ML به شکل پروژه‌محور و عملی، حتی بدون تجربه قبلی.

🟢 نحوه دسترسی:
1️⃣ وارد این لیک شو:
👉 ML for Beginners – GitHub

2️⃣ بعد از بالا سمت راست گزینه fork رو بزن

3️⃣ دکمه Code → HTTPS رو بزن و لینک رو کپی کن.
4️⃣ ترمینال رو باز کن و اون لینک رو بعد از دستور git clone اجرا کن.
git clone https://github.com/microsoft/ML-For-Beginners.git

5️⃣ فایل‌ها روی سیستم ذخیره می‌شن و آماده مطالعه هستن.
🔴 نحوه مطالعه و استفاده از دوره:
قدم ۱ – پیش‌کوییز: قبل از شروع هر درس، سطح اولیه خودت رو بسنج
قدم ۲ – مطالعه درس: متن و مثال‌ها رو با دقت بخون.
قدم ۳ – اجرای پروژه‌ها: تمرین‌ها و پروژه‌ها رو خودت انجام بده، بعد راه‌حل داخل solution ببین.
قدم ۴ – پس‌کوییز و چالش: کوییز نهایی و چالش‌ها رو انجام بده تا دانشت تثبیت بشه.
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • ❤ 6
Post #656 851
🚫 هوش مصنوعی مخترع نیست!

خیلی‌ها انتظار دارن «عصر هوش مصنوعی» مثل یک ماشین جادویی باشه که هر روز یه تکنولوژی جدید خلق کنه. اما واقعیت فرق داره 🧠

✨ هوش مصنوعی فقط روی دانشی کار می‌کنه که انسان‌ها قبلاً کشف کردن. یعنی می‌تونه الگوها رو ترکیب کنه، پیش‌بینی کنه یا توضیح بده، ولی خودش به معنای واقعی «خلاق» نیست.

📚 داده‌هایی که به AI داده میشه، همه حاصل علم و تجربه انسان‌هاست؛ پس خروجی اون هم محدود به همین دانسته‌هاست.

🔍 مثال ساده؟ ChatGPT یا مدل‌های مشابه، نمی‌تونن یک قانون فیزیکی جدید یا یک عنصر شیمیایی ناشناخته اختراع کنن. فقط می‌تونن چیزهایی رو که هست بهتر توضیح بدن یا کاربرد جدیدی براش پیدا کنن.

📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 👍 3
Post #655 973
دوره آموزش علم داده و هوش مصنوعی باید پروژه محور باشه؟

جواب کوتاه اینه : بله.
اما این شرط لازمه ولی کافی نیست.

علم داده و هوش مصنوعی دارای مفاهیم بسیار مهم و عمیقی هست. اصلا این کار حجم کد بالایی نداره ولی پشت هر خط کد کلی مفهوم هست.

پس مهمتر از پروژه محور بودن، پرداختن درست به مفاهیمه.

تمامی آموزش های دیتایاد شامل سه مرحله مهم هست.

1️⃣ آموزش مفاهیم فارغ از کدنویسی
2️⃣ پیاده سازی مفاهیم در پایتون و تکمیل مفاهیم
3️⃣ تمرین و پروژه


پس اول به مفاهیم مسلط میشی و بعد هم هیچ مبحثی رو بدون تمرین و پروژه رد نمیکنی.
یک تیر و چند نشان🎯

🔴 نمیدونی از کجا شروع کنی مشاوره رایگان مارو از دست نده.

☎️ تلفن تماس : 09905501998
📞  درخواست مشاوره رایگان

📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 👏 4
  • 👍 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →