TGViewer
Channel Public Channel
Data Scientist | ML & AI

Data Scientist | ML & AI

@datascience_tg

Один из ведущих каналов по Data Science, Machine Learning и Big Data

Сотрудничество: @bape_ads
Прайс: @bape_media
Subscribers
3.05K
Photos
620
Videos
211
Links
699

Showing posts older than #628 · Back to latest

Older Posts 17 shown
Post #627 975
🤖 Как я запускаю 15+ самых разных ИИ на своей машине?

В статье рассказывается о разработке локального сервиса, который объединяет более 15 open-source моделей ИИ для генерации изображений, распознавания объектов, озвучивания текста и других задач.

Автор показывает, как собрать такой инструмент у себя на машине, настроить взаимодействие моделей и получить к ним удобный HTTP-доступ.

⛓ Читать статью

tags: #статья

➡ Data Scientist | Чат
  • ❤ 2
  • 🔥 1
Post #626 974
📱 Pycaret: кратко про low-code библиотеку для ML

В статье рассматривается, как использовать PyCaret для создания, обучения и внедрения моделей машинного обучения с минимальным количеством кода.

Автор описывает основные модули библиотеки, демонстрируя их возможности с примерами кода.

⛓ Читать статью

tags: #статья

➡ Data Scientist | Чат
  • ❤ 3
  • 🔥 1
Post #625 972
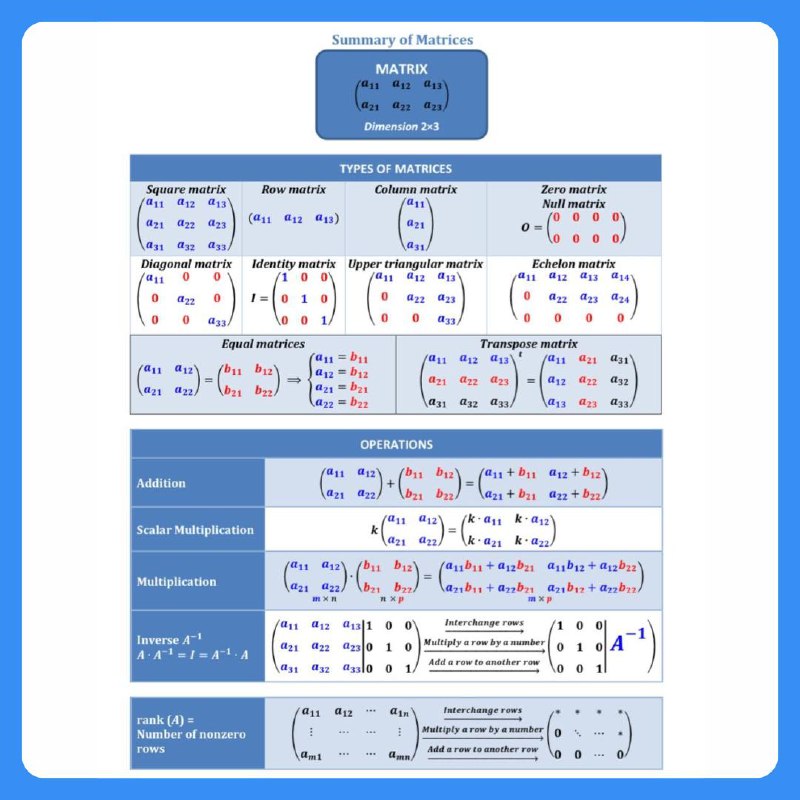
🔖 Шпаргалка по матрицам: основные виды и ключевые операции

На одной картинке — полный набор: квадратные, нулевые, диагональные, единичные, треугольные и другие типы матриц, а также базовые действия вроде сложения, умножения, транспонирования, обратной матрицы и ранга.

tags: #полезное #шпаргалка

➡ Data Scientist | Чат
  • ❤ 3
  • 🔥 3
  • 👍 2
Post #624 1.03K
Фундаментальный закон

➡ Data Scientist | #memes
  • ❤ 9
  • 👍 1
Post #622 1.25K
algorithm cheat-sheet by Data Secrets.pdf1.4 MB
🔖 Шпаргалка по выбору алгоритма машинного обучения

Нашли удобную карту, которая поможет выбрать подходящий алгоритм под задачу — от классификации и регрессии до кластеризации и снижения размерности.

Она показывает как шаг за шагом выбрать подход: какие параметры учитывать и к какому алгоритму в итоге прийти.

tags: #полезное #шпаргалка

➡ Data Scientist | Чат
  • ❤ 2
  • 🔥 2
Post #621 917
Монетизировать можно всё что угодно — главное уметь 😉

➡ Data Scientist | #memes
  • 😁 6
  • 🤣 3
Post #619 927
📰 «Тупой ИИ» с нами надолго: почему в новых моделях больше галлюцинаций

Модели последнего поколения получили режимы рассуждений и выросли в вычислительных возможностях, но при этом стали чаще выдавать неверные факты. Тесты показывают, что увеличение параметров и данных не устраняет галлюцинации и даже усиливает их.

В статье объясняется, какие ограничения трансформеров приводят к росту ошибок, почему масштабирование не улучшает надёжность и откуда берутся случаи осознанного искажения ответов.

Что вы узнаете из статьи:
▶️ Почему o3, o4-mini и DeepSeek-R1 ошибаются в 2–3 раза чаще предыдущих моделей;

▶️ Как работает стратегическое искажение ответов и почему модели меняют поведение под наблюдением;

▶️ Почему reasoning-модели проваливаются на задачах вне обучающей выборки;

▶️ Как возникает коллапс моделей при обучении на собственных данных;

▶️ Какие фундаментальные ограничения мешают LLM стать полноценным ИИ.


Интересный обзор, который поможет понять реальные границы современных моделей и причины роста галлюцинаций.

➡ Читать статью

tags: #статья

➡ Data Scientist | Чат
  • ❤ 3
  • 🔥 2
Post #618 909
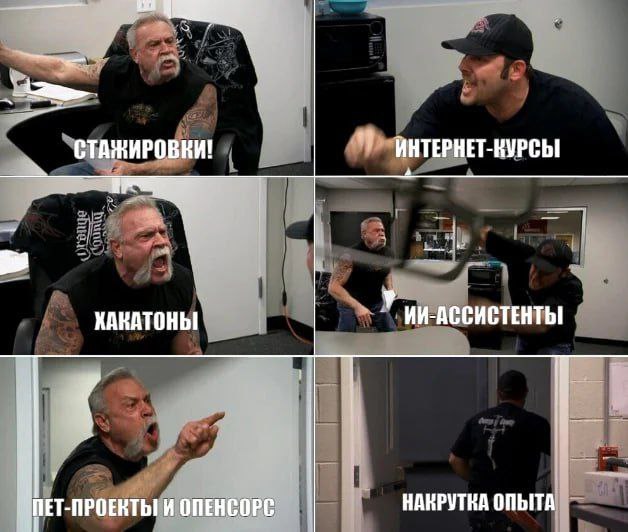
Тяжело нынче джунам

➡ Data Scientist | #memes
  • 😢 7
  • ❤ 1
  • 💯 1
Post #616 976
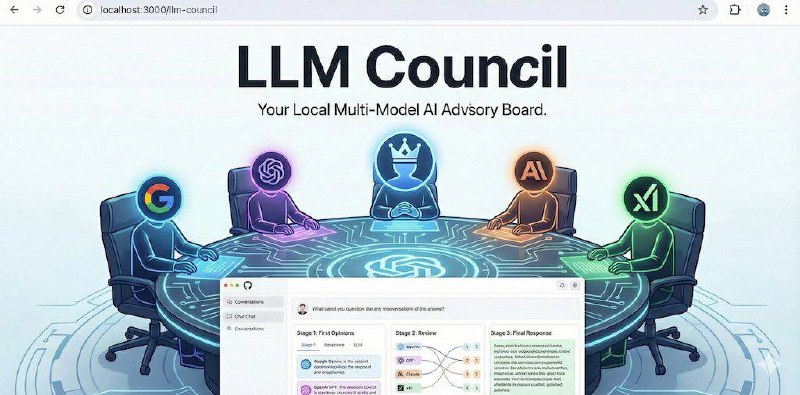
📰 Андрей Карпаты запустил новый проект — консилиум LLM

Инструмент работает как ChatGPT, но ваш запрос разбирают сразу несколько моделей.

Это не просто «ансамбль», а полноценный совет нейронок, где каждая участвует в обсуждении.

Как устроено:
▶️ Через OpenRouter запрос уходит сразу нескольким моделям: GPT-5.1, Gemini 3 Pro, Claude Sonnet 4.5, Grok 4. Каждая пишет свой ответ.

▶️ Затем всем показывают анонимные ответы друг друга — модели ранжируют их, комментируют и указывают, что именно стоит улучшить.

▶️ После этого весь собранный контекст передаётся «председателю» LLM, который формирует итоговый, взвешенный ответ.


Интересно, что модели часто выбирают не свой ответ. GPT-5.1 почти всегда называют сильнейшим участником совета, а Claude — самым слабым.

Исходный код и демо — здесь.

tags: #новости

➡ Data Scientist | Чат
  • ❤ 2
  • 🔥 2
Post #615 816
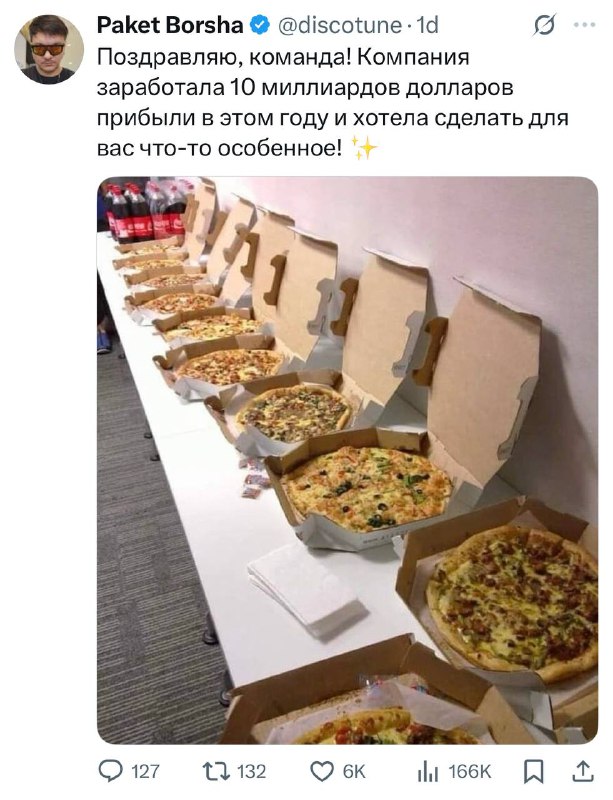
Что-то больно щедро

➡ Data Scientist | #memes
  • ❤ 4
  • 😁 2
Post #613 807
📰 LLM в науке. Используем LLM в анализе эксперимента

Можно ли доверить анализ научного эксперимента самой нейросети? В этой статье исследователь проверяет влияние LLM на креативность студентов — и заодно использует LLM для обработки данных, расчётов и проверки гипотез.

Автор подробно разбирает, как большие языковые модели справляются с научными задачами, где они ошибаются, и почему даже самые точные вычисления могут давать ложные выводы без человеческого контроля.

Что вы узнаете в статье:
▶️ Как LLM помогла провести реальный эксперимент о влиянии искусственного интеллекта на креативность студентов;

▶️ Какие метрики — беглость, гибкость, оригинальность — использовались для анализа данных;

▶️ Почему ИИ не повышает, но и не снижает креативность, а меняет сам подход к генерации идей;

▶️ Как LLM действует как фильтр, убирая банальные ответы и усиливая сильных участников;

▶️ Почему доверять вычислениям нейросети без проверки опасно даже в академической среде.


В статье показано, как LLM может стать мощным инструментом научного анализа — но только при критичном подходе и осознанном контроле исследователя.

➡ Читать статью

tags: #статья

➡ Data Scientist | Чат
  • 🔥 3
  • ❤ 1
Post #609 1.2K
🗂 Шпаргалка по нейросетям

В ней наглядно представлены все основные типы Neural Network, с краткой теорией и полезными советами по Python для работы с данными и машинным обучением.

По сути, это компиляция разных шпаргалок в одном удобном документе.

➡ Ссылка на шпаргалку

tags: #полезное

➡ Data Scientist | Чат
  • 🔥 2
  • ❤ 1
  • 👎 1
Post #606 957
📰 Сила оттенков серого: компьютерное зрение с нуля

В мире CV все обсуждают нейросети, OpenCV и готовые пайплайны, но почти никто не задумывается, что стоит под капотом этих инструментов.

Автор решил отбросить все зависимости и собрать компьютерное зрение «с нуля» — только на пикселях, свёртках и минимальном C-коде.

Что вы узнаете из статьи:
▶️ Как устроены операции над пикселями и свёртки для размытия, резкости и выделения границ;

▶️ Как работают thresholding (фиксированный, Otsu, адаптивный) и морфология;

▶️ Как находить blob, центры масс, ограничивающие прямоугольники и контуры;

▶️ Как реализованы FAST и ORB: углы, ориентация и бинарные дескрипторы;

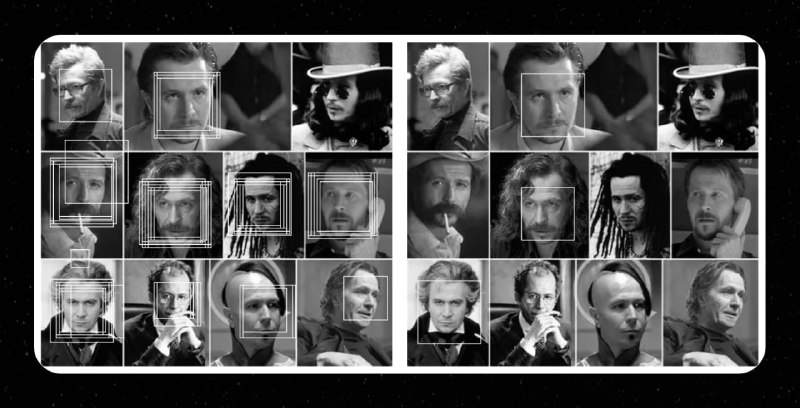
▶️ Как работают LBP-каскады для распознавания лиц без глубинных сетей.


Интересный обзор, который показывает, как из простых операций над пикселями вырастает полноценное компьютерное зрение.

➡️ Читать статью

tags: #статья

➡ Data Scientist | Чат
  • ❤ 1
  • 🔥 1
Post #605 1.04K
🤖 Курс по компьютерному зрению

На Hugging Face есть сильный вводный курс по компьютерному зрению — полностью бесплатный и с большим количеством практики.

Что разберёте в курсе:
▶️ Основы компьютерного зрения и типовые задачи;

▶️ Свёрточные нейронные сети и их архитектуры;

▶️ Визуальные трансформеры и современные модели;

▶️ Генеративные методы для работы с изображениями;

▶️ Анализ и обработку видео;

▶️ 3D-зрение, реконструкцию сцен и визуализацию;

▶️ Zero-shot подходы — классификация объектов без обучения;

▶️ Этические вопросы и ограничения CV-систем.


Материал покрывает ключевые концепции CV и показывает, как применять их в реальных задачах.

Ссылка на курс — здесь.

tags: #полезное

➡ Data Scientist | Чат
  • ❤ 6
  • 🔥 4
Post #604 938
📰 Что такое эмбеддинги и как с ними работать?

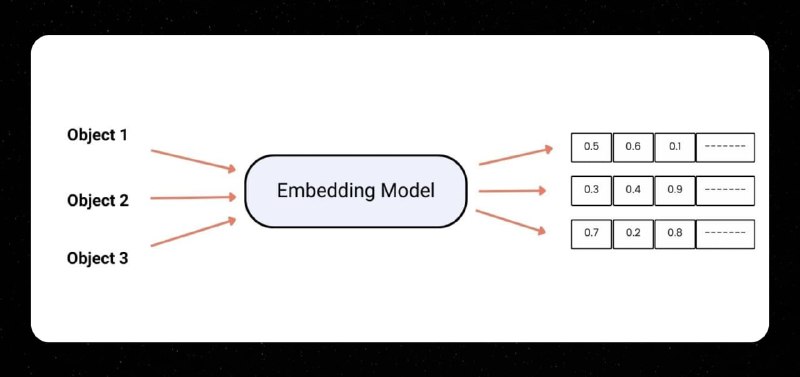
Эмбеддинги — это способ представить объекты (текст, картинки, аудио) в виде числовых векторов, с которыми можно работать математически.

Что вы узнаете в статье:
▶️ Что такое эмбеддинги и как они устроены с точки зрения векторного пространства;

▶️ Какие объекты можно преобразовать в эмбеддинги: текст, изображения, аудио и мультимодальные данные;

▶️ Как работать с расстояниями между векторами (евклидово, манхэттенское, косинусное);

▶️ Какие задачи можно решать с помощью эмбеддингов: классификация текстов, поиск по базе знаний, кластеризация.


В статье разобраны основные подходы к созданию эмбеддингов и примеры их применения на практике.

➡ Читать статью

tags: #статья

➡ Data Scientist | Чат
  • 🔥 2
  • ❤ 1
Post #602 1.19K
🤖 Один из лучших ресурсов для изучения Data Science и Machine Learning

На Kaggle собраны интерактивные курсы, которые помогут быстро разобраться в ключевых темах DS и ML.

Формат простой: короткие уроки, практические задания и сертификат по завершении — всё бесплатно.

Внутри:
• основы Python для анализа данных;
• машинное обучение и работа с моделями;
• pandas, SQL, визуализация;
• продвинутые техники и практические кейсы.

Каждый курс занимает всего 3–5 часов и сразу даёт практические знания для работы.

Ссылка на ресурс — здесь.

tags: #полезное

➡ Data Scientist | Чат
  • ❤ 4
  • 🔥 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →