TGViewer
Channel Public Channel
Data Scientist | ML & AI

Data Scientist | ML & AI

@datascience_tg

Один из ведущих каналов по Data Science, Machine Learning и Big Data

Сотрудничество: @bape_ads
Прайс: @bape_media
Subscribers
3.05K
Photos
622
Videos
211
Links
702

Showing posts older than #508 · Back to latest

Older Posts 16 shown
Post #506 1.26K
📰 Павел Дуров запускает ИИ-лабораторию в Казахстане

Telegram готовит технологию на стыке ИИ и блокчейна, которая, по словам Дурова, позволит «миллиарду юзеров использовать искусственный интеллект эффективно и приватно».

За проект возьмётся новая лаборатория Alem AI, которая будет работать в связке с казахстанским суперкомпьютером на ~400 GPU NVIDIA H200.

➡ Ссылка на новость

tags: #новости

➡ Data Scientist | Чат
  • 🔥 16
  • ❤ 5
  • 👍 2
Post #503 1.3K
📰 Claude Sonnet 4.5 — свежий апдейт от Anthropic

Anthropic выкатили топовую модель для кодинга: Sonnet 4.5 обгоняет GPT-5 во всех бенчмарках по программированию, а в остальных задачах идёт почти наравне.

Что изменилось в Claude Code:
▶️ В VS Code появилось расширение с удобной интеграцией — теперь писать и дебажить проще

▶️ Терминал стал дружелюбнее: быстрее, чище и с новым интерфейсом

▶️ Появилась «машина времени»: можно откатиться к любому чекпоинту или шагу назад

▶️ Агент в терминале научился сам создавать файлы, таблицы и даже диаграммы на основе ваших данных


➡ Подробнее про апдейт

tags: #новости

➡ Data Scientist | Чат
  • ❤ 3
  • 🔥 2
Post #501 1.29K
📰 Промптинг и суеверия. Что (не) надо добавлять к запросу в ChatGPT

Вокруг промптинга давно крутятся советы вроде «добавь эту фразу — и модель станет умнее».

Однако исследование в статье показывает: большинство таких приписок бесполезны или дают эффект только в узких случаях.

Что вы узнаете в статье:
▶️ Работает ли приём «давай думать пошагово» и почему его эффект уменьшается в новых моделях

▶️ Когда эмоциональные добавки помогают креативности, а когда они бесполезны

▶️ Что происходит с качеством ответа, если упоминать срочность или обещать «чаевые»

▶️ Как вежливость и тон общения влияют на результат диалога с моделью

▶️ Какие приёмы реально повышают качество ответа и делают промпт более эффективным


Итог: эффективность промпта зависит не от красивых приписок, а от того, насколько ясно и конкретно поставлена задача.

➡ Читать статью

tags: #статья

➡ Data Scientist | Чат
  • ❤ 2
  • 🔥 2
Post #500 1.39K
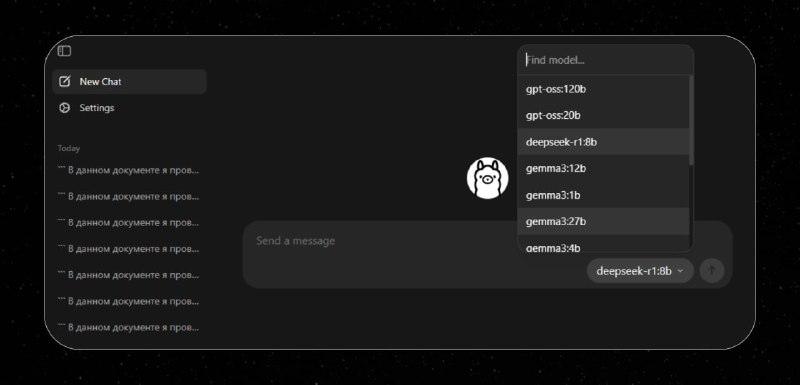
📰 Локальные LLM модели: обзор и тестирование

Большие языковые модели перестали быть только облачными сервисами — сегодня многие из них можно запускать прямо на обычном ПК.

В статье собран практический обзор популярных локальных моделей и результаты их тестирования в реальных сценариях.

Что внутри:
▶️ В чем преимущества локальных LLM по сравнению с облачными: конфиденциальность, доступность, бесплатный API, корпоративные сценарии;

▶️ Как работать с Ollama: загрузка моделей, запуск через чат и API, управление через терминал;

▶️ Сравнительное тестирование моделей (Mistral, Llama 3.1, Qwen, Gemma, GPT-OSS, DeepSeek) на задачах фактологии, математики, кода и текста;

▶️ Результаты по скорости и точности: где локальные модели справляются лучше, а где уступают облачным;

▶️ Практические выводы — для каких задач подходят быстрые «легкие» модели, а где уместны более крупные и «думающие» варианты.


Материал будет полезен тем, кто хочет разобраться в локальных альтернативах ChatGPT и протестировать их в боевых условиях.

➡ Читать статью

tags: #статья

➡ Data Scientist | Чат
  • ❤ 6
  • 🔥 2
Post #499 1.17K
Блог владельца «Data Scientist»

Жизнь в Telegram и за его пределами, бизнес на каналах и никакого программирования:

https://t.me/+erFDhr6H1bgxZGZi
Post #498 1.4K
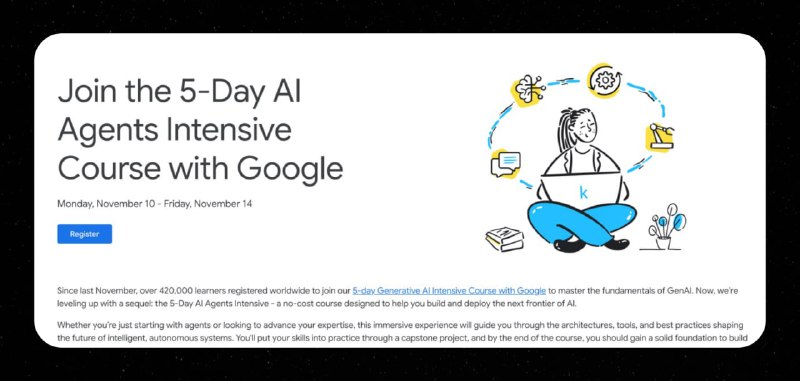
🔖 Google и Kaggle запускают бесплатный онлайн-интенсив по AI-агентам

Всего за 5 дней вы разберётесь в основамах и соберёте своего первого работающего агента:
▶️ Поймёте ключевые принципы и архитектуру агентов;

▶️ Развернёте собственный MCP-сервер;

▶️ Создадите агента с нуля;

▶️ Научите его выполнять реальные задачи, а не абстрактные примеры.


Интенсив стартует 10 ноября, зарегистрироваться можно — тут.

tags: #полезное

➡ Data Scientist | Чат
  • 🔥 5
  • ❤ 3
Post #494 1.41K
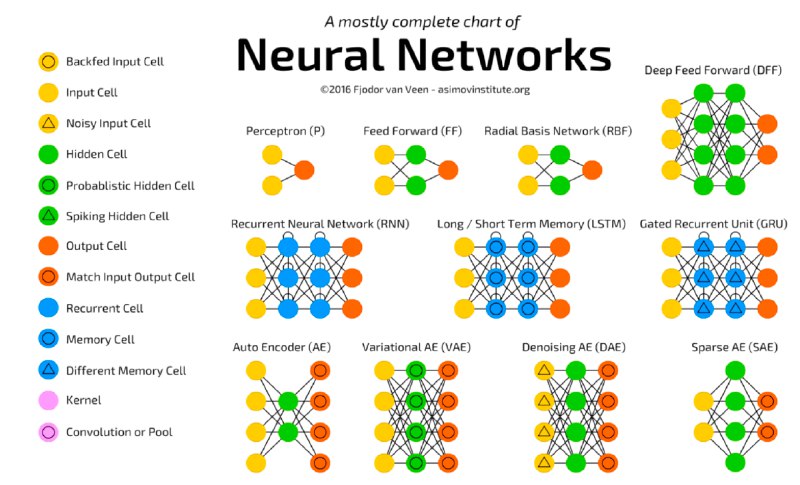
🗂 Шпаргалка по нейросетям

В ней наглядно представлены все основные типы Neural Network, с краткой теорией и полезными советами по Python для работы с данными и машинным обучением.

По сути, это компиляция разных шпаргалок в одном удобном документе.

➡ Ссылка на шпаргалку

tags: #полезное

➡ Data Scientist | Чат
  • ❤ 1
  • 🔥 1
Post #493 1.11K
🗂 Подборка материалов для реализации ML-алгоритмов

Делимся репозиторием с Google Colab-ноутбуками, где показано, как шаг за шагом реализовать классические алгоритмы машинного обучения с нуля.

Каждый ноутбук — это не только код, но и разбор идей: от линейной регрессии и деревьев решений до градиентного бустинга и нейросетей.

➡ Ссылка на GitHub

tags: #полезное

➡ Data Scientist | Чат
  • ❤ 3
  • 🔥 3
Post #492 1.23K
📰 Что такое эмбеддинги и как с ними работать: вводная для начинающих

Эмбеддинги — это способ представить объекты (текст, картинки, аудио) в виде числовых векторов, с которыми можно работать математически.

В статье разобраны основные подходы к созданию эмбеддингов и примеры их применения на практике.

Что вы узнаете в статье:
▶️ Что такое эмбеддинги и как они устроены с точки зрения векторного пространства;

▶️ Какие объекты можно преобразовать в эмбеддинги: текст, изображения, аудио и мультимодальные данные;

▶️ Как работать с расстояниями между векторами (евклидово, манхэттенское, косинусное);

▶️ Какие задачи можно решать с помощью эмбеддингов: классификация текстов, поиск по базе знаний, кластеризация.


Статья даёт базовое понимание эмбеддингов и показывает, как начать использовать их в реальных проектах.

➡ Читать статью

tags: #статья

➡ Data Scientist | Чат
  • ❤ 2
  • 👍 2
  • 🔥 2
Post #490 1.28K
📰 Как спрогнозировать спрос на самокаты и не захламить город, версия Whoosh

Равномерная расстановка электросамокатов в городе кажется простым решением, но на практике приводит к неудобствам для пользователей и росту расходов для операторов.

Чтобы сделать микромобильный транспорт доступным и при этом не перегрузить городскую среду, команда Whoosh разработала алгоритм прогнозирования спроса на самокаты.

Что вы узнаете в статье:
▶️ Почему традиционные подходы (Excel, скользящее среднее) не работают в долгосрочной перспективе;

▶️ Как собранные данные и их особенности влияют на построение ML-модели;

▶️ Какие модели (SARIMAX, LightGBM, Prophet, NeuralProphet) тестировались и с какими результатами;

▶️ Почему финальный выбор пал на Prophet и как модель учитывает сезонность и дополнительные факторы;

▶️ Как прогнозы старта и финиша поездок превращаются в алгоритм ребаланса для операторов.


В статье показано, как подход машинного обучения помог эффективно управлять флотом самокатов и облегчил работу команды Whoosh.

➡ Читать статью

tags: #статья

➡ Data Scientist | Чат
  • 👍 2
  • ❤ 1
  • 🔥 1
Post #489 1.23K
📰 Основы обучения и тестирования моделей нейросетей

Cтатья объясняет, как устроены процессы обучения и тестирования моделей. Разбирается, почему важно правильно делить данные, какие ошибки чаще всего допускают новички и как от этого зависит точность прогноза.

➡ Ссылка на статью

tags: #статья

➡️ Data Scientist | Чат
  • ❤ 3
Post #488 1.38K
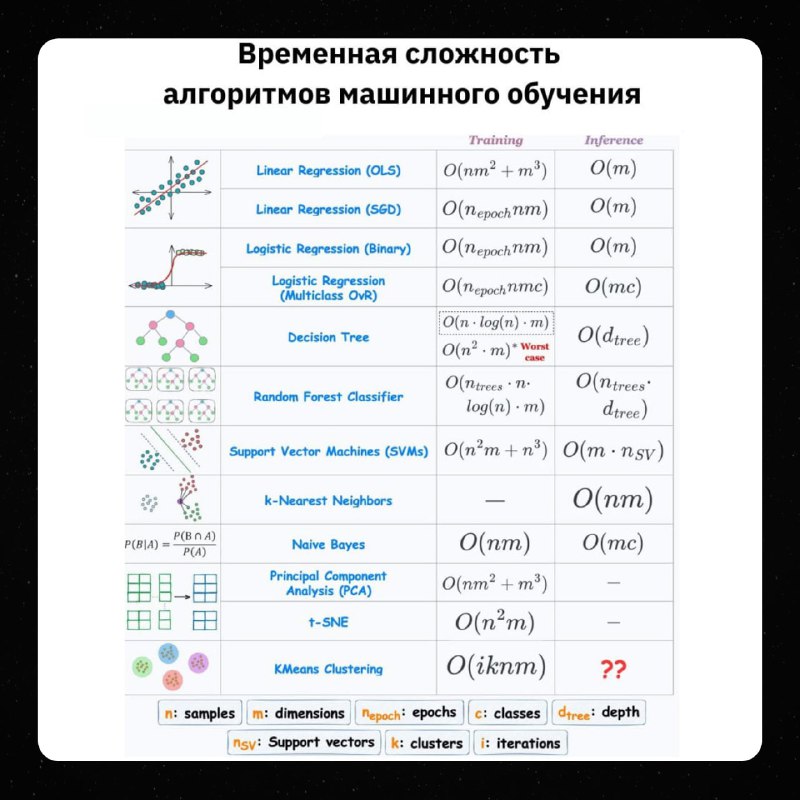
🔥 Шпаргалка по алгоритмам в Machine Learning

На шпаргалке изображены 10 алгоритмов и их временная сложность — удобно, чтобы всегда держать под рукой.

tags: #шпаргалка

➡️ Data Scientist | Чат
  • 👍 9
  • ❤ 2
  • 🔥 1
  • 🤯 1
Post #486 1.48K
🔖 Тренируем мозги с задачами по ML и AI

Два незаменимых ресурса для практики в машинном обучении и нейросетях:

▶️ Deep-ML — задачи по линейной алгебре, машинному и глубокому обучению. Подходит для постепенного погружения.

▶️ Tensorgym — упражнения разного уровня сложности, чтобы закрепить теорию и прокачать практику.

Идеально подойдёт, если хотите подтянуть навыки и разобраться в тонкостях ML.

tags: #полезное

➡️ Data Scientist | Чат
  • 🔥 4
  • 👍 2
Post #484 1.26K
📰 Локальный AI: запуск языковых моделей у себя дома

Статья объясняет, зачем и как запускать LLM (языковые модели) на собственном компьютере — так, чтобы не зависеть от облачных API и иметь полный контроль над данными и затратами.

Основные тезисы:
▶️ Какое «железо» подойдёт: примеры сборок — от ноутбука до мощных GPU, с оценкой объёма видеопамяти (VRAM) как одной из ключевых характеристик;

▶️ Технологии и оптимизации: квантизация моделей, формат GGUF, компромисс между точностью и нагрузкой на железо;

▶️ Программное обеспечение: GUI-инструменты вроде LM Studio, Jan, GPT4All, CLI-решения типа Llama.cpp и Oobabooga, интерфейсы, подсказки по совместимости с оборудованием;

▶️ Сообщество и помощь: где искать помощь и готовые модели — сабреддиты, GitHub, курируемые списки ресурсов, инструкции, примеры;

▶️ Плюсы и минусы по сравнению с облаком: контроль, приватность, независимость vs сложность настройки, меньшая мощность, зависимость от железа.


➡ Ссылка на статью

tags: #статья

➡️ Data Scientist | Чат
  • 👍 2
  • 😴 2
  • 👎 1
Post #483 1.37K
🗂 Jupyter Notebook: как установить и как пользоваться?

Видеоразбор для тех, кто хочет освоить один из главных инструментов в Data Science и Machine Learning. Автор показывает, как установить Jupyter Notebook, запустить его и создать первый проект.

Видео по тайм-кодам:
00:00 — что такое Jupyter Notebook;
00:50 — установка Anaconda;
03:06 — запуск;
06:02 — первый ноутбук;
15:45 — работа с внешними файлами;
17:24 — закрытие и перезапуск;
21:17 — пример готового ноутбука.


➡ Ссылка на видео

tags: #инструмент

➡️ Data Scientist | Чат
  • 👍 2
  • ❤ 1
  • 🔥 1
Post #481 1.53K
✏️ SQL для Data Science за 6 недель

Опытный дата-сайентист собрал пошаговый план изучения SQL, оформив его в репозиторий на GitHub. Каждую неделю — новая тема с полезными материалами и практикой.

Программа выглядит так:
▶️ Неделя 1 — основы SQL и извлечение данных;
▶️ Неделя 2 — группировка с помощью GROUP BY;
▶️ Неделя 3 — все типы JOIN и где их применять;
▶️ Неделя 4 — разбор оконных функций;
▶️ Неделя 5 — CTE и подзапросы;
▶️ Неделя 6 — финальный проект для закрепления.


Отличный старт для тех, кто хочет подтянуть SQL именно под задачи аналитики и Data Science.

➡ Ссылка на курс

tags: #курс

➡️ Data Scientist | Чат
  • ❤ 4
  • 👍 1
  • 🔥 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →