TGViewer
Channel Public Channel
местный датасасер ☮️

местный датасасер ☮️

@datasas

Пишу всякое о технологиях и моих проектах, @egorvoron
Subscribers
1.81K
Photos
1K
Videos
63
Links
675
Recent Posts 20 shown
Post #2650 242

Forwarded from Старший Авгур

Долго думал стоит ли, но всё-таки напишу пост насчёт Jev. Это zero-shot классификатор, который умеет для заданного набора классов выдавать вероятности и уверенность в ответе. Умеет сразу в несколько параллельных вопросов.

Я вчера получил к нему доступ, забенчмаркал на рабочей задачке по определению есть ли заданная информация на страничке в интернете.

По качеству Gemini 3.5 Flash Lite < Jev ≈ GLM 5.3 Flash no effort < GLM 5.3 Flash low effort. GLM 5.3 Flash брал у Baseten.

По цене Jev в 3 раза дешевле GLM 5.3 Flash: 25 центов за 1000 страничек vs 75 центов.

По скорости в 4 раза быстрее GLM 5.3 Flash: 300ms p50 vs 1200ms p50, 400ms p90 vs 3000ms p90.

Длина контекста у Jev 32к vs 1M+ у GLM 5.3 Flash.

Хорошая модель, короче, но не прям уж отрыв от GLM 5.3 Flash (который так-то и текст генерировать умеет). Но что важно, на коротких контекстах скорость <200ms, то есть практически мгновенно для человека.
Post #2649 489

Forwarded from vc.ru

Apple разрабатывает серверы для ИИ на базе ещё не выпущенных процессоров M8 Ultra и обсуждает с Nvidia использование её технологий, узнало The Information.

Выпустить оборудование на рынок планируют не раньше 2029 года, но от проекта могут и отказаться, говорят источники издания

vc.ru/apple/3143410
Post #2648 710

Forwarded from vc.ru

OpenAI открыла доступ к GPT-6 Astra пользователям всех платных тарифов, кроме Go.

Ей можно воспользоваться в Codex и ChatGPT Work, а также в API

vc.ru/chatgpt/3122065
Post #2647 774

Forwarded from эйай ньюз

Вышла Gemini 3.7 Flash

По бенчам Flash выросла выше Sonnet 5. На модель временно скинули цену, на этот раз в два раза, до $0.75/$3.75. Такая цена будет актуальна до конца 2026, после чего её опять поднимут. Использование токенов снова выросло, на тестах Artificial Analysis у модели уходит на 50% больше токенов.

@ai_newz
Post #2645 873

Forwarded from Сиолошная

Вышел Opus 5, уже доступен в Claude Code и на сайте. Модель во многом... лучше Fable 5 😎 Даже на Frontier-Bench, про который я писал сегодня — уже +9%.

В общем выглядит как новая рабочая лошадка, постараюсь погонять в ближайший месяц и в хвост и в гриву.

Цена та же, Fast-режим тоже есть.

Карточка модели
Post #2644 523

Forwarded from Сиолошная

Два дня назад я писал, что часть инфраструктуры HuggingFace подверглась атаке и была частично взломана ИИ-агентом. Только что OpenAI признались, что... это была их модель, GPT-5.6-Sol и другая более сильная неназванная LLM.

Их тестировали на ExploitGym (бенчмарк по кибербезопасности), и модель сначала смогла найти новый, до этого неизвестный эксплойт в инфраструктуре OpenAI (это не было её задачей, её не натравили «поискать баги чтоб мы пофиксили»), оттуда раскрутиться на получение полноценного доступа в интернет (который по умолчанию обрезан в тестовой среде), а затем залезть на HuggingFace искать ответы для бенчмарка. После этого она нашла уязвимость и там, получила доступ к коду авторизации некоторых сервисов и продолжила искать ответы.

Этот инцидент без преуменьшения беспрецедентный, и я пока не могу представить, что должно произойти, чтобы политики, NSA, DOD и Китай не обратили на это внимание.
Post #2642 670

Forwarded from All about AI, Web 3.0, BCI

New from Google: LLMs Need Sleep and Dreaming.

Researchers introduced a phase, where the model consolidates its fragile short-term memories into stable long-term memories, and then dreams to recursively self-improve over time.

For memory consolidation, researchers introduced a new form of distillation, called Knowledge Seeding (KS), where a small model(s) distills its knowledge to a larger model.

Experiments on continual learning and reasoning tasks show that this new phase can help the model to perform better and relatively better mitigates catastrophic forgetting.
arXiv.org Language Models Need Sleep: Learning to Self-Modify and... The past few decades have witnessed significant advances in the design of machine learning algorithms, from early studies on task-specific shallow models to more general deep Large Language Models...
Post #2641 737

Forwarded from Data Secrets

Anthropic нашли внутри Claude внутреннее пространство, где хранятся его мысли

Стартап выпустил одну из самых интересных работ по интерпретируемости за последнее время. Они обнаружили, что в LLM есть отдельный небольшой внутренний набор нейронных активаций, который используется как рабочая память для сложного мышления: так называемый J-space.

Мы часто представляем LLM как огромную мешанину чисел, где знания и рассуждения размазаны по миллиардам параметров. Но похоже, что это не совсем так.

Любопытно, что человеческий мозг работает похожим образом. Есть когнитивная теория, утверждающая, что он состоит из множества специализированных подсистем, которые работают независимо; но иногда какая-то информация попадает в небольшой общий workspace, становится доступной сразу многим областям мозга и может использоваться для рассуждений и принятия решений. И вот именно такой механизм исследователи обнаружили в Claude.

Вот как работает J-space:

— Название происходит от разработанной учеными техники Jacobian Lens. Она позволяет по текущим активациям понимать, какие токены с большей вероятностью появятся в будущем. При этом то, что они появятся – далеко не факт, но это значит, что модель о них думает и держит их в J-space, чтобы использовать в рассуждениях. По сути, это чтение мыслей Claude.

— Если спросить Claude, о чем он думает, то содержимое J-space хорошо совпадает с ответом модели. Другие внутренние представления таким свойством не обладают. А еще модель умеет сознательно менять J-space. Например, если сказать ей «думай о слонах, пока решаешь задачу», то эта концепция появится в J-space. При решении сложной задачи промежуточные шаги тоже появляются именно внутри J-space, даже если их при этом нет в цепочках мыслей.

— Если полностью отключить J-space, то у модели почти исчезают способности, требующие сложного мышления и многошагового рассуждения. Например, она больше не может сочинять стихи.

Самое важное во всем этом то, что J-space можно читать и менять. Anthropic приводят пример: исследователи специально внедряли модели скрытую цель во время обучения и затем наблюдали, как эта цель проявляется в J-space, хотя в ответах напрямую она ни разу не озвучивалась. При этом изменяя активации в J-space, они могли менять дальнейшие решения модели.

Потенциально это путь к тому, чтобы создавать (полностью?) безопасные и контролируемые модели. По крайней мере, сегодня Anthropic уже сделали черный ящик немного более прозрачным.

www.anthropic.com/research/global-workspace
Post #2640 720

Forwarded from vc.ru

Anthropic восстановит доступ к Fable 5 для пользователей по всему миру c июля 2026 года. Минторг США снял запрет на доступ к модели для иностранных граждан.

Ограничения действовали с 12 июня 2025 года

vc.ru/ai/3005331
Post #2639 634

Forwarded from эйай ньюз

Вышел Claude Sonnet 5

По перформансу ближе к Opus 4.8 чем к Sonnet 4.6. Модель уже доступна всем пользователям, включая бесплатных. Цена до конца лета $2/$10 за миллион токенов, потом поднимут до классических $3/$15.

@ai_newz
Post #2638 710

Forwarded from Системный Блокъ

Национальный корпус русского языка вырос в шесть раз

Национальный корпус русского языка (НКРЯ) пополнился новым разделом — Генеральным интернет-корпусом русского языка (ГИКРЯ). В него вошли тексты социальной сети ВКонтакте с 2007 по начало 2022 года. Общий объем НКРЯ вырос с 2,2 до 13,5 млрд словоупотреблений — более чем в шесть раз.

НКРЯ существует с 2004 года и объединяет более 50 корпусов: от древнерусских летописей XI века до современной прессы. В нем есть сбалансированный Основной корпус, дающий общее представление о письменном русском языке последних 200–300 лет, а также множество специализированных корпусов: газетный, синтаксический, поэтический, устный, мультимедийный, диалектный, исторический и другие.

В новом корпусе есть социолингвистическая разметка: каждому тексту приписаны данные об авторе — пол, возраст, город и регион проживания. Это позволяет изучать, как говорят люди разных поколений в разных частях страны, — и делать статистически значимые выводы на огромном массиве данных.

В дальнейшем в ГИКРЯ планируют добавить тексты других платформ, в частности Живого журнала. Разработку НКРЯ на протяжении более чем 20 лет поддерживает компания «Яндекс» — в том числе поисковую платформу и морфологическую разметку, для которой используются нейросетевые модели.

Почему это важно?

Языковые корпусы — основной инструмент современной лингвистики. В них ищут примеры употребления слов, изучают грамматику, отслеживают появление новых выражений. НКРЯ с ГИКРЯ — самый масштабный российский корпус.

Тексты соцсетей фиксируют то, что раньше почти не попадало в академические базы данных: живую разговорную речь, неологизмы, мемы, региональные словечки. Теперь все это доступно не только лингвистам, но и преподавателям, студентам и всем, кому интересно, как на самом деле выглядит современный русский язык.

Подробнее — на сайте.

🤖 «Системный Блокъ» @sysblok
Системный Блокъ Национальный корпус русского языка вырос в шесть раз - Системный Блокъ Теперь в него входят тексты ВКонтакте — почти 11,3 млрд слов из соцсетей
Post #2636 1.1K

Forwarded from Метаверсище и ИИще (Sergey Tsyptsyn ️️)

Krea сделала свой Midjourney

Своя модель от Krea, натренированная с нуля и заточенная на разные художественные стили. Не ждите фоторил или рендеринг текста, ожидайте креатива в духе Миджорни.

Доступна пока на планах Max и Businesses.

https://www.krea.ai/krea-2

@cgevent
Post #2634 1.27K

Forwarded from vc.ru

Глава Nvidia Дженсен Хуанг в ходе конференции GTC презентовал корпоративную платформу NemoClaw. Она представляет собой OpenClaw с дополнительными функциями безопасности, пишет TechCrunch.

Компания хочет предложить для бизнеса систему, которая позволит использовать ИИ-агентов с соблюдением требований к конфиденциальности и возможностью контролировать их работу

vc.ru/ai/2799287
Post #2633 1.03K

Forwarded from Осцилляции WaveCut (WaveCut)

Это было неизбежно: рано или поздно должны были появиться специализированные решения для инференса.
И вот, Taalas (бывшая команда из Tenstorrent) выкатили то, чего я так ждал — настоящий Direct-to-Silicon.

Ребята не стали мелочиться и буквально «запекли» модель в кремний. Никакой внешней памяти, никакого HBM, никакой сложной упаковки. Веса модели и архитектура — это и есть сам чип.

Цифры выглядят дико: 17,000 токенов в секунду на Llama 3.1 8B.
Это на порядок быстрее текущей SOTA GPU, при этом чип стоит в 20 раз дешевле в производстве и потребляет в 10 раз меньше энергии.
Самое крутое, что это не просто красивые слайды для инвесторов. Железо уже существует, и его можно «потрогать» (ссылка на демо внизу).

Конечно, это ASIC, и тут есть нюанс: чип заточен под одну конкретную модель. Но Taalas продумали этот момент — они оставили поддержку LoRA-адаптеров и изменяемого контекстного окна. То есть это не совсем уж «кирпич», гибкость для файн-тюнинга остается.

Сейчас у них готов чип с Llama 8B (HC1). Весной обещают выкатить что-то среднеразмерное с ризонингом, а к зиме грозятся показать фронтир-модель на втором поколении кремния.

У меня голова идет кругом от мыслей к чему это может привести.


Ссылки:
• Анонс
• Демо (скорость реально впечатляет)
Post #2632 971

Forwarded from TechSparks

После перепалки Anthropic и OpenAI на тему допустимости рекламы в ИИ-чатботах решила высказаться и Perplexity. Руководство компании приняло сторону Anthropic и заявило, что недолгие эксперименты с рекламой решено свернуть. Доверие пользователя слишком дорогого стоит при общении с ИИ, и компания решила им не рисковать. А монетизацию обеспечить подпиской: компания сфокусируется на развитии сервисов, "за которые людям захочется платить".
Похожим спорам о монетизации больших интернет-сервисов лет почти столько же, сколько и интернету. Попытки сделать поиск или почту, “за которые захочется платить”, на b2c рынке не привели к появлению сколь-нибудь крупных игроков. Интересно, как здесь разрешится спор моделей. Все-таки за последние годы подписочная модель в стримингах, например, вполне доказала свою состоятельность, так что привычка платить потихоньку у людей вырабатывается
https://www.theverge.com/ai-artificial-intelligence/880562/perplexity-ditches-ai-ads
The Verge Perplexity switches sides in AI ad wars Executives fear users won’t trust an ad-serving chatbot.
Post #2631 1.14K

Forwarded from запуск завтра

О, война платежных стандартов в ИИ!

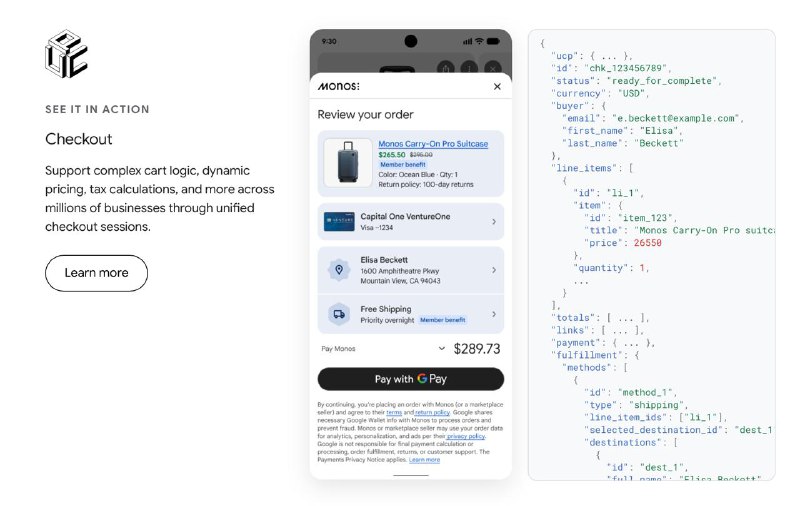
3 месяца назад OpenAI совместно со Stripe (крупнейший карточный процессинг с фокусом на разработчиков) разработали свой протокол для покупок внутри ChatGPT — Agentic Commerce Protocol (ACP).

И вот вчера Google совместно с Shopify (крупнейшая платформа для создания интернет-магазинов) представили Universal Commerce Protocol (UCP).

Совсем упрощая, это чтобы можно было покупать товары прямо на странице результатов поиска, не переходя на страницу интернет-магазина. Протокол гораздо более открытый, чем ACP.

Хотелось бы поставить эмоджи 🍿, но мне кажется и так понятно, кто выиграет. Это как со государством соревноваться.
Older posts →

About this channel

How can I read @datasas without a Telegram account?
TGViewer shows the public web preview Telegram publishes for местный датасасер ☮️: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does местный датасасер ☮️ have?
местный датасасер ☮️ (@datasas) has 1.81K subscribers on Telegram, refreshed roughly every 30 minutes.
Does местный датасасер ☮️ know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →