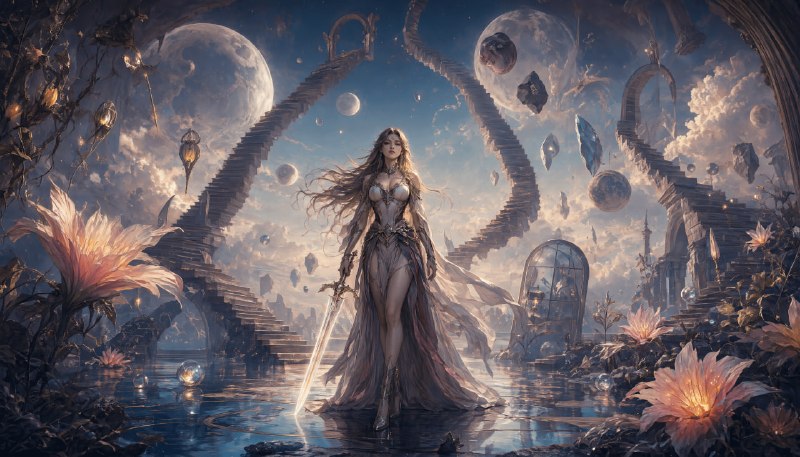
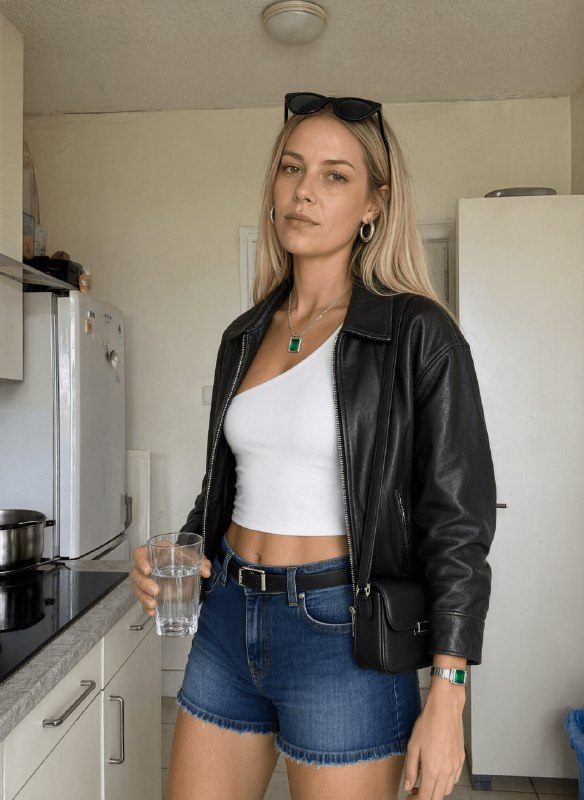
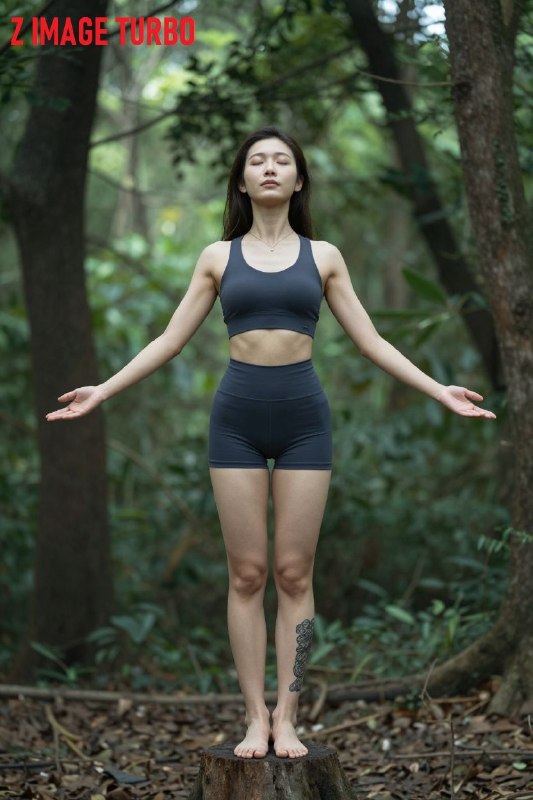
Алибабищенко бахнул Qwen-Image 2.1 и выложил веса.Это единая модель для генерации и редактирования изображений. Визуальная часть содержит
7B параметров и 32 Single-Stream DiT-блока. Сносно.
Ништяки:
-
native 2K - базовое разрешение 2048x2048, поддерживаются в том числе 2752x1536 и 1536x2752;
-
text-to-image и image editing в одной модели;
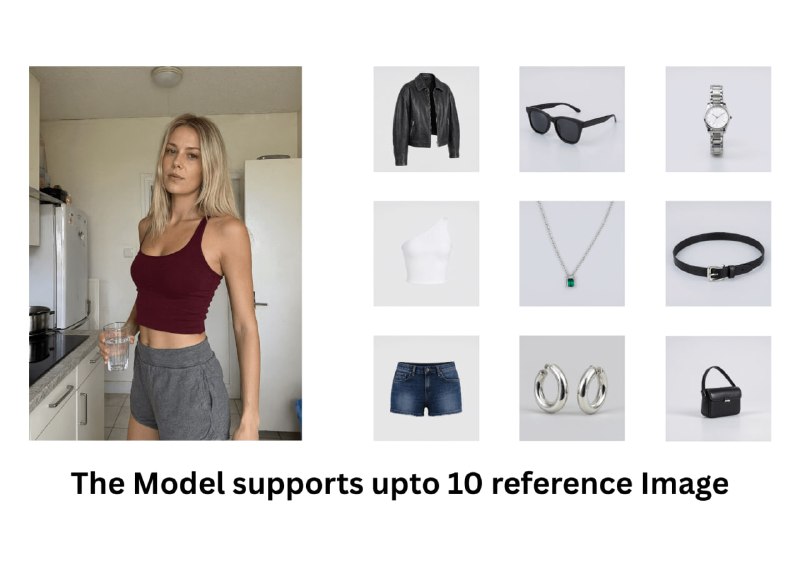
- до
10 референсных изображений одновременно;
- локальное редактирование можно задавать каракулями, нарисованными пометками или отдельными масками;
- улучшено сохранение идентичности людей и объектов при редактировании;
- улучшены типографика, портретное освещение, текстуры и мелкие детали;
- рекомендуемый стандартный режим -
40 inference steps.
Одна из самых интересных фишек -
нативный RGBA и прозрачность. Модель умеет сразу генерировать объект с alpha-каналом(!), редактировать прозрачные изображения(хм) и даже типа взять обычную RGB-фотографию и извлечь из неё нужный объект в отдельный прозрачный RGBA-слой (верим? тестируем?).
Веса уже доступны на Hugging Face. Comfy Org также выложила набор весов Qwen-Image 2.1 для ComfyUI, а сама Comfy ещё до релиза заявляла нульдэй саппорт.
Лицензия - говно. Ресерч.
На рыддите, кто-то рыдает от восторга, особенно от эдит и консистентности, а кто-то ноет про кожу и мыло. Кожаным не угодишь. Жду тестов в коментах
Шопопамяти:Хорошая новость: 24-32 GB VRAM для неё, похоже, вообще не обязательны. На Reddit уже пишут, что модель должна нормально жить даже на RTX 3060 при квантизации.
С
ама 7B-модель в INT8 около 7 GB + text encoder Qwen3-VL в W4A8 около 6 GB.
То есть суммарно порядка
13 GB весов, причём ComfyUI умеет выгружать части в RAM, поэтому 12 GB VRAM выглядит вполне нарядным вариантом.
Для нищебродов:
8 GB VRAM - скорее всего заведётся с агрессивной квантизацией/offload, но пока нет нормальных подтверждённых тестов именно Qwen-Image 2.1.
12 GB VRAM - выглядит как реальный рабочий минимум для квантованной версии в ComfyUI.
Для помещиков:
16 GB VRAM - сейчас выглядит как очень нормальный вариант. На Reddit владельцы 5060 Ti 16 GB уже радуюццо релизу именно в этом контексте.
24 GB VRAM - должно быть уже совсем комфортно для квантованной модели и, вероятно, позволит меньше гонять данные CPU<->GPU.
Для Баяр:
32 GB - может влезут и не кванты..
Почему такая разница с прежним Qwen Image: старая модель была огромной - около
20B параметров только генеративной части, а Qwen-Image 2.1 теперь жалкие
7B.
Ссылки:Официальная страница Qwen:
qwen.ai/blog?id=qwen-image-2.1Веса Qwen-Image 2.1:
huggingface.co/Qwen/Qwen-Image-2.1Версия для ComfyUI:
huggingface.co/Comfy-Org/Qwen-Image-2.1@cgevent  МЕ