TGViewer
Channel Public Channel
Datalytics

Datalytics

@datalytx

Канал для аналитиков данных про Python, карьерное развитие в анализе данных, всякое разное

Автор – @ax_makarov

Отдельный канал про ChatGPT и его практическое применение —  @ai_forge

Чат канала — @pydata_chat

Вакансии — @data_hr
Subscribers
8.81K
Photos
257
Videos
16
Links
715

Showing posts older than #836 · Back to latest

Older Posts 20 shown
Post #831 3.94K
Pandas на самом деле предельно прост

Но как и при использовании любого инструмента, который с виду кажется простым, всегда возникают какие-то ограничения, которые мешают решить поставленную задачу

У только что освоивших import pandas as pd бывает, что они знают какого вида табличку хотят получить на выходе, а как её получить — не знают и в итоге впадают в ступор, потому что знают синтаксис, но не знают внутрянки

Для того, чтобы эффективно использовать Pandas и максимально пользоваться его потенциалом, важно понимать основные структуры данных Series и DataFrame, так как они являются строительными блоками работы с данными в Pandas

Написал про это целую статью с кучей примеров

http://datalytics.ru/all/uglublennoe-izuchenie-pandas-struktury-dannyh/
  • 👍 39
  • 👎 2
Post #827 4.03K
A/B-тестирование — незаменимый инструмент при проверке гипотез, но есть ряд причин, по которым оно может привести к ошибкам

Ребята из OzonTech в своей статье рассмотрели шесть распространенных причин, из-за которых система принятия решений через A/B-тестирования может давать неверные выводы. Узнайте, что нужно учитывать, чтобы ваши эксперименты работали и, таким образом, приносили пользу бизнесу. Мы рассмотрим методологию и процесс A/B-тестирования, а также проблемы и заблуждения, которые могут привести к провалу. Если вам кажется, что вы не обладаете достаточными знаниями о том, как проводить и правильно оценивать эксперименты, то вам будет полезна эта статья

https://habr.com/ru/company/ozontech/blog/712306/
  • 👍 5
  • 😁 1
Post #826 3.16K

Forwarded from Designing Numbers

Немного не по теме моего канала, но нет сил молчать. Недавно я поняла, что некоторые сервисы строят пузырьковые диаграммы, как бог на душу положит. И провела маленькое исследование, в котором сравнила результаты наиболее популярных датавиз сервисов и программ. Хочу его попозже дополнить еще QGIS и Gephi, если будет интерес. Если есть еще идеи — ю а вери велкам.

Опубликовала у себя на тильде
  • 👍 8
  • 🔥 2
Post #814 3.68K
Написал на своём философском канале пост со своими размышлениями про ChatGPT и про будущее человеческого мышления и уникальности в контексте массового внедрения генеративных моделей

➡️ https://t.me/kempleks/26

С радостью почитаю вашу обратную связь на этот текст
  • 👍 1
Post #809 2.98K

Forwarded from Reveal the Data

📈 Dashboard Canvas 2.0 📈
Три года назад я придумал сделать шаблон сбора требований для дашборда. За это время его использовали много раз, а видео с рассказом про него на канале DataLearn от Димы Аношина посмотрели более 20 тысяч раз. За это время я получил много обратной связи и сам часто использовал шаблон, поэтому смог конструктивно его улучшить. Представляю новую версию!

Подробно, почему он стал таким, я недавно рассказал на конференции Flow, 👉 вот запись 👈, получилась интересная история развития фреймворка. Спасибо организаторам, они согласились выложить доклад в общий доступ сильно раньше, чем планировали.

А вот ссылка на Miro, где теперь есть инструкция, примеры и новая версия в pptx (ещё приложу её в комментарии). Совместно с идеей построения карты дашбордов получается полноценный алгоритм построения системы дашбордов в компании. Делитесь обратной связью и используйте в работе!
@revealthedata
YouTube Роман Бунин — Dashboard Canvas 2.0 Подробнее о конференции Flow: https://jrg.su/CAm5kF — — Проектирование дашбордов — дисциплина на стыке аналитики и дизайна. Роман не верит в процесс, когда заказчик дашборда сам составляет ТЗ для разработчика, ведь в итоге разработчик становится просто «руками».…
  • 👍 9
Post #807 3.29K
Уже больше 70 лет биологи исследуют состояние Байкала: берут пробы воды в одной и той же точке и вручную ведут подсчет микроорганизмов. Этот метод не менялся с 1945 года. Теперь учёным помогают алгоритмы машинного обучения — они анализируют виды и формы планктона и экономят время специалистов.

Нейросеть Yandex Cloud стала доступна в опенсорсе — то есть и сам алгоритм, и датасет можно использовать в исследованиях других водоемов по всему миру. Читайте подробнее в блоге.

Посмотрите короткометражку о том, как нейросети учились различать байкальских рачков, а специалисты из разных областей — понимать друг друга
  • 🔥 13
Post #802 2.7K
Запись Q&A-сессии с Yandex DataLens Festival. Роман Бунин и Роман Колеченков ответили на вопросы участников Yandex DataLens Festival о работе с чартами, дашбордами, расчётными полями. На фоне роста популярности альтернативных BI-систем будет полезно

А ещё оказывается существует коммюнити DataLens в телеграме и там довольно-таки живо и можно найти ответы на интересующие вопросы
  • ❤ 7
  • 👍 3
Post #801 2.26K

Forwarded from 🗞 Виз Ньюз (Nikita Rokotyan)

🥳 🎉 Представляю Unovis — новую библиотеку визуализации данных для React, Angular, Svelte, а также «голого» TypeScript и JavaScript.

У меня второй большой (после Космографа) open source анонс в этом году, который будет интересен в первую очередь веб-разработчикам. Сегодня мы выложили в открытый доступ дитавиз библиотеку, над которой я работаю уже на протяжении последних трех лет (разработка началась в стартапе Volterra, и продолжилать в купившей его компании F5).

Немного об отличительных особенностях Unovis:
• 🏗 Удобно интегрируется в React, Angular и Svelte, что дает возможность использовать одну библиотеку в совсем разных проектах;
• 🗺 Помимо классических графиков умеет рисовать детальные карты и графы;
• 💇 Легко кастомизируется под ваш стиль (спасибо CSS переменным);
• 📖 Детальная документация и галерея примеров с кодом для разных фреймворков.

Если заинтерисовались, добро пожаловать на сайт библиотеки unovis.dev, и не забудьте лайкнуть наш репозиторий на GitHub!
  • 👍 4
  • 🔥 1
Post #800 2.66K
Предлагаю послушать подкаст «Дайте данных!»

Это профессиональный разговор о том, как устроена работа аналитиков и дата сайентистов в самых разных сферах. Авторы и ведущие подкаста — Наташа Тоганова и Саша Бородин — давно работают с большими данными и машинным обучением, они делятся своей экспертизой и узнают, как работают их коллеги в разных компаниях и институциях. Гости подкаста изучают данные, чтобы предсказывать погоду и урожайность полей, борются с мошенниками, защищают персональные данные в финтех сервисах, изучают старые и новые языки программирования.

Подкаст «Дайте данных!» — о том, как разнообразен мир больших технологий. Послушать выпуски будет интересно и полезно как профессионалам, так и начинающим разработчикам и аналитикам, которые только ищут себя и присматриваются к миру больших данных.

✅ Послушать на удобной платформе https://pc.st/1584566030
✅ Стать частью NoML Community https://t.me/noml_digest
  • ❤ 3
  • 👍 2
Post #798 2.78K
Восьмой онлайн-митап для продуктовых аналитиков от AvitoTech

С докладами выступили спикеры из Авито, Lamoda и СберМаркета. Поговорили про предиктивную классификацию, офлайн-эксперименты и аналитику клиентской базы.

➡️Программа

1️⃣Как мы в Авито увеличили эффективность привлечения за счёт предиктивной классификации
Ирина Гутман из Авито рассказала как большая площадка с кучей данных может их использовать для эффективного привлечения целевого трафика. Как использовать предсказания и классификации для оптимизации и как быть с неизбежными подводными камнями. Ирина приводит пример из истории перформанс-маркетинга Авито, когда это сработало

2️⃣Аналитика клиентской базы
Кирилл Федоренков из Lamoda рассказал, почему для Lamoda важна аналитика клиентской базы и какие задачи, связанные с ней, ребята решали. Рассматриваются кейсы сегментации клиентской базы, построения прогнозов, анализа причинно-следственных связей

3️⃣Применение иерархических моделей в офлайн-экспериментах
Полина Ревина из СберМаркета рассказала что делать при столкновении с влиянием объектов рандомизации в разных группах друг на друга во время эксперимента. Для проведения таких экспериментов СберМаркет использует свитчбэк-тестирование. При таком подходе возникает естественная вложенность данных и зависимость наблюдений
  • 👍 8
Post #797 2.73K
И снова подкаст. На этот раз записался в подкасте «Выживут только айтишники»

В выпуске пытаемся понять, как аналитику адекватно оценить карьерные возможности и что нужно делать, чтобы постоянно развиваться внутри профессии. Разбираем аргументы в пользу повышения зарплаты: изменение зоны ответственности, грейды, исследования рынка труда, контр-офферы

В целом, получилось описать хороший алгоритм того как аналитику можно расти в зоне ответственности и деньгах, оставаясь на текущей работе или осуществляя карьерные переходы, в том числе в смежные профессии, например, в продакт-менеджеры или дата-инженеры

Где послушать:
В телеге
В Яндекс.Музыке
В Apple Podcasts
В VK
На сайте студии Red Barn
В PodParadise
В Castbox
В podcast.ru
В Google Podcast
  • 👍 12
  • 🔥 6
Post #796 2.37K

Forwarded from Reveal the Data

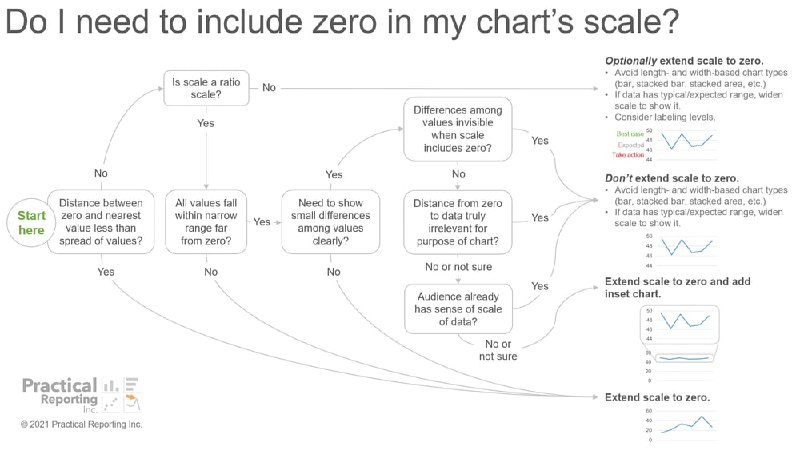
Недавно на работе возник вопрос — в каких случаях можно отрывать ноль по оси Y для линейный графиков.

Я придерживаюсь таких правил:
⬆️ Если мы смотрим за небольшими периодом времени (дни и недели); на графике только одна линия; и метрика довольно стабильна (примерно изменяется в диапазоне ±15%), то скорее важнее смотреть за изменениями и можно отрывать ось от нуля.

0️⃣ Если смотрим большой период (месяцы и года); на графике есть другие линии; абсолютные значения важнее, чем изменения (например важно не упасть ниже какого-то значения); или метрика меняется в широком диапазоне, то отрывать ноль не стоит.

У Ника Десбарата есть отличная статья с примерами на эту тему с более сложным (и чутка запутанным 🙈) алгоритмом выбора.

🚫 Ну и конечно же не забываем, что для площадных диаграмм (барчарты и эреачарты) отрывать ноль нельзя ни в каком сценарии!
#ссылка
  • 👍 3
Post #793 3.36K
Записался недавно в подкасте «Багрепорт»

В выпуске погружаемся в профессию и пытаемся понять, как аналитики работают, чем живут, как развиваются по хард и софт-скиллам. Пытаемся разобраться, чем эти специалисты похожи на ученых и зачем им нужно погружаться в теорию вероятностей.

Почему аналитиков делят на две касты: «требований» и «данных»? Всем ли так нужен SQL? Кстати, да. Excel — лучший друг аналитиков.

Где послушать:
В телеге
В Яндекс.Музыке
В Apple Podcasts
В VK
На сайте студии Red Barn
В PodParadise
В Castbox
В podcast.ru
  • 🔥 15
  • 👍 6
Post #792 3.23K
Paul Levchuk в своей статье «Product feature retention deep dive» разбирает как провести анализ функций в продукте, чтобы оценить их влияние на возвращаемость пользователей с помощью метрики Information gain и всё это в Google Spreadsheets
  • 👍 15
Post #791 4.71K
МТС вывел в Open Source первую версию библиотеки под названием Ambrosia. Ее назначение – работа с A/B тестами и экспериментами.

➡️Что сейчас умеет библиотека?
🟠теоретический и эмпирический дизайн экспериментов;
🟠деление на группы (в том числе на множество групп, со стратификацией и так далее);
🟠расчет эффекта с построением, как точечной, так и интервальной оценки;
🟠использование нескольких подходов к увеличению чувствительности метрик: CUPED, MULTI_CUPED, MLVarianceReducer и другие;
🟠возможность использование Spark API для дизайна и сплита.

В статье на Хабре рассказывается о функционале библиотеки
  • 👍 13
Post #785 3.57K
В прошлом году проходил митап по аналитике от EXPF x Delivery Club. На митапе ребята много говорили про оценку экспериментов, так что эти доклады будут полезны аналитикам, которые в своей работе сталкиваются с проведением тестирований и анализом результатов тестов. Я делился анонсом трансляции, но анализируя прошлые посты, понял, что не поделился записями докладов

Исправляюсь:

1️⃣«Что делать, если возникли сомнения, подходит ли твой критерий для твоего теста (а они должны возникать!)», Тимур Исмагилов, Avito

2️⃣«Платформа switchback-экспериментов в Ситимобил», Артём Солоухин, Cитимобил

3️⃣«Как мы ищем точки роста в продукте: пошаговая инструкция», Владимир Абазов, Delivery Club

4️⃣«Скрытая угроза ранговых критериев», Егор Семин, EXPF
  • 👍 5
Post #783 3.07K
Вчера на вебинаре с Артёмом Исакиным и Ритой Нижельской поговорили про различия между аналитиками данных и аналитиками требований (бизнес- и системными)

Подробно рассказали:
🟢 какие навыки нужны в этих профессиях
🟢 что нужно на входе, чтобы начать карьеру
🟢 на что смотрят работодатели про трудоустройстве

https://www.youtube.com/watch?v=aE1X1KlKJZ8
  • 👍 1
Post #782 3.23K
Запись вебинара с мероприятия «Управляемый сервис YDB: настройка, применение, мониторинг»

🔩 YDB — реляционная СУБД, которая была разработана в Яндексе. YDB позволяет создавать интерактивные приложения, которые можно быстро масштабировать, когда растёт нагрузка и объём данных. Применение YDB как управляемого сервиса позволяет разработчикам и архитекторам сосредоточиться на бизнес-задачах, а команда Yandex Cloud возьмёт на себя заботы о надёжности, производительности и ресурсной эффективности баз данных.

На вебинаре показали, как:
— начать работу с сервисом;
— подключить приложения и настроить аутентификацию;
— контролировать потребление ресурсов;
— работать с доступными инструментами мониторинга;
— масштабировать базы данных, когда нагрузка растёт.

https://www.youtube.com/watch?v=d5NEDzsyp7Q
YouTube Управляемый сервис YDB: настройка, применение, мониторинг 00:00 — Начало 01:30 — YDB в целом и сервис YDB в Yandex Cloud 04:44 — Разворачиваем сервисы YDB 12:08 — Методы аутентификации пользователей, создание учётных записей 19:05 — Обзор web-интерфейса консоли Yandex Cloud в части YDB 23:16 — Работа с YDB через…
Post #781 3.75K
➡️Прогноз LTV: как выбрать модель и оценить результат

На ютубе появилась запись вебинара от команды предиктивной аналитики MyTracker

На вебинаре обсуждали:
▶️зачем нужен прогноз LTV;
▶️как выбрать модель под разные кейсы;
▶️как правильно оценивать прогноз;
▶️какие есть ограничения и критерии применимости моделей.

Ссылка на вебинар 🚛 https://www.youtube.com/watch?v=e8JKKAjWoqw
YouTube Прогноз LTV: как выбрать модель и оценить результат Вебинар от команды предиктивной аналитики MyTracker посвящен выбору подходящей модели прогноза LTV и метрик для оценки ее эффективности. Вы научитесь: - выбирать модель под разные кейсы; - правильно оценивать прогноз; - понимать ограничения и критерии применимости…
  • 👍 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →