TGViewer
Channel Public Channel
Data Funk

Data Funk

@datafunk

Subscribers
251
Photos
201
Videos
2
Links
80
Recent Posts 19 shown
Post #293 75

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • ✍ 2
  • 🔥 1
Post #292 116

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • ❤‍🔥 2
  • ❤ 2
Post #290 178
Команда из École Normale Supérieure (🇫🇷) собрала CalArena - один из самых больших бенчмарков по post-hoc калибровке на сегодня. Внутри: 2000 экспериментов 🔬 (пары датасет–модель), там почти всё - binary/multiclass, таблички/картинки, линейки/бустинги/сетки/трансформеры + десятки методов калибровки.

Спойлер: не используй Expected Calibration Error (ECE). Она слишком чувствительна к числу бинов и может показать нулевую ошибку, даже когда классификатор отдаёт просто среднюю частоту классов в выборке. Авторы предлагают смотреть на ΔBrier Score относительно некалиброванной модели. Такая оценка заметно стабильнее.

Что ещё обнаружили:
• Непрерывные методы почти всегда выигрывают у биннинга. Platt, Temperature Scaling, Splines, CDF, Quadratic и др. стабильно обходят Histogram Binning.
• Centered Isotonic Regression лучше классической Isotonic. Простое центрирование убирает лесенку и даёт более гладкую, аккуратную калибровку.
• Logits vs Probs. Калибровка сырых логитов лучше, чем калибровка готовых вероятностей.
• Для multiclass используй нативные методы. TS, Vector Scaling и Matrix Scaling работают лучше, чем One-vs-Rest.
• Tree-based модели тоже умеют калибровать. CatBoost показывает достойные результаты, но только со строгой монотонностью на входящие логиты/вероятности.

CalArena - отличный референс для выбора способа калибровки на основе честного сравнения.
  • 🔥 5
Post #289 197
Листаю статьи про A/B и ML, и это будто две разные вселенные. Только в Causal ML они хоть как-то начинают мэтчиться 🤝. В A/B аналитики задают уровень значимости (alpha) и мощность (1 - beta). Хоть индустрия понемногу и пытается слезть с иглы p-value, эти метрики всё еще захардкожены как дефолт в почти любом эксперименте. При этом, между alpha, beta и метриками классификации есть прямой перевод:

H0 (Нулевая гипотеза) - это наш Negative класс (эффекта нет, юзер не фродер) ❌.
H1 (Альтернатива) - это Positive класс (эффект есть, транзакция левая) ✅.

Получается:
Ошибка I рода (обрадовались, что фича взлетела, а она пустышка) - это чисто False Positive Rate. То есть alpha = 1 - Specificity (специфичность - это аналог Recall, но для нулевого класса).
Ошибка II рода (проморгали реальный профит) - это False Negative Rate. То есть beta = 1 - Recall.

Когда ты фиксируешь alpha и beta перед запуском A/B, с точки зрения ML ты просто задаешь ограничения на Specificity и Recall 🎯. По сути, это бинарный классификатор на одной единственной фиче - тестовой статистике. И этот классификатор должен научиться отличать "эффект есть" от "эффекта нет" в пространстве схожих AB-тестов 🔍.

Но самое вкусное: если крутить критическое значение тестовой статистики, можно нарисовать для A/B-теста классическую ROC-кривую прямо в осях (alpha, 1-beta) 📈. Ее AUC - это вероятность того, что случайно взятый эксперимент с реальным эффектом выдаст тестовую статистику выше, чем тест-пустышка. ROC AUC здесь покажет саму разделяющую способность теста без жесткой привязки к дефолтной alpha.
  • ❤ 7
  • 🤔 3
Post #288 222
Что по плюсам:
Скорость: Это в разы быстрее любых других методов.
Строгость: На руках честный p-value и доверительные интервалы.
Стабильность: Оценка не дергается от рандома, в отличие от SHAP.

Подводные камни:
OOD (Out-of-Distribution): Вставляя среднее, можно сгенерить франкенштейна - комбинацию признаков, которой в природе не существует. Но этим грешит и Permutation.
Игнор масштаба: Тесту плевать, насколько фича улучшила прогноз. Он смотрит только на бинарное стало лучше/хуже.

По соотношению цена/качество выглядит отлично.
  • 👍 1
Post #287 214
В прошлом году открыл статью, пробежался по диагонали и закрыл. А недавно увидел ее снова и понял какое это золото🏆 Стэнфордские ребята придумали, как дешево и сердито понять: вот эта фича в датасете реально тащит, или она тут для массовки?

Обычно мы берем SHAP, который колбасит от шума, либо Permutation Importance, искусственно раздувая дисперсию оценок. Всё это эвристики и p-value они тебе не дадут. Исследователи предложили элегантный костыль (без переобучения модели на каждый признак) - AICO (Add-In Covariates): берешь готовую модель, на тестовой выборке считаешь прогноз с реальной фичей, и прогноз, где фича заменена на заглушку (среднее, медиану) по каждой строке датасета. Дальше считаем дельту скоров:

Delta_i = S( f(Xi), Yi ) - S( f(~Xi), Yi )
Где первая часть это когда модель видит всё, а вторая когда фичу Xi заменили заглушкой. S - скор функция, обычно отрицательная потеря (например, -MSE, не MSE).

Если с реальной фичей скор стабильно лучше - профит, признак значим. Тут в ход идет старый добрый знаковый тест (Sign Test). Нулевая гипотеза: Median(Delta) <= 0 (признак - мусор). Фактически ты просто считаешь количество успехов (Delta_i > 0), которое при нулевой гипотезе подчиняется биномиальному распределению Binomial(N, 0.5), N - размер всей тестовой выборки.
  • 🔥 7
Post #286 288
Владимир Вапник (один из основателей ML): при решении конкретной задачи не решайте более общую в качестве промежуточного шага.

Это идеально описывает DRE (Density Ratio Estimation). Вместо того чтобы отдельно искать p(x) и q(x), а потом делить, DRE оценивает p(x)/q(x) напрямую. Это проще, стабильнее и требует меньше данных.

Будь то адаптация к сдвигу выборки (train ≠ test), поиск аномалий и точек изменения в рядах, GAN и диффузионки, causal inference (propensity scores, тесты на независимость), работа с синтетикой — везде торчат уши DRE.🐰

На гифке пара кроликов. Один стационарен, второй летает вокруг. Цветом показано отношение их плотностей, посчитанное через uLSIF - элегантный алгоритм DRE, который аналитически аппроксимирует отношение плотностей взвешенной суммой ядер.
  • 🔥 3
Post #285 306
  • 🔥 2
Post #284 291
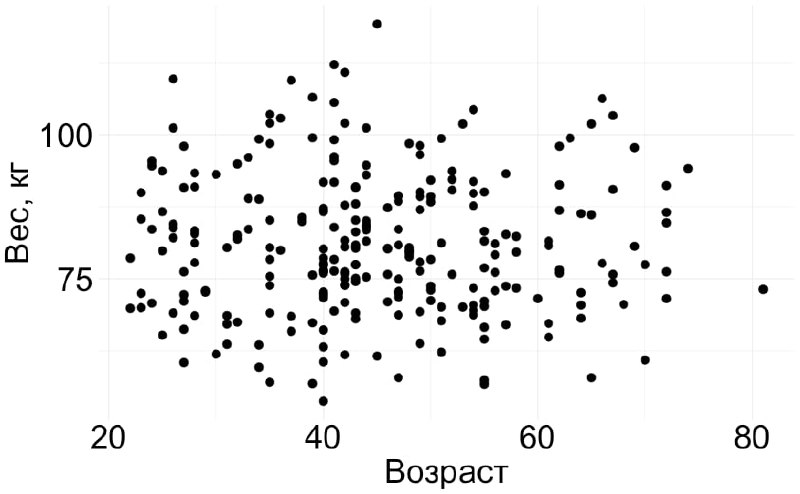
Скоро лето значит вырастут продажи мороженного🍦 и количество комаров. Или вот еще - размер ноги ребенка сильно коррелирует с умением читать📖. Корреляция есть, а прямой связи нет. Очевидно включается третий фактор (сезон/возраст). С этим всё просто.

Пример посложнее: возраст и вес.
Если смотреть на всех людей сразу, связи нет (корреляция нулевая). Одни полнеют из-за плохого метаболизма, другие теряют вес из-за ухода мышц. В итоге статистика показывает ноль. Магия начинается, если добавить условие. Допустим, возьмем мужчин с одинаковым обхватом живота. Проявляется четкая связь: если талия одна, но если человек старше - он, скорее всего, весит меньше (мышцы тяжелее жира, а с возрастом мышечная масса уходит). Это и есть условная корреляция - важная деталь в анализе причинности. Она помогает распутать клубок данных и увидеть скрытые закономерности, если зафиксировать важные детали.
  • 👍 5
  • 👎 1
Post #281 1.32K
Хотите подглядывать в AB тесты? Вот вероятно простейший способ, за который не надают по рукам. Проблема известная: подглядывание в AB тестах увеличивает ложноположительные ошибки (шансы внедрить ерунду в прод).
Авторы статьи предлагают относиться к завершению теста как к задаче предсказания. В любой момент подглядывания вы вычисляете вероятность того, что ваш тест отвергнет нулевую гипотезу когда этот самый тест завершится.
Представьте: запустили тест на месяц, спустя неделю у вас есть накопленные выборки X0, X1. Делаем финт ушами и говорим, что остальные 3 недели у нас будет верна нулевая гипотеза, а значит можно объединить вместе X0 и X1 в одну выборку и бутстрапом заполнить из нее будущие три недели для тестовой (X1_future) и контрольной (X0_future) групп, а затем посчитать заранее выбранную статистику (t-тест, непараметрическую и тд) и получаем бинарный результат - 0 (нулевая гипотеза не отклонена), 1 (нулевая гипотеза отклонена). Повторяем этот бутстрап 10000 раз и считаем Q - долю симуляций, где тест показал значимость. Если Q >= 0.95 (или другой заданный порог), мы торжественно закрываем AB тест досрочно.
  • ✍ 3
  • 👎 1
  • 🔥 1
Post #280 499
В продолжение предыдущего поста, про статистику в современном мире. Недавно в универе Квебека показали, что обычный метод наименьших квадратов (OLS) математически полностью эквивалентен упрощенному механизму внимания из трансформеров если softmax заменить на линейную функцию. То, что в Attention называется Query, оказывается просто линейной проекцией ваших тестовых данных (для которых ищем ответ) в новое пространство, Key - проекция обучающей выборки в это же пространство. Считаем их скалярную близость, используем её как веса для таргетов обучающей выборки (Value) и всё! Практической пользы ноль, зато педагогическая ценность 10/10. Attention - не какая-то магия, а классическая статистика и взвешивание по сходству (как в OLS/Ridge) на стероидах.
  • ❤ 9
Post #279 731
Если Вам кажется что традиционная статистика выглядит "мертвой" на фоне LLM/ViT/GNN, то так кажется не только Вам. В 2024-м топы статистики из Стэнфорда, Гарварда и CMU собрались на конфу "Statistics in the Age of AI".

К чему пришли:
- Колоссальные объемы данных снимают большинство ограничений, накладываемых на выучиваемые распределения.
- Современные модели живут в тысячемерных пространствах и отлично себя чувствуют, что не укладывается в традиционное "проклятие размерности".
- Просто предсказывать следующее слово эффективнее, чем строить сложные лингвистические теории.
- Модели все чаще учатся на синтетических данных, которые не выдерживают критики традиционной статистики.
- Феномен "двойного спуска" противоречит классическому компромиссу смещения и дисперсии.
- В академической среде "чистка данных" считается черновой работой, не достойной престижной публикации, а в ИИ это основа успеха.

То, что началось со статьи Лео Бреймана "Statistical Modeling: The Two Cultures" еще в далеком 2001 году, сегодня стало очевидно всем. Теперь "строгость" это не только про математическую элегантность, но и про воспроизводимость (когда метод стабильно дает надежные результаты). Скорее всего в будущем статистика уже будет не похожа на то, чему нас учили в универах.
  • 🔥 7
Post #278 287
И вот лайфхак: ребята из Гарварда предлагают безопасно прикрутить сюда LLM, т.е. смешать реальные данные и синтетические. Самое главное - дают гарантию "это точно не навредит оценке теста" и доказывают, что дисперсия не станет хуже, чем при обычном AIPW. Суть подкупает простой: просим LLM предсказать поведение пользователей в эксперименте, и строим новую оценку эффекта по ее прогнозу. Для каждого пользователя в табличку с наблюдениями теста добавляется две колонки:
S - оценка эффекта, посчитанная через стандартную ML-модель.
L - оценка эффекта, посчитанная через LLM. Ищем их комбинацию Final = λ*S + (1-λ)*L, чтобы дисперсия была минимальная: λ = (Var(L) - Cov(S,L)) / (Var(S) + Var(L) - 2*Cov(S,L)).

По этой же схеме можно смешать сразу несколько LLM. Если ответы галлюцинируют, то алгоритм просто обнуляет их веса и возвращается к базовому AIPW. Главное выбрать что дешевле: прогонять тысячи юзеров через LLM API или набрать больше людей в тест.
  • ✍ 4
Post #277 228
Если гоняете A/B-тесты, то AIPW (Augmented Inverse Probability Weighting) это популярный вариант их оценки с помощью ML. Моделируем целевую метрику (Y) пользователя X в группе A (флаг группы = 0/1) - f(X), вероятность попадания в группу - prob(X). И сырой Y меняем на скорректированный: Ynew = A*(Y - f(X))/prob(X) + f(X). Итоговый эффект теста это средняя разница между Ynew в тестовой и контрольной группах по всем пользователям. Такой подход делает оценку эффекта надежнее за счет дополнительных знаний ковариат X.
  • 👍 4
Post #276 478
Традиционно эмбеддинги получаем нейросетями. Если хотите "экологически чистые" эмбединги🌳, то ребята из Королёвского колледжа Лондона сделали "деревянный" автоэнкодер. В отличие от классического варианта, тут кодер и декодер учатся независимо.

Кодер работает как GAN: лес учится отличать реальные данные от синтетических, а из его листьев-ошибок семплируются всё более правдоподобные точки. После нескольких итераций лес перестает их различать. Так модель учит внутреннюю структуру данных. Затем для n точек строится матрица близости K (насколько часто пары точек попадают в один лист). В простом варианте первые d собственных векторов (V) и значений (Λ) этой матрицы формируют d-мерные эмбеддинги: Z = √n*V*Λ.

Декодер это просто k-nn в пространстве эмбеддингов: чтобы восстановить объект по эмбеддингу, берём k ближайших точек из обучающей выборки и усредняем их фичи (берём моду для категорий).

Что бы получить эмбеддинг новый точки из test набора ищем ее близость к тем же n точкам - K' и умножаем на собственные вектора: Z' = √n*K'*V.

Всё без градиентов, только 🌲🌳🪵!
  • 🔥 5
  • 🤯 4
Post #275 327
В качестве примера взял 1.3 млн точек из множества Жюлиа (-0.123+0.745*j), каждую точку соединил с ближайшими 8 соседями - получился граф с симметричной матрицей смежности X, которую слева и справа умножил на случайную ортонормированную матрицу R размером 1.3M на 130 (R сначала заполняется гауссовским шумом, а затем пропускается через быструю QR декомпозицию для ортонормировки):

Y = (R^T)*X*R,

Так перешел от матрицы 1.3M х 1.3M к матрице 130 х 130. По теореме Пуанкаре собственные значения маленькой матрицы Y зажаты между собственными значениями большой X, примерно сохраняя их распределение. Значит можно взять несколько λ от Y (я взял первые 13 собственных значений) прогнать их итерациями через X и получить соответствующие им собственные вектора матрицы X, а дальше отправить в k-means или гауссовские смеси (выбрал этот вариант, потому-то k-means оказался более шумный). Получается такая кластеризация графа на случайных проекциях.
  • 🔥 4
Post #274 268
Не перестаю восхищаться JL леммой - случайная проекция из многомерного пространства в меньшее число измерений примерно сохраняет попарные расстояния между точками, это значит, ты можешь сжать данные, ускорить k-nn или получить примерный собственный спектр, если применить случайную проекцию сразу к колонкам и строчкам симметричной матрицы, что я и сделал.
Post #273 2.69K
Вот крутите вы свой датасет, тщательно выбираете топ-k самых-самых фичей, а возможно тратите время зря. Вышла статейка, где авторы подошли к вопросу отбора фичей с точки зрения проверки нулевой гипотезы: значимо ли "умный" выбор отличается от случайного подмножества k признаков?

Шок-контент: в 28 из 30 высокоразмерных наборов (геномика, изображения, масс-спектрометрия) священный рандом оказался сопоставим с обучением на всех фичах или на тех, что отобрали лучшими FS-методами. Конечно, возможно, так совпало и в выбранных датасетах "важность" просто размазывается по всем колонкам ровным слоем, но мне нравится думать что это перекликается с леммой Джонсона-Линденштрауса, которая показывает, что высокоразмерные данные сохраняют расстояния между точками даже при случайных проекциях. Вывод из работы такой: не паримся с отбором фичей, учим пачку моделей на случайных подпространствах и агрегируем.
  • 🤔 4
  • 👍 2
  • 😁 2
Post #272 418
P.S. Еще попробовал ROCAUC заменить на PRAUC, результат показался хуже, но может его стоило как-то иначе интерпретировать.
  • 🔥 1
Older posts →

About this channel

How can I read @datafunk without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Data Funk: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Data Funk have?
Data Funk (@datafunk) has 251 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Data Funk know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →