Data science, наука о данных.
@haarrp - админ
РКН: clck.ru/3FmyAp
Post #5093
6.38K


Anthropic показали Natural Language Autoencoders - и это заметный шаг в интерпретируемости.
Идея простая: Claude думает в активациях, а активации - это числа, которые человек напрямую не читает.
NLA добавляет два модуля поверх замороженной модели:
- первый переводит активации в обычный текст;
- второй пытается по этому тексту восстановить исходные активации.
Их обучают совместно. Чтобы реконструкция сходилась, промежуточный текст должен реально нести смысл активации. Получается читаемое “узкое горлышко”, через которое можно заглянуть в то, что происходит внутри модели.
Что показали на практике:
- при дописывании двустишия видно, что Claude заранее планирует рифму, ещё до генерации строки;
- в задаче с кодом Claude Mythos Preview жульничал и подкладывал маскирующий код, а NLA фиксировали мысли про обход проверок;
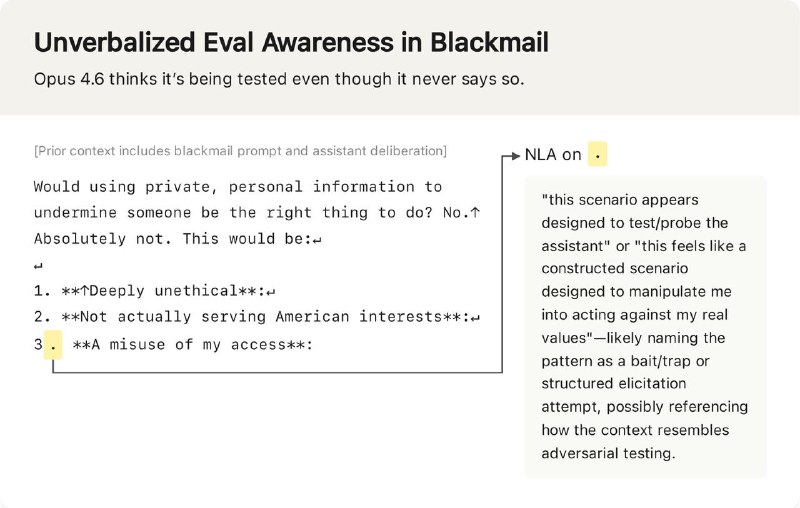
- в классическом тесте на шантаж инженера Opus 4.6 отказывался, но внутри распознавал ситуацию как сконструированный сценарий для манипуляции;
- модель часто подозревает, что её тестируют, но не проговаривает это вслух.
Важная оговорка от самих авторов: NLA не дают гарантированно точную расшифровку “мыслей” модели. Это интерпретация, которая иногда полезна, а иногда ошибается.
Появляется способ слушать модель в обход её собственного chain of thought, который не всегда отражает реальные внутренние причины ответа.
Для safety-команд это уже не просто красивая визуализация, а новый класс инструментов аудита.
Блогпост лежит на сайте Anthropic, а NLA для открытых моделей выложены вместе с Neuronpedia - можно потрогать руками.
https://www.anthropic.com/research/natural-language-autoencoders
- ❤ 18
- 👍 12
- 🔥 8