
Z.ai показала, где на самом деле ломаются LLM в продакшене
GLM-5 в продакшене начала иногда выдавать мусор: странные символы, повторы, редкие иероглифы в неожиданных местах. На тестах всё было чисто, метрики зелёные, а под реальной нагрузкой всплывали редкие артефакты.
Команда Z.ai пошла не в дообучение модели, а в inference stack. И нашла проблему , которая была в инфраструктуре.
Первый баг - гонка данных в KV Cache. При параллельной обработке запросов кэш ключей и значений иногда читался и перезаписывался не в том порядке. Модель получала испорченный контекст - и начинала «галлюцинировать».
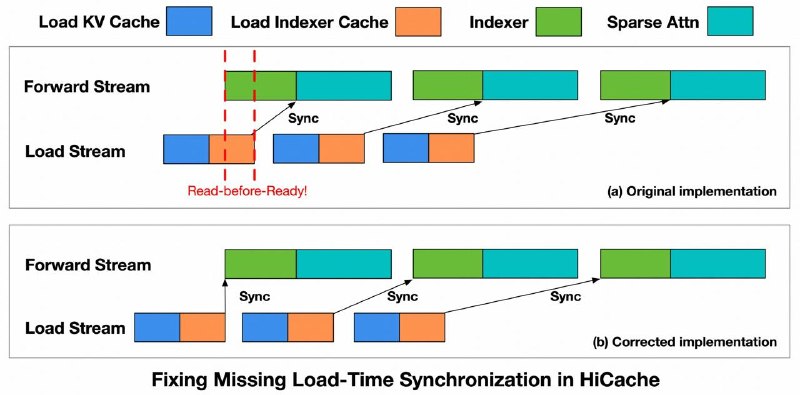
Второй баг - рассинхрон в HiCache. Иерархический кэш должен ускорять инференс, но при некоторых паттернах нагрузки сам становился источником ошибок между уровнями кэша.
Третий важный кусок - LayerSplit. Z.ai перераспределила слои модели по вычислительным ресурсам так, чтобы железо меньше простаивало. Результат - throughput вырос до 132%.
Качество LLM в продакшене зависит не только от размера модели. Его решают KV Cache, синхронизация, scheduler, layout слоёв, редкие edge cases и поведение системы под нагрузкой.
Бенчмарки показывают, насколько модель сильна в идеальных условиях.
Продакшен показывает, насколько вся система готова к реальному миру.
z.ai/blog/scaling-pain
Post #5074
6.48K



- 👍 13
- ❤ 9
- 🔥 8