
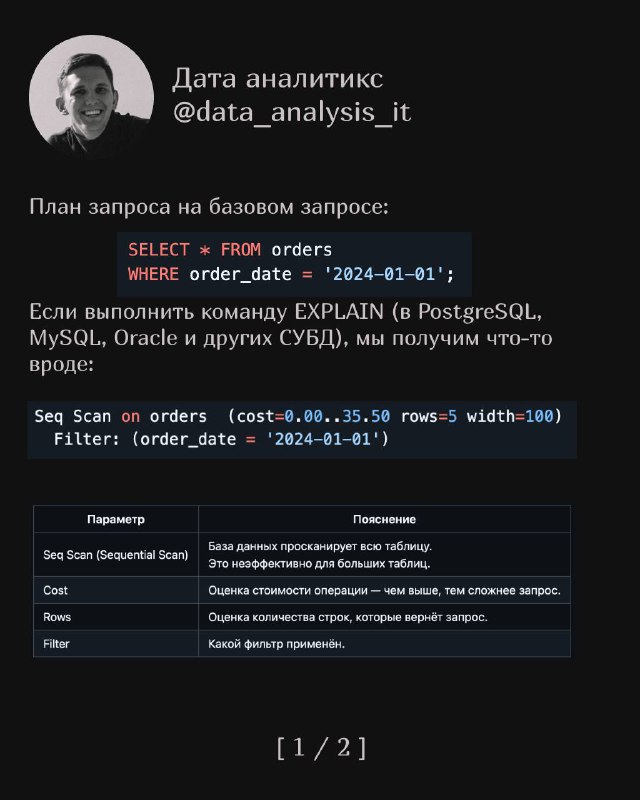

Давайте разберем эту историю на примере базового запроса
SELECT * FROM orders
WHERE order_date = '2024-01-01';
Если выполнить команду EXPLAIN (в PostgreSQL, MySQL, Oracle и других СУБД), мы получим что-то вроде:
Seq Scan on orders  (cost=0.00..35.50 rows=5 width=100)
  Filter: (order_date = '2024-01-01')
Seq Scan (Sequential Scan): База данных просканирует всю таблицу orders. Это неэффективно для больших таблиц.
• Cost: Оценка стоимости операции — чем выше, тем сложнее запрос.
• Rows: Оценка количества строк, которые вернёт запрос.
• Filter: Какой фильтр применён.
Если бы был индекс на order_date, запрос мог бы использовать Index Scan вместо полного сканирования таблицы.
Как интерпретировать план выполнения?
1. Типы сканирования:
• Seq Scan: Последовательное сканирование таблицы. Медленно на больших таблицах.
• Index Scan: Использует индекс, значительно быстрее для фильтров.
• Bitmap Index Scan: Сканирование индекса для поиска подходящих строк, объединяя их в блоки.
2. Объединение данных (JOIN):
• Nested Loop: Перебирает каждую строку одной таблицы и ищет совпадения в другой (подходит для небольших наборов данных).
• Hash Join: Создаёт хэш-таблицу из одной таблицы, затем ищет совпадения. Быстро для больших таблиц.
• Merge Join: Сортирует обе таблицы и объединяет их по порядку. Эффективно для уже отсортированных данных.
3. Операции сортировки:
• Sort: Указывает, что данные сортируются, что может быть дорогостоящей операцией.
4. Оценка стоимости:
• Общая стоимость включает чтение данных с диска, использование памяти и процессора.
Как сделать запросы эффективнее?
1. Используйте индексы.
• Создайте индексы на столбцах, которые часто участвуют в фильтрации, сортировке или JOIN.
CREATE INDEX idx_order_date ON orders(order_date);
2. Пишите запросы проще.
• Разделяйте сложные запросы на несколько шагов.
3. Не выбирайте лишние данные.
• Вместо SELECT * выбирайте конкретные столбцы:
SELECT order_id, order_date FROM orders;
4. Изучайте план выполнения.
• Перед оптимизацией всегда анализируйте, какие операции занимают больше всего ресурсов.
Интересные моменты из реальной практики
1. Проблема с JOIN
В одной из задач JOIN двух больших таблиц занимал часы. После анализа плана выполнения понял, что надо прикрутить индексы. После их добавления запрос стал выполняться пару минут.
2. Over-indexing
Слишком много индексов может замедлить операции INSERT и UPDATE. Анализ плана выполнения помогает понять, какие из них реально используются.
Важный поинт 1
Оптимизатор не всегда прав. Иногда оптимизатор выбирает неэффективный план. В таких случаях можно использовать хинты для принудительного выбора
Важный поинт 2
Вы как аналитик, оооочень редко будете работать прям с тем чтобы изучать план запроса и искать как его сделать лучше.
Обычно запросы не супер большие, либо под них есть удобные таблицы. И даже если вы не оптимизированно напишите запрос он будет крутиться ну пусть 10 минут вместо каких-нибудь 3. (Опять же ситуации разные могут быть)