TGViewer
Channel Public Channel
Computer Vision News

Computer Vision News

@cvision_course

Subscribers
303
Photos
413
Videos
98
Links
386
Recent Posts 13 shown
Post #649 48

Forwarded from Заметки Computer Vision инженера

Надо скзать что софт в эдж девайсах просто летит с какой-то суперсветовой скоростью. Я тут понял что в Qualcomm добавили поддержку моделей для роботов на NPU даже на дешевый/средний класс устройств.
Просто вау.
Изначально хотел проверить а можно ли VLM запускать на OAK4, а нашёл что там уже можно и VLA достаточно сложные. Короче вместо меди оказалось что-то поинтереснее.
https://youtu.be/Lyif8HH0Dn0
Теперь надо понять где это использовать:)
Post #648 105

Forwarded from ODS Events

Привет!

Рады сообщить, что 🦜 ODS совместно с Международным университетом информационных технологий запустили соревнование по написанию кода ИИ-агентами - SWE MERA Challenge.

Соревнование пройдет в три этапа:
✅ на первом этапе участникам с помощью любых агентов предстоит решить представленные задания на своей стороне;
✅ на последующих этапах то же самое нужно будет делать уже в изолированном окружении.

⭐️Для Топ-3 участников будет дана возможность представить свою работу на конференции по программной инженерии ICSE 2027!

Присоединяйтесь к соревнованию по 🔗ссылке!
Post #647 118

Forwarded from Ekaterina Trofimova

Рады поделиться нашей новой работой! Вместе с Денисом Зуенко @zuenko и Ильвирой Хайдаровой мы опубликовали в IEEE Access статью Oil Spill Segmentation in SAR Data Using ViT-UNet: Performance and Practical Insights.

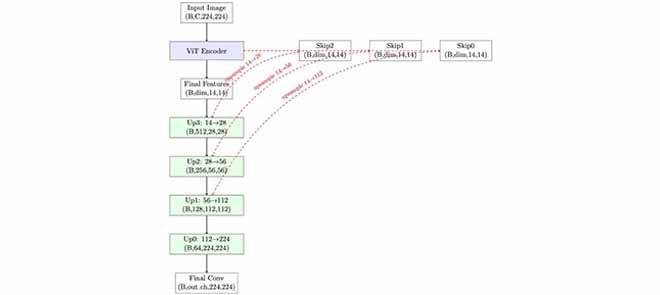
Работа посвящена системе для сегментации нефтяных пятен на радарных снимках (SAR). Задача критична для экологического мониторинга океана. Особенность подхода — гибридная архитектура ViT-UNet, где skip-connections идут не только с глубоких слоёв энкодера (как обычно делают), а сразу с четырёх уровней (2, 5, 8, 11), каждый из которых улавливает свой масштаб: от шумоподавления до глобального контекста состояния моря. Такая топология при абсолютно том же числе параметров и FLOPs даёт прирост mIoU почти на 5 п.п. по сравнению с «глубокой» версией той же модели.

Отдельным вкладом является ручные правки разметки популярного публичного бенчмарка SOS (больше трети масок в нём содержали систематические ошибки: с ложными срабатываниями, пропущенными пятнами и неточными границами).
Post #646 112

Forwarded from Machinelearning

🐠Sakana AI представила PC-ALM - метод обучения глубоких нейросетей без классического обратного распространения ошибки.

Главный результат: PC-ALM смог обучать нейросети глубиной до 1000 слоёв, используя только локальные взаимодействия между соседними слоями.

Обычное глубокое обучение почти полностью опирается на backpropagation: ошибка считается на выходе сети, после чего градиенты передаются назад через все слои.

PC-ALM работает иначе.

Каждый слой рассматривается как локальная динамическая система, которая пытается уменьшить собственную ошибку предсказания. Вместо глобального прохода градиента используются:

- локальные ошибки предсказания
- множители Лагранжа
- расширенный лагранжиан
- локальная динамика состояний
- PI-регуляция внутри каждого слоя

Метод вырос из predictive coding — подхода, популярного в NeuroAI. В predictive coding каждый слой постепенно корректирует своё состояние так, чтобы уменьшать рассогласование с соседними слоями.

Проблема в том, что в очень глубоких сетях такие сигналы плохо распространяются: информация об ошибке с выхода сети затухает раньше, чем достигает внутренних слоёв.

PC-ALM добавляет специальные двойственные переменные — по сути дополнительные нейроны, представляющие множители Лагранжа. Они помогают передавать сигнал ошибки через большое число слоёв.

Авторы связывают этот подход с классической работой Яна Лекуна 1988 года, где множители Лагранжа для многослойной сети можно связать с градиентами функции потерь.

В результате получается обучение, где глобальная задача оптимизации раскладывается на множество локальных динамических процессов.

Особенно хорошо PC-ALM показал себя на очень глубоких и узких сетях, где обычный predictive coding начинает ломаться.

Помимо NeuroAI, подход может быть интересен для нейроморфного железа: там локальные вычисления и физическая динамика потенциально дешевле классического backpropagation на GPU.

Блог: https://pub.sakana.ai/pc-alm/

Статья: https://arxiv.org/abs/2605.31022

Код: https://github.com/SakanaAI/pc-alm
  • 👍 1
Post #645 342

Forwarded from Нейродвиж

Научные статьи теперь можно читать без боли — и для этого не придётся скачивать PDF или мучить нейронку промптами 😮

Открываем нужную работу на arXiv и меняем в адресе arxiv на quickarxiv — cервис превратит академическое полотно в аккуратную страницу с понятным объяснением, иллюстрациями и короткой выжимкой главного.

Идеальный чит-код для студентов 👌
  • 🔥 1
Post #642 408

Forwarded from Machinelearning

🌟 Turbovec: библиотека векторного поиска на основе гугловского TurboQuant

Библиотека написана на Rust, есть привязки для Python, а в основе - TurboQuant, алгоритм сжатия векторов, который Google описали в статье, принятой на ICLR 2026.

Сама библиотека к Google отношения не имеет, это независимая реализация чужого алгоритма.


🟡Turbovec сжимает данные примерно в восемь раз

Коллекция из 10 миллионов документов, занимающая в исходном виде 31 гигабайт, умещается в 4. Поиск при этом, как утверждает автор, идёт быстрее, чем в FAISS - одного из самых распространённых инструментов в этой области.

По замерам turbovec обгоняет FAISS в среднем в 3,4-3,5 раза при 4-битном сжатии и на 20-26% при 2-битном, в зависимости от железа.

🟡Удобные мелочи

Индекс не нужно предварительно обучать - векторы просто добавляются по мере поступления.

Сохранение инкрементальное, на диск уходит только то, что изменилось с прошлого раза, поэтому даже на большом индексе это занимает миллисекунды.

Поиску можно передать список разрешённых документов - скажем, чтобы пользователь видел только свои файлы.

Удаление работает по постоянным идентификаторам, ссылки на записи не плывут.

Тем, кто уже сидит на LangChain, LlamaIndex, Haystack или Agno, автор предлагает готовые адаптеры - меняется одна строка импорта, остальной код остаётся как был.


📌Лицензирование: MIT License


🖥 Github


@ai_machinelearning_big_data

#AI #ML #VectorSearch #TurboQuant #Rust
Post #638 225

Forwarded from эйай ньюз

Открытая MoE-видеомодель MAGI-2 Preview от Sand.ai

Разработчики из Sand.ai выложили в открытый доступ веса и код инференса MAGI-2 Preview. Модель построена на single-stream архитектуре и генерирует 10-секундные ролики сразу вместе с синхронной аудиодорожкой.

Внутри применили редкий для таких моделей fine-grained MoE. При суммарном объеме в 114B параметров на каждый токен активируется всего 6B. По объему вычислений на шаг это в разы легче плотного MiniMax H3 (33B), благодаря чему стоимость инференса упала в ~10 раз, а модель заскочила на 6 место в лидерборде Artificial Analysis.

Сам пайплайн генерации двухстадийный. Сначала базовая модель генерирует видео в низком разрешении, а затем refiner апскейлит результат до 1080p.

Пока это не конкурент MiniMax H3 в плане локальной доступности. Квантованный H3 влезает в одну карту на 24GB (RTX 3090/4090), тогда как для MAGI-2 нужно заметно больше ресурсов. Зато у облачных провайдеров за счет всего 6B активных параметров инференс по API будет значительно дешевле dense моделей, да и у такой архитектуры хороший потенциал для скейлинга.

Техрепорт
Код
Веса

@ai_newz
Post #635 270

Forwarded from Machinelearning

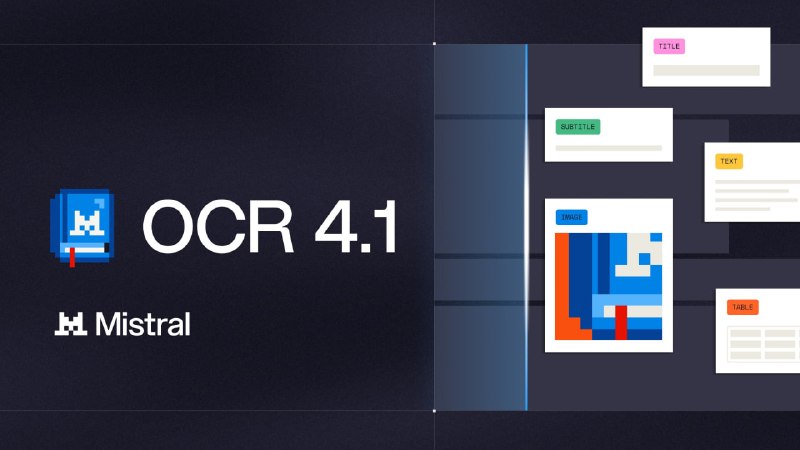
✔️ Mistral обновила OCR-модель до версии 4.1

Главный упор сделали на обработку перегруженных страницы, где текст, изображения и подписи идут плотно и наслаиваются друг на друга.

По данным Mistral, модель точнее определяет границы каждого элемента - рамки не съезжают, изображения не наезжают одно в другое по ошибке.

На нагруженных технических диаграммах модель реже теряет блоки, а текстовые выноски считывает как самостоятельные объекты, а не сливает в один массив.

Отдельно заявлена работа с многоколоночными документами, OCR 4.1 сохраняет исходную структуру страницы и отдает каждую колонку отдельной областью текста.

В настроенных процессах тем, кто пользуется моделью, менять ничего не нужно. Алиас mistral-ocr-latest уже переводит существующие интеграции на новую версию.

Руками модель можно попробовать в Mistral Studio.


@ai_machinelearning_big_data

#news #ai #ml
Post #633 226

Forwarded from Yandex for ML

🛎 Через час начинаем ML Global Recap

Вместе подведём ключевые итоги ICML и других международных конференций, поделимся своими инсайтами и выводами. Разложим по полочкам, что произошло в ML-индустрии за первое полугодие 2026 года.

В программе — доклады руководителей разных команд Яндекса:

⚪️ Артём Бабенко, руководитель Yandex Research, расскажет о развитии Tabular DL

⚪️ Дмитрий Мокеев, руководитель группы качества претрейна Alice AI в Яндекс Поиске, разберёт тренды и вызовы в ризонинге

⚪️ Иван Дёгтев, руководитель аналитики Alice AI LLM в Яндекс R&D, поделится новыми подходами и стандартами в оценке качества моделей

⚪️ Андрей Бежин, руководитель службы ML-инфраструктуры в Яндекс R&D, расскажет об оптимизации LLM-инференса

💻 Подключайтесь к онлайн-трансляции:

🔛 Яндекс Плеер
🔛 Ютуб

🛄 Ждём вас!

Подписывайтесь:
💬 @Yandex4ML
📹 @YandexML
Post #632 177

Forwarded from КПД

📄 Блогпост

🌵 Стартап Cactus Compute выпустил крохотную модель Needle 2 с весом чекпоинта всего 14 Mb для tool calling и работы со структурированными входа для edge устройств.

Исходная модель имеет 45M параметров, поверх нее применяется CQ-2bit квантизация (некая проприетарная техника).

Квантизация получается в процессе обучения (Quantization Aware Training).

⚡ Скорость

На префилле скорость 800+ tok/s, и 500+ tok/s на декоде на Raspberry Pi 5. Еще оно якобы быстро генерит на VR устройствах и Samsung-ах.

🏗️ Архитектура

Архитектура основана на ихней же работе Simple Attention Network. Там немало архитектурных прибамбасов:

• mHC
• Engram
• Hadamard MLP. Дабы сэкономить на параметры, параметризуют веса как произведение диагональной на Адамарову матрицу.
• GQA + Sliding Attention + синки для тулов

Needle 2 производит меньше операций на токен против традиционной трансформерной архитектуры.

📚 Обучение

На обучение потратили 115B токенов из проприетарных токенов и 38B на посттрейн, что на порядки меньше, чем у LFM.

📊 Бенчмарки

Модель оценивают на бенчмарках:

• Mobile Actions
• Droid Call
• Seal-Tools
• BFCL v4

🎯 Оно выходит по качеству близко к Function Gemma 270M, LFM 2.5 230M, Apple FM, будучи при этом гораздо меньше.
  • 🔥 1
Post #631 190

Forwarded from CV Time

Курс по Visual GenAI от Yandex Research и ШАД

Авторы CV Time не только пишут обзоры статей о компьютерном зрении, но и создают обучающие курсы.

Сегодня делимся курсом ШАДа «Генеративные модели в компьютерном зрении», который ведёт Дмитрий Баранчук, руководитель группы GenAI в Yandex Research, вместе с праймовой командой исследователей в этой области.

Будет полезно тем, у кого есть базовые знания по генеративкам и желание разобраться глубже:

• в теории диффузионных моделей, эффективных методах их обучения и семплирования;
• в новых гибридных моделях на основе диффузии для генерации изображений, видео и 3D.

У курса есть открытый GitHub-репозиторий, где можно найти слайды, записи лекций и семинаров, а также домашние задания.

CV Time
  • 🔥 1
Post #630 192

Forwarded from КПД

Введение в Квантизацию.pdf6.1 MB
📚 Презентация про квантизацию с моего выступления на нашей Hardware Efficiency Reading Group, где мы обсуждаем статьи, идеи и практические аспекты эффективного глубокого обучения.

🎥 Записи и 📋 программу прошлых семинаров можно найти здесь.

🗓️ Семинар проходит (почти) каждый понедельник с 13:00 до 14:00.

📢 Группа с анонсами и материаламитут.

Будем рады всем, кто интересуется эффективным глубоким обучением, GPU, CUDA, оптимизацией и современными ML-системами! 🚀
  • 🔥 1
Older posts →

About this channel

How can I read @cvision_course without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Computer Vision News: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Computer Vision News have?
Computer Vision News (@cvision_course) has 303 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Computer Vision News know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →