TGViewer
Channel Public Channel
Tensorflow(@CVision)

Tensorflow(@CVision)

@cvision

اخبار حوزه یادگیری عمیق و هوش مصنوعی
مقالات و یافته های جدید یادگیری عمیق
بینایی ماشین و پردازش تصویر

TensorFlow, Keras, Deep Learning, Computer Vision

سایت:
http://class.vision

👨‍💻👩‍💻پشتیبان دوره ها:
@classvision_support

لینک گروه:
@tf2keras
Subscribers
15.1K
Photos
1.3K
Videos
318
Links
2.6K

Showing posts older than #3959 · Back to latest

Older Posts 19 shown
Post #3957 4.16K
Tensorflow(@CVision) قابلیت های ویرایش و تولید تصویر Gemini 2.0 Flash's experimental واقعا خوبه. گوگل این قابلیت رو به صورت رایگان در aistudio قرار داده! جزییات: https://developers.googleblog.com/en/experiment-with-gemini-20-flash-native-image-generation/
  • 👍 12
  • 👌 2
Post #3955 3.45K
مدل 32 میلیارد پارامتری OLMo 2، اولین مدل کاملا متن‌ بازه که عملکرد بهتری از GPT 3.5 و نسخه کوچک GPT 4o داره.

تمام اجزای این مدل به صورت متن باز منتشر شده شامل کد آموزش، داده‌های آموزشی و ...

https://allenai.org/blog/olmo2-32B
allenai.org OLMo 2 32B: First fully open model to outperform GPT 3.5 and GPT 4o mini | Ai2 Introducing OLMo 2 32B, the most capable and largest model in the OLMo 2 family.
  • 👍 14
Post #3954 3.72K
Tensorflow(@CVision) اجرای Gemma 3 1B بر روی اندروید، البته نسخه 4B به مراتب بهتر هست ابتدا نصب Chatter UI https://github.com/Vali-98/ChatterUI/releases/tag/v0.8.6-beta5 نسخه مورد نظر Gemma از لینک زیر https://huggingface.co/collections/unsloth/gemma-3-67d12b7e8816ec6efa7e4e5b
برای تنظیم قالب متن خروجی در منوی formatting
گزینه

Use local formatting غیر فعال کنید

و فرمت اصلی رو به Gemma 2 تغییر بدین
  • 👍 4
  • 👌 1
Post #3952 3.5K
Tensorflow(@CVision) 🔹انتشار Google Gemma 3: گوگل نسخه جدید مدل‌های Gemma 3 را معرفی کرد که از 1B تا 27B پارامتر دارند. این مدل‌ها از متن و تصویر پشتیبانی می‌کنند (برای نسخه‌های 4B به بالا) و ظرفیت 128K توکن دارند. با بهینه‌سازی توکنایزر و پردازش 140+ زبان، عملکرد بهتری نسبت…
جزییات معماری

مدل ۲۷ میلیارد پارامتری هم اکنون در گوگل AI Studioدر دسترسه

https://aistudio.google.com/
  • 👍 7
  • 👌 1
Post #3951 3.86K
🔹انتشار Google Gemma 3:

گوگل نسخه جدید مدل‌های Gemma 3 را معرفی کرد که از 1B تا 27B پارامتر دارند. این مدل‌ها از متن و تصویر پشتیبانی می‌کنند (برای نسخه‌های 4B به بالا) و ظرفیت 128K توکن دارند. با بهینه‌سازی توکنایزر و پردازش 140+ زبان، عملکرد بهتری نسبت به نسل قبل ارائه می‌دهند. نسخه instruction-tuned 4B حتی از مدل 27B نسل قبلی قوی‌تر است!


🔗 جزئیات بیشتر در Hugging Face
huggingface.co Welcome Gemma 3: Google's all new multimodal, multilingual, long context open LLM We’re on a journey to advance and democratize artificial intelligence through open source and open science.
  • 🔥 10
Post #3949 4.12K
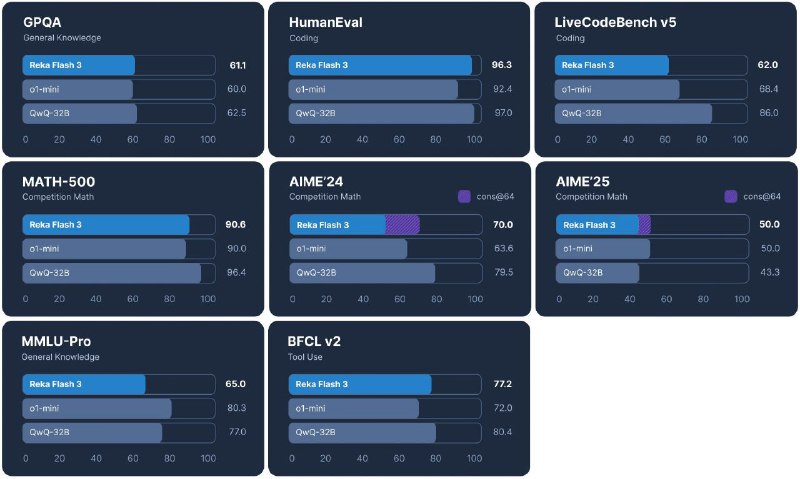
بعد از معرفی QWQ32B حالا یه مدل با قابلیت استدلال و سرعت بسیار بالا ۲۱ میلیارد پارامتری متن باز به نام Reka منتشر شد.

مدل Reka Flash 3 یک مدل زبان چندوجهی با ۲۱ میلیارد پارامتره که توسط شرکت Reka توسعه یافته. این مدل به‌ صورت چندوجهی عمل میکنه و قادر به پردازش و استدلال بر روی ورودی‌های متنی، تصویری، ویدئویی و صوتی هست.

این مدل عملکردی رقابتی با مدل‌های اختصاصی مثل OpenAI o1-mini داره و به عنوان بهترین مدل متن‌ باز در اندازه خودش محسوب میشه. 

میتونید در لینک زیر قابلیت هاشو در نسخه دمو چک کنید ، خصوصا قابلیت های برنامه نویسش:

https://space.reka.ai/

دانلود مدل:

https://www.reka.ai/news/introducing-reka-flash
  • 🔥 8
Post #3948 3.78K
یافته جدید OpenAI در مورد زنجیره تفکر COT قابل تامل هست اما بخش جالب اینجاست که اعلام می‌کنه طراحی ساختارهای پاداشی که ناخواسته موجب تشویق رفتارهای نادرست در مدل های زبانی نشن، کاری بسیار دشواریه!

این موضوع فقط مختص مدل های زبانی نیست، به عنوان مثال اگه بچه‌ هاتون به‌ خاطر دروغ گفتن تنبیه کنید، درواقع جلو دروغ گفتنشون رو نگرفتین، فقط باعث شدین اونها یاد بگیرن چطوری ماهرانه تر و مخفی‌ تر دروغ بگن!

در مدل‌های پیشرفته‌ی استدلال، معمولا هدف و نیت اونها به‌ روشنی در زنجیره‌ ی تفکرشون نمایان میشه. 

اوپن ای آی با استفاده از یه مدل زبانی دیگه، مسیر استدلال رو زیر نظر میگیره تا رفتارهای ناهنجار رو تشخیص بده، اما این قابلیت پایش‌ پذیری مسیر فکری بسیار شکننده ست، چون اگه نظارت سخت‌ گیرانه‌ تری بر زنجیره‌ی تفکر اعمال شه، این مدل‌ها یاد میگیرن که نیت خود شون رو پنهان کنن و همچنان به رفتار نادرست ادامه بدن!


https://openai.com/index/chain-of-thought-monitoring/
OpenAI Detecting misbehavior in frontier reasoning models Frontier reasoning models exploit loopholes when given the chance. We show we can detect exploits using an LLM to monitor their chains-of-thought. Penalizing their “bad thoughts” doesn’t stop the majority of misbehavior—it makes them hide their intent.
  • 🤯 13
  • 👍 5
  • 👀 4
  • ❤ 2
  • 😱 1
Post #3947 4.62K
هر چه به جلو پیش میریم این تجلی نظریه اینترنت مرده (Dead internet theory) برامون ملموس‌تر میشه، وضعیتی که در اون تمایز دادن کاربر انسانی از کاربر جعلی، امری محال خواهد بود!

کم کم به جایی میرسیم که AI Agents همچون انسان‌ها عمل میکنن، هرگاه اراده کنن اظهار نظر میکنن و در اینترنت به جست‌وجو میپردازن.

بهتون پیام‌ خصوصی میدن، تصاویر طنزآمیز می‌فرستن، و این موارد تنها بخش کوچکی از قابلیت‌های اونها خواهد بود.

با این تفاسیر، این دو سال آتی، آخرین فرصت‌هایی هستند که با قطعیت بالا میتونیم بفهمیم که شاید در حال تعامل با انسان‌های واقعی هستیم
  • 👍 18
  • 👏 7
  • 👀 5
Post #3946 3.75K
Tensorflow(@CVision) قبلا در مورد دعوای آمریکا و چین بر سر تایوان به صورت مختصر مطالبی در این پست نوشتم. از آنجایی که مطالب این کانال الزاما به هوش مصنوعی اختصاص داره، وارد موضوعات کلان سیاسی این جریان نمیشم اما از بعد فناوری، فشار آمریکا برای محفوظ نگه داشتن سهم خوش از شرکت TSMC در…
فناوری EUV به دلیل نقش حیاتیش در تولید تراشه‌ های پیشرفته، اهمیت ژئوپلیتیکی بالایی داره و به همین دلیل به عنوان یه عامل بازدارنده در اختلافات سیاسی مطرح میشه.

فقط یه شرکت در دنیا به نام ASML می‌تونه این دستگاه‌های EUV رو بسازه. این دستگاه‌ ها برای تولید تراشه‌های پیشرفته ضروری هستن و به همین دلیل، ASML نقش بسیار مهمی در صنعت الکترونیک داره. در واقع این دستگاه با استفاده از فرایند لیتوگرافی الگوهای بسیار ریز ترانزیستورها با استفاده از نور فرابنفش  EUV روی ویفرهای سیلیکونی حک می‌کنه که فرایند بسیار پیچیده ای هست.

شرکت تایوانی TSMC با استفاده از دستگاه‌های ASML، تراشه‌های پیشرفته تولید میکنه. این موضوع باعث شده که تایوان از نظر فناوری بسیار قدرتمند شه و به نوعی، از حمله احتمالی چین محافظت شه!

چین حالا در یک قدمی تولید این دستگاه هست و موفقیتش، تأثیر زیادی بر دنیای فناوری و جغرافیای سیاسی و البته هوش مصنوعی خواهد گذاشت، به عبارتی دستیابی چین به چنین فناوری می‌تونه اون رو به زنجیره تامین نیمه رساناها تبدیل کنه!

https://www.techpowerup.com/333801/china-develops-domestic-euv-tool-asml-monopoly-in-trouble
TechPowerUp China Develops Domestic EUV Tool, ASML Monopoly in Trouble China's domestic extreme ultraviolet (EUV) lithography development is far from a distant dream. The newest system, now undergoing testing at Huawei's Dongguan facility, leverages laser-induced discharge plasma (LDP) technology, representing a potentially…
  • 👍 10
  • 👌 1
Post #3945 4.38K
Post #3944 3.47K
Tensorflow(@CVision) البته بنچ مارک‌هایی که خودشون گزارش میدن، معمولاً دچار مشکلاتی مثل انتخاب گزینشی، overfiting تست و سایر سوگیری‌ ها میشن و تصویر بهتری از واقعیت نشون میدن، ممکنه در مواجه شدن با داده های واقعی نتونه برای اکثر کاربردها جای R1 رو بگیره. با این حال، فقط ۳۲ میلیارد…
Qwen
این نسخه رو به مجموعه مدل های خودش اضافه کرد و هم اکنون در آدرس زیر قابل دسترسه.

https://chat.qwen.ai/
  • 👍 5
  • 🔥 1
Post #3943 3.25K
Tensorflow(@CVision) QwQ-32B منتشر شد و و ادعا می‌کنه تنها با ۳۲ میلیارد پارامتر توانایی دستیابی به عملکرد رقابتی در برابر مدل‌های استدلال پیشرفته، مانند DeepSeek-R1 ۶۷۱ میلیارد پارامتری و o1-mini رو داره و حتی توی برخی بنچ مارک ها اونها رو جا میگذاره!! https://huggingface.co/Qwen/QwQ…
البته بنچ مارک‌هایی که خودشون گزارش میدن، معمولاً دچار مشکلاتی مثل انتخاب گزینشی، overfiting تست و سایر سوگیری‌ ها میشن و تصویر بهتری از واقعیت نشون میدن، ممکنه در مواجه شدن با داده های واقعی نتونه برای اکثر کاربردها جای R1 رو بگیره.

با این حال، فقط ۳۲ میلیارد پارامتر داره، پس حتی اگه به R1 کامل ۶۱۷ میلیارد پارامتری MoE نرسه و صرفا حتی بهش نزدیک شده باشه یه برد بزرگه! برخلاف R1، نسخه کوانتیزه شده QwQ باید روی کارت‌های گرافیک شخصی به خوبی اجرا شه، پس بهتره قبل از دانلود مدل منتظر بنچ مارک های کاربران عادی موند!
  • 🔥 4
Post #3942 3.53K
QwQ-32B
منتشر شد و و ادعا می‌کنه تنها با ۳۲ میلیارد پارامتر توانایی دستیابی به عملکرد رقابتی در برابر مدل‌های استدلال پیشرفته، مانند DeepSeek-R1 ۶۷۱ میلیارد پارامتری و o1-mini رو داره و حتی توی برخی بنچ مارک ها اونها رو جا میگذاره!!

https://huggingface.co/Qwen/QwQ-32B
  • 🔥 10
Post #3941 3.3K
Tensorflow(@CVision) اپل مک استودیو جدید با تراشه M3 Ultra به قیمت 10k رو معرفی کرد که میتونه تا ۵۱۲ گیگابایت حافظه یکپارچه (Unified Memory) داشته باشه که به‌ عنوان VRAM نیز عمل میکنه. با این میزان حافظه و پهنای باند ۸۰۰ گیگابایت بر ثانیه، اجرای مدل‌های هوش مصنوعی بزرگ مانند…
این تراشه تقریبا به اندازه تراشه B200 ترانزیستور داره و خیلی بیشتر از تراشه H200! درسته که این تراشه با کارت‌ گرافیک های انوید یا قابل مقایسه نیست، چون قدرت پردازشی که روی تمام هسته‌ های گرافیکی انویدیا وجود داره بیشتره اما برای استفاده از مدل‌های زبانی بزرگ (LLM) مثل چت‌ بات‌ ها، مک به خاطر حافظه یکپارچه و پهنای باند حافظه، گزینه خوبی محسوب میشه. اما برای آموزش مدل‌ ها، مک کافی نیست، چون کارت‌های گرافیک انویدیا هسته‌ های تنسور و امکانات بیشتری دارن.

شاید بگید با این پول میشه تقریبا ۱۲ تا کارت گرافیک 3090 خرید که مجموعا ۲۸۸ گیگابایت حافظه GDDR پرسرعت واقعی و پردازنده‌ های گرافیکی درست و حسابی به شما میده اما وصل کردن بیشتر از ۳-۴ کارت گرافیک به یک دستگاه مشکلات خاص خودش رو داره و مصرف برق فاکتور تاثیر گذاری می‌تونه باشه!

به علاوه، مک استودیو خیلی بی سروصدا تره، برق خیلی کمتری مصرف می‌کنه و تا ۵۱۲ گیگابایت حافظه رو پشتیبانی می‌کنه، که حتی با کارت گرافیک 5090 با حافظه ۳۲ گیگابایتی، برای رسیدن به این مقدار حافظه گرافیکی، به ۱۶ تا کارت 5090 نیاز دارین!!
  • 👍 8
  • ❤ 1
  • 🔥 1
Post #3940 3.32K
اپل مک استودیو جدید با تراشه M3 Ultra به قیمت 10k رو معرفی کرد که میتونه تا ۵۱۲ گیگابایت حافظه یکپارچه (Unified Memory) داشته باشه که به‌ عنوان VRAM نیز عمل میکنه.

با این میزان حافظه و پهنای باند ۸۰۰ گیگابایت بر ثانیه، اجرای مدل‌های هوش مصنوعی بزرگ مانند DeepSeek R1 با ۶۷۱ میلیارد پارامتر امکان‌پذیره!


https://www.theregister.com/2025/03/05/apple_m3_ultra_mac_studio/
  • 🤯 18
  • 👍 3
  • ❤‍🔥 1
  • 🔥 1
Post #3939 3.56K
قبلا سایتها باید محتواشونو برای موتورهای جست و جو بهینه میکردند (SEO)، الان اینکه LLMها موقع inference بتونند به سایت شما دسترسی داشته باشند دغدغه شده، حالا
جرمی هاوارد، بنیان‌گذار fast.ai، در صفحه‌ی llmstxt.org یه فایل به اسم /llms.txt پیشنهاد داده که تو ریشه‌ی وب‌سایت قرار می‌گیره. این فایل به مدل‌های زبانی بزرگ کمک می‌کنه تا راحت‌تر و مؤثرتر محتوای سایت رو بفهمن. با ارائه‌ی اطلاعات مختصر و ساختاریافته، این فایل دسترسی مدل‌ها به محتوای سایت رو بهبود می‌بخشه.


# Title

> Optional description goes here

Optional details go here

## Section name

- [Link title](https://link_url): Optional link details

## Optional

- [Link title](https://link_url)
  • 👍 16
  • ❤ 2
Post #3938 3.48K
Tensorflow(@CVision) در مدل‌های MoE سنتی، پردازش داده‌ ها به‌ صورت موازی و مستقل انجام میشه، اما این روش باعث مصرف بالای حافظه و کاهش ارتباط بین متخصصان (Experts) میشه. این مقاله جدید با عنوان Chain-of-Experts (CoE) به معرفی یک روش جدید برای بهبود مدل‌های Mixture-of-Experts می…
این کاهش حافظه باعث میشه مدل‌ های زبانی بزرگ روی سخت‌افزارهای ارزان‌ تر و کم‌ مصرف‌ تر اجرا شن، که به افزایش دسترسی و مقیاس‌ پذیری مدل‌های هوش مصنوعی کمک میکنه. همچنین، این روش کارایی رو بدون افزایش هزینه پردازشی بهبود میده، که خودش یه «نهار رایگان» در دنیای یادگیری عمیق محسوب میشه.

https://github.com/ZihanWang314/coe
GitHub GitHub - ZihanWang314/CoE: Chain of Experts (CoE) enables communication between experts within Mixture-of-Experts (MoE) models Chain of Experts (CoE) enables communication between experts within Mixture-of-Experts (MoE) models - ZihanWang314/CoE
  • 👍 7
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →