
اخبار حوزه یادگیری عمیق و هوش مصنوعی
مقالات و یافته های جدید یادگیری عمیق
بینایی ماشین و پردازش تصویر
TensorFlow, Keras, Deep Learning, Computer Vision
سایت:
http://class.vision
👨💻👩💻پشتیبان دوره ها:
@classvision_support
لینک گروه:
@tf2keras
Post #3937
3.19K
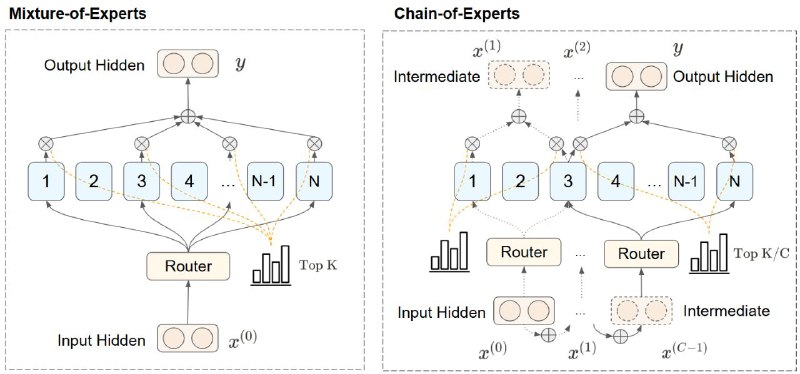
در مدلهای MoE سنتی، پردازش داده ها به صورت موازی و مستقل انجام میشه، اما این روش باعث مصرف بالای حافظه و کاهش ارتباط بین متخصصان (Experts) میشه.
این مقاله جدید با عنوان Chain-of-Experts (CoE) به معرفی یک روش جدید برای بهبود مدلهای Mixture-of-Experts می پردازه.
این مدل با جایگزینی ساختار موازی با یه مکانیزم تکراری و سریالی، ارتباط بین متخصصان رو برقرار میکنه.
در این روش، خروجی یک متخصص به ورودی متخصص بعدی منتقل میشه، که نتیجش این میشه که مدل از اطلاعات پردازش شده در مراحل قبل استفاده کنه. این کار نه تنها باعث بهبود دقت مدل، بلکه انعطافپذیری انتخاب متخصصان رو 823 برابر افزایش میده.
یکی از مهم ترین دستاوردهای CoE کاهش مصرف حافظه بین 17.6٪ تا 42٪ هست، چون دیگه نیازی به ذخیره سازی و پردازش همزمان تمام خروجی های متخصصان به صورت مستقل نیست.
- 👍 11


