TGViewer
Channel Public Channel
CORTEL

CORTEL

@cortel_cloud

Помогаем ИТ-директорам, DevOps и системным инженерам снижать TCO и поднимать SLA. Кейсы, инструменты и гайды.

Сайт:
https://cortel.cloud

Cотрудничество:
@ivan_cmo
Subscribers
4.07K
Photos
2K
Videos
165
Links
1.7K

Showing posts older than #2703 · Back to latest

Older Posts 20 shown
Post #2702 1.6K
🗞 Удобная шпаргалка по Linux CRON, которая всегда под рукой.

Компактно и наглядно 🥂

#полезное
  • 👍 9
  • ❤ 5
Post #2701 1.36K
🕔 Cron — это классический планировщик задач в Unix-подобных системах.

Он позволяет автоматически выполнять команды, скрипты или программы в заданное время: ежедневно, еженедельно, с точностью до минуты.

Без него пришлось бы вручную запускать резервное копирование, ротацию логов или обновление кеша.

⏱ Как работает cron

За расписание отвечает демон crond (cron daemon). Он запускается при старте системы и постоянно работает в фоне. Crond читает конфигурационные файлы — crontab (cron tables) — и в нужный момент выполняет указанные команды.

⏱ Существуют два уровня crontab:

— Системные — лежат в /etc/crontab и в каталогах /etc/cron.d/, /etc/cron.daily/, /etc/cron.hourly/ и т.д. Требуют указания пользователя, от которого запускается задача.
— Пользовательские — создаются командой crontab -e для каждого пользователя отдельно. Запускаются от имени этого пользователя.

⏱ Формат записи crontab

Каждая строка в crontab описывает одно задание и состоит из пяти полей времени и команды:


* * * * * команда
│ │ │ │ │
│ │ │ │ └── день недели (0-7, где 0 и 7 = воскресенье)
│ │ │ └──── месяц (1-12)
│ │ └────── день месяца (1-31)
│ └──────── час (0-23)
└────────── минута (0-59)


⏱ Специальные символы:

— * — любое значение (каждую минуту, каждый час...)
— */n — каждые n единиц (например, */5 в поле минут — каждые 5 минут)
— , — перечисление (например, 1,15 в поле дня — 1-й и 15-й дни)
— - — диапазон (например, 9-17 в поле часа — с 9 до 17 включительно)

⏱ Управление пользовательским crontab


crontab -e # открыть текущий crontab для редактирования (или создать новый)
crontab -l # показать текущие задания
crontab -r # удалить весь crontab
crontab -u username -l # (от root) посмотреть crontab другого пользователя


⏱ Примеры заданий

Каждый день в 2:30 ночи

30 2 * * * /home/user/backup.sh


Первого числа каждого месяца в полночь

0 0 1 * * /home/user/cleanup.sh


Cron остаётся самым простым и надёжным способом автоматизации в Linux. Один раз настроил — и задачи выполняются годами без участия человека. Главное — не забывать проверять логи и не допускать конфликтов при одновременном запуске тяжёлых заданий.

#линуксятина
  • 👍 13
  • 🔥 5
  • 👏 3
  • ❤ 1
Post #2700 1.16K
⭐️ Karpenter — opensource-инструмент для автоматического масштабирования кластера Kubernetes, разработанный в AWS и переданный в CNCF.

Он мгновенно создаёт новые узлы (ноды) под неразмещённые поды, выбирая оптимальные типы инстансов и удаляя неиспользуемые, экономя ресурсы и деньги.

⚙️ Основной функционал

— Мгновенное создание узлов: при появлении подов, которые не могут быть запланированы, Karpenter за секунды запускает новые узлы (вместо минут, как у Cluster Autoscaler).
— Умный выбор инстансов: автоматически подбирает тип, размер, архитектуру (amd64/arm64), зону доступности на основе требований подов (resources, nodeSelector, affinity, topologySpread).
— Поддержка разнообразных ресурсов: GPU, специализированные инстансы (например, для машинного обучения).
— Автоматическая консолидация: удаляет неэффективные узлы и перепаковывает их поды на другие, оптимизируя заполнение кластера.
— Настройка через CRD: конфигурация описывается в ресурсах Provisioner и NodeTemplate.

👀 Ключевые преимущества

✅Скорость — Karpenter не ждёт, пока освободятся ресурсы на существующих узлах — он сразу создаёт новый, идеально подходящий под требования пода. Это особенно важно для burst-нагрузок и пакетных задач.
✅Гибкость — Позволяет точно контролировать, какие типы узлов используются, задавать limits по стоимости, выбирать между spot и on-demand, а также учитывать topologySpreadConstraints для распределения по зонам.
✅Отказ от групп узлов — В отличие от Cluster Autoscaler, которому нужны предопределённые группы. Karpenter управляет каждым узлом индивидуально. Это упрощает конфигурацию и убирает ограничения на размер группы.

Karpenter переворачивает представление о масштабировании: он не просто добавляет узлы, а строит инфраструктуру ровно под те задачи, которые есть прямо сейчас.

👉 Git
#полезное
  • 👍 4
  • 🔥 3
  • 👏 2
Post #2699 1.06K
Kube-scheduler: как Kubernetes назначает поды на ноды

При создании пода в Kubernetes он не появляется на конкретной ноде автоматически.
За выбор подходящего узла отвечает kube-scheduler — компонент control plane, который принимает решение, на какую ноду отправить новый или ожидающий назначения под.

🔭 Что делает kube-scheduler?

Основная задача — найти для каждого пода ноду, которая:
— соответствует всем жёстким требованиям (например, достаточно CPU и памяти, нужные метки, отсутствие запрещающих taint'ов);
— является наилучшей по ряду критериев (например, более свободная, с меньшей загрузкой, предпочитаемая по affinity).

После выбора scheduler сообщает API-серверу о назначении, и kubelet на выбранной ноде запускает под.

✍️ Как происходит планирование:

Процесс планирования логически делится на два этапа:

📌 Фильтрация (Predicates / Filtering)
Отсеиваются все ноды, которые не могут запустить под.
Проверяются:
🔵достаточно ли свободных ресурсов (CPU, память, диски, порты);
🔵соответствуют ли нода меткам, указанным в nodeSelector или nodeAffinity;
🔵не запрещают ли taints запуск пода без соответствующих tolerations;
🔵соблюдены ли правила Pod Affinity/Anti-Affinity;
🔵не конфликтуют ли с уже запущенными подами (например, занятые порты hostPort).

Результат — список подходящих нод.

📌 Оценка (Scoring / Prioritization)
Каждая оставшаяся нода получает баллы по различным критериям. Чем больше баллов, тем предпочтительнее нода.
Критерии могут быть разными:
🔵количество свободных ресурсов после запуска пода,
🔵сбалансированность использования ресурсов,
🔵близость к другим заданным подам (для уменьшения сетевых задержек), 🔵выполнение правил предпочтений (preferred affinity) и т.д.

По итогам выбирается нода с наибольшей суммой баллов.

Если подходящих нод нет — под остаётся в статусе Pending, и scheduler будет периодически повторять попытки.


⚙️ Ключевые механизмы управления планированием

💬 nodeSelector
— Простейший способ указать, что под должен быть размещён на ноде с определённой меткой.

💬 Affinity и Anti-Affinity
— Более выразительные правила, поддерживающие условия и уровни строгости (requiredDuringSchedulingIgnoredDuringExecution — жёсткое требование, preferredDuringSchedulingIgnoredDuringExecution — предпочтение).

— Node affinity: привязка к характеристикам ноды
— Pod affinity/anti-affinity: привязка к расположению других подов (например, требование запускать под на той же ноде, где уже работает под с меткой app=frontend, или, наоборот, избегать одной ноды с подами другого приложения).


💬 Taints и Tolerations — Taints (метка) наносятся на ноды и отталкивают поды, у которых нет соответствующих tolerations (переносимости). Позволяет выделять ноды под специальные задачи (например, только для GPU-нагрузок) или защищать мастер-ноды.

💬 Resource Requests и Limits — Scheduler учитывает запрошенные подом ресурсы (requests) и доступные на ноде. Без указания requests под может быть запланирован на перегруженную ноду, что приведёт к нехватке ресурсов для других.

💬 Приоритеты подов (Pod Priority and Preemption) — Поды можно разделять по приоритетам. Если высокоприоритетный под не может быть запланирован, scheduler может вытеснить (preempt) один или несколько низкоприоритетных подов с ноды, чтобы освободить место.

Kube-scheduler — это мозг Kubernetes по размещению подов. Он не просто выбирает первую попавшуюся ноду, а принимает взвешенное решение на основе множества факторов. Управление его поведением через манифесты позволяет строить эффективные и надёжные системы, максимально использующие мощности кластера.

#заметкиИнженера
  • 👍 6
  • ❤ 5
  • 🔥 2
Post #2698 1.08K
🌐 HTTP-методы

Шпаргалка показывает, какие команды клиент отправляет серверу при работе с API и веб-приложениями — что делает каждый метод и в каких случаях он используется.

🗣 GET
— получение данных.


Используется, когда клиенту нужно запросить ресурс у сервера: страницу, карточку товара, список пользователей. Метод не должен изменять данные на сервере.

🗣 POST
— создание нового ресурса.


Применяется для отправки данных на сервер: создание заявки, пользователя, заказа, комментария. Повтор одного и того же POST-запроса может создать дубликаты.

🗣 PUT
— полное обновление ресурса.


Сервер получает новую полную версию объекта и заменяет ею текущую. Используется, когда нужно обновить ресурс целиком.

🗣 PATCH
— частичное изменение.


Подходит для точечного обновления: например, изменить только имя пользователя, статус заказа или один параметр настройки без перезаписи всего объекта.

🗣 DELETE
— удаление ресурса.


Клиент сообщает серверу, что объект нужно удалить. Например, удалить пользователя, запись, файл или товар из каталога.

🗣 HEAD
— запрос без тела ответа.


Работает как GET, но сервер возвращает только заголовки. Удобен для проверки доступности ресурса, даты изменения или размера файла без загрузки содержимого.

🗣 OPTIONS
— проверка доступных действий.


Позволяет узнать, какие методы поддерживаются для конкретного ресурса. Часто используется при CORS и предварительных запросах в браузере.

🗣 CONNECT
— создание туннеля.


Используется для установки соединения через прокси-сервер, например при работе с HTTPS-трафиком.

🗣 TRACE
— диагностический запрос.


Возвращает запрос обратно клиенту, чтобы можно было проверить, как он проходит через промежуточные узлы. На практике используется редко.

#полезное
  • 👍 8
  • ❤ 3
  • 🔥 2
Post #2697 1.25K
🎙️ За неделю

📃 ERP-системы включили в КИИ
Правительство утвердило единый перечень типовых отраслевых объектов КИИ, куда включили ERP-системы. В документе они отдельно указаны для химической, металлургической, горнодобывающей, ракетно-космической и оборонной отраслей.

📃 Переход на российское оптоволокно перенесли до 2028 года
Минпромторг предлагает перенести обязательное использование российского оптоволокна на два года. Причина — отсутствие собственного производства.

📃 Объем утечек данных вырос
В 2025 году в сеть попало более 767 млн записей с данными россиян. Утечек стало меньше по числу случаев, но сами они стали крупнее.

📃 Рост рынка российского ПО замедлился
В 2025 году рынок вырос на 19%, тогда как годом ранее рост составлял 30%. Основные причины — высокая ключевая ставка, сокращение бюджетов и более осторожный подход компаний к ИТ-закупкам.

📃 Nvidia наращивает инвестиции в AI-инфраструктуру
Компания вложит по $2 млрд в производителей фотонных компонентов Lumentum и Coherent. На этом фоне мировые игроки продолжают вкладываться в развитие AI-инфраструктуры, а требования к технологиям для дата-центров постепенно растут.
  • 👍 3
  • 🔥 2
Post #2696 1.54K
💐 С 8 Марта, прекрасная половина ИТ-вселенной!

Пусть в жизни будет поменьше багов, побольше поводов для радости, надёжное окружение, быстрый отклик на доброту и стабильная работа не только у систем, но и у настроения.

Спасибо вам за ум, силу, юмор и красоту, с которой вы справляетесь даже там, где всё давно пора было перезагрузить.

С праздником!
  • 😁 8
  • 👏 7
  • ❤ 4
  • 😱 1
Post #2695 1.44K
🔮 fortune

Предсказания прямо в терминале

Классическая консольная утилита, которая достает из терминальной вселенной послания специально для тебя 🃏

🧑‍💻 Установка:


# Ubuntu/Debian
sudo apt install fortune-mod

# Fedora
sudo dnf install fortune-mod

# Arch/Manjaro
sudo pacman -S fortune-mod

# macOS
brew install fortune


Пример:


user@ubuntu::~ $ fortune
What do you have when you have six lawyers buried up to their necks in sand?
Not enough sand.

user@ubuntu:~ $ fortune
There is no education that is not political. An apolitical
education is also political because it is purposely isolating.

user@ubuntu::~ $ fortune
Hacker's Law:
The belief that enhanced understanding will necessarily stir
a nation to action is one of mankind's oldest illusions.

user@ubuntu:~ $ fortune
QOTD:
All I want is more than my fair share.


P.S. И еще оракул предсказал, что в эти выходные будет много цветов и красоты 🌸

#rootoffun
  • 👍 5
  • 😁 4
  • ❤ 3
Post #2694 1.37K
🖥 dig (domain information groper) — мощная утилита для выполнения DNS-запросов и получения детальной информации о доменах. Входит в состав пакета dnsutils (Debian) или bind-utils (RHEL). Незаменима при поиске проблем с резолвингом, проверке зон и отладке DNS-серверов.

⚙️ Как работает?

dig отправляет DNS-запрос указанному серверу (или системному резолверу по умолчанию) и выводит полученный ответ в структурированном виде. В отличие от nslookup или host, dig показывает полную информацию: заголовки запроса, секции ответа, время отклика и статистику.

➡️ Основные примеры использования

Простой запрос A-записи


dig cortel.cloud

; <<>> DiG 9.20.20 <<>> cortel.cloud
;; global options: +cmd
;; Got answer:
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 48488
;; flags: qr rd ra; QUERY: 1, ANSWER: 1, AUTHORITY: 0, ADDITIONAL: 1

;; OPT PSEUDOSECTION:
; EDNS: version: 0, flags:; udp: 4096
;; QUESTION SECTION:
;cortel.cloud. IN A

;; ANSWER SECTION:
cortel.cloud. 4746 IN A 95.181.181.7

;; Query time: 174 msec
;; SERVER: 77.88.8.8#53(77.88.8.8) (UDP)
;; WHEN: Tue Mar 05 11:15:58 +03 2026
;; MSG SIZE rcvd: 57


Запрос к определённому DNS-серверу


dig @8.8.8.8 cortel.cloud # использовать DNS Google


Краткий вывод (только ответ)


dig cortel.cloud +short

95.181.181.7


Полезные опции

— +noall +answer — показать только секцию ответа.
— +stats — добавить статистику (время, размер).
— +tcp — использовать TCP вместо UDP.
— +dnssec — запросить DNSSEC-данные.

dig даёт полную картину происходящего с доменом: от простого резолвинга до анализа всей цепочки делегирования. Это must-have для любого администратора, который занимается сетями или хостингом.

#линуксятина
  • ❤ 6
  • 👍 6
  • 🔥 4
Post #2693 1.33K
ExternalDNS — это Kubernetes-контроллер, который автоматически управляет DNS-записями у внешних провайдеров на основе ресурсов кластера. Он отслеживает появление, изменение и удаление Ingress, Service (типа LoadBalancer) и других объектов и соответствующим образом обновляет DNS-зону, избавляя от ручного вмешательства.

⚙️ Основной функционал:

— Автоматическое создание/обновление DNS записей у указанного DNS-провайдера.
— Удаление устаревших записей: при удалении ресурса запись автоматически убирается из DNS-зоны.
— Гибкая настройка источников: может работать с Ingress, Service (type=LoadBalancer), а также с Gateway API и другими CRD.
— Фильтрация и области видимости: позволяет ограничить синхронизацию конкретными namespace, аннотациями или доменами.

Ключевые особенности:

▪️ Декларативность и согласованность —
состояние DNS всегда соответствует реальному состоянию сервисов в кластере. Никаких рассинхронизаций.

▪️ Поддержка ownership —
еxternalDNS помечает созданные им записи специальными тегами (или TXT-записями), чтобы не трогать записи, созданные вручную.

▪️ Гибкая настройка TTL —
можно задавать время жизни записей как глобально, так и через аннотации к конкретным ресурсам.

ExternalDNS превращает управление DNS из рутинной ручной работы в автоматический, декларативный процесс, интегрированный с жизненным циклом приложений в Kubernetes. Это исключает ошибки при указании IP, ускоряет развертывание новых сервисов и гарантирует, что DNS всегда соответствует реальной инфраструктуре кластера.

👉 Git
#полезное
  • 🔥 5
  • 👍 2
  • 👏 2
Post #2692 1.4K
💻 Как работает DNS в Kubernetes?

В Kubernetes поды динамически создаются и удаляются, их IP-адреса меняются. Использование конкретных адресов невозможно, поэтому в кластере функционирует внутренняя DNS-система, позволяющая обращаться к сервисам по именам.

CoreDNS — стандартный DNS-сервер Kubernetes. Он работает внутри кластера, как набор подов. Основная задача — обработка DNS-запросов от всех подов кластера.

При создании Service (например, app в namespace dev) Kubernetes API передаёт его имя и IP в CoreDNS. а он автоматически создаёт A-запись (или SRV, если необходимо).

➡️ Формирование DNS-имени ресурса в кластере.

Система строится вокруг домена кластера (по умолчанию — cluster.local).

Для сервиса (Service). Полное имя (FQDN) имеет вид: <service-name>.<namespace>.svc.cluster.local

🔵Пример: Для сервиса redis-cash в namespace stage полное имя — redis-cash.stage.svc.cluster.local. Под из любого другого namespace может обратиться к нему по этому имени.

🔵Короткая форма: Внутри одного namespace можно использовать только имя сервиса — redis-cash. DNS-запрос автоматически дополнится до полного имени благодаря настройкам поиска в /etc/resolv.conf пода.

➡️ Проблема масштабирования CoreDNS

В крупных кластерах с тысячами подов CoreDNS испытывает высокую нагрузку. Каждый новый под генерирует множество DNS-запросов. Для решение этой проблемы используется кеширующий агент NodeLocalDNS, который работает на каждой ноде кластера.

➡️ Принцип работы:

1. На каждой ноде под node-local-dns работает в режиме hostNetwork.
2. Правила iptables настраиваются так, чтобы трафик к сервису kube-dns не покидал ноду, а перехватывался локальным агентом.
3. Агент слушает локальный адрес (например, 169.254.20.10) и кеширует ответы.

Понимание того, как устроены CoreDNS и NodeLocalDNS, даёт ключ к быстрой диагностике проблем сетевой связности в кластере. Часто за внешними симптомами падения сервиса скрывается не ошибка в коде, а некорректная работа DNS-инфраструктуры — и умение разобраться в ней превращает непонятный инцидент в рутинную задачу с быстрым решением.

#заметкиИнженера
  • ❤ 5
  • 👍 3
  • 🔥 3
  • 👏 2
Post #2691 1.29K
Post #2690 1.5K
🕵️‍♀️ Shadow Data — рабочие данные, которые существуют вне официального учёта и контроля.

Они не отражены в реестрах, не входят в формальный контур защиты и не управляются через утверждённые процессы хранения и удаления.

Это могут быть выгрузки из CRM, копии клиентских баз, отчёты, дампы, архивы, таблицы с персональными данными и т.д.

Файл сохранили локально, переслали в личную почту, оставили в старом облаке или тестовой среде — и он перестал быть видимым для ИТ и ИБ.

❌ Риски от теневых данных.

❌ Неконтролируемый контур обработки данных
Данные существуют вне утверждённых систем и процессов защиты. Компания не управляет этим сегментом, но он влияет на общий уровень риска.

❌ Неучтённые доступы
Файлы могут храниться на личных устройствах, в сторонних сервисах или старых папках с устаревшими правами. Формально доступ ограничен, фактически — нет.

❌ Утечки
Именно такие копии чаще становятся источником инцидентов: потерянные ноутбуки, взлом личной почты, открытые ссылки в облачных хранилищах.

❌ Ответственность за ПДн и чувствительные данные
Даже если компания не знала о существовании конкретной копии базы клиентов, ответственность за защиту персональных данных остаётся.
Неучтённые данные не освобождают от требований законодательства.

❌ Инциденты и расследования
После утечки возникает вопрос: где ещё есть копии?
Если инвентаризации нет, расследование затягивается, а подтвердить полноту устранения последствий становится сложно.

🔍 Как обнаруживать и предотвращать

✅Инвентаризация данных
Понимание, какие типы информации существуют, где они должны храниться и кто за них отвечает. Без этого невозможно контролировать контур.

✅Data discovery (поиск и выявление данных в инфраструктуре) и сканирование хранилищ
Поиск чувствительных данных в файловых шарах, облаках, на рабочих станциях и в почтовых ящиках.

✅Контроль выгрузок и пересылок
DLP, мониторинг почты и облачных сервисов, ограничения на скачивание баз и массовые экспорты.

✅Минимальные привилегии и регулярный пересмотр доступов
Если доступ выдан на всякий случай и не пересматривается годами, риск только накапливается.

✅Политики жизненного цикла данных
Временные копии должны удаляться по регламенту, а не храниться бессрочно.

✅Процессы, а не только запреты
Если сотруднику проще обойти правила, чем получить легальный доступ, теневые данные будут появляться снова.

#полезное #гайды
  • 👍 5
  • ❤ 3
  • 🔥 3
  • 👏 2
Post #2689 1.27K
🎉 С Днем Хостинг провайдера!

Отпраздновали 1 марта, а поздравляем сейчас 🥳

Желаем стабильного аптайма, отсутствия критических инцидентов и предсказуемой нагрузки, надёжной инфраструктуры, роста без потери качества сервиса и благодарных клиентов!

Подборка статей: как строить надёжную инфраструктуру

✅ SLA на практике: что стоит за 99,9%

✅ SLI / SLO / SLA за 10 минут

✅ 5 ошибок при переходе в облако

✅ Информационная безопасность за 10 минут

✅ 152-ФЗ: как выполнить требования регуляторов

✅ Disaster Recovery за 15 минут

✅ Стратегии Disaster Recovery для бизнеса

#полезное
  • ❤ 5
  • 👍 4
  • 🔥 2
Post #2688 1.61K
🌐 Как работает DNS

Шпаргалка показывает путь от доменного имени до ответа сервера — какие узлы участвуют и как именно находится нужный IP.

1️⃣ Пользователь → браузер
— старт запроса.

Пользователь вводит домен (например, cortel.cloud ), браузер начинает поиск IP-адреса.

2️⃣ Кэш браузера / ОС
— первая проверка.

Если IP уже сохранён локально — он сразу используется. Если нет — запрос уходит дальше.

3️⃣ DNS-резолвер
— точка входа в DNS.

Браузер отправляет запрос резолверу (обычно провайдера или публичному DNS). Резолвер также проверяет свой кэш.

4️⃣ Root DNS Server
— начало цепочки поиска.

Если в кэше пусто, резолвер обращается к корневому серверу и получает указание на TLD-зону (.com).

5️⃣ TLD Name Server
— уровень доменной зоны.

TLD-сервер сообщает, какой авторитетный сервер отвечает за нужный домен.

6️⃣ Authoritative DNS Server
— финальный источник.

Возвращает конкретную запись A/AAAA — IP-адрес домена (например, 95.181.181.7).

7️⃣ Возврат и кэширование
— ускорение следующих запросов.

IP сохраняется в кэше резолвера и браузера, после чего передаётся клиенту.

8️⃣ HTTP-запрос
— получение контента.

Браузер обращается по IP к веб-серверу, отправляет GET-запрос и получает ответ (HTML страницы).

#полезное
  • 👍 17
  • 🔥 5
  • ❤ 2
  • 👏 2
Post #2687 1.62K
📝 Медицинские данные в облаке: как закрыть 152-ФЗ без своего ЦОДа

Сервис F.Doc перевёл обработку персональных данных пациентов в защищённое облако SafeCloud — без развертывания и аттестации собственного ИБ-контура.

✅ Проект закрыл сразу несколько задач: соответствие 152-ФЗ, защита медицинской тайны и стабильная работа сервиса без простоев при миграции.

👉 Как выстроили защищённый контур, почему отказались от on-prem и что это дало бизнесу — рассказали в новом материале.

#статья #изПрактики
  • 👍 7
  • ❤ 4
  • 🔥 4
  • 👎 1
Post #2686 1.62K
📖 Практическая безопасность Linux

Руководство по защите Linux-систем: от базовой архитектуры безопасности до настройки механизмов контроля доступа, аудита и реагирования на инциденты.

🔍 Рассматривается:

— архитектура безопасности Linux и модель прав доступа (DAC, MAC);
— механизмы контроля: SELinux и AppArmor;
— безопасная загрузка, аудит и журналирование событий;
— изоляция процессов и контейнеризация;
— защита памяти и настройка компилятора;
— методы шифрования и защиты данных;
— сетевая безопасность и контроль трафика;
— обнаружение атак и использование IDS/IPS;
— анализ инцидентов, сбор и разбор логов;
— основы цифровой криминалистики и постинцидентное восстановление.

Автор:
Александр Чайка
Издательство:
БХВ-Петербург, 2026 г.

#полезное #книги
  • 🔥 9
  • 👍 3
  • 👏 3
  • ❤ 2
Post #2685 1.44K
😵‍💫 Зомби-процессы в Linux: что это и как с ними бороться

Зомби (состояние Z в ps) — это завершившиеся процессы, которые всё ещё присутствуют в таблице процессов. Они ждут, пока родитель прочитает их код возврата через системный вызов wait(). После этого запись о процессе исчезает.

👻 Чем опасны?

Сами по себе зомби не потребляют ресурсы (CPU, память), но занимают слот в таблице процессов. Если родительский процесс никогда не вызывает wait(), зомби накапливаются. Когда таблица процессов заполняется, система перестаёт создавать новые процессы — это может привести к отказу сервисов. Кроме того, большое число зомби — явный признак бага в родительском приложении.

👻 Как найти?

Самый простой способ — использовать ps -eal или aux и grep состояние Z:


ps aux | grep ' Z '


Более детальный вывод с информацией о родителе:


ps -eal | awk '{ if ($2 == "Z") print $4, $14 }'


Здесь $2 — код состояния, $4 — PID, $14 — имя процесса.

✅ Как избавиться?

Если зомби уже есть, можно попробовать:

— Отправить сигнал SIGCHLD родителю (не всегда помогает, так как родитель может игнорировать сигналы).
— Завершить родительский процесс (если это возможно).
— Перезапустить сервис, который порождает зомби.

⚠️ Главное — не убивать зомби напрямую (kill -9 на PID зомби не работает, потому что процесс уже мёртв). Устранять нужно причину — родительский процесс.

Зомби-процессы — не страшно, если их немного. Но если их количество растёт, это повод заглянуть в код приложения и проверить, правильно ли оно обрабатывает завершение дочерних процессов.

#линуксятина
  • 👍 11
  • ❤ 6
  • 👏 3
Post #2684 1.23K
⚙️ netshoot — набор сетевых утилит для диагностики в контейнерах

Образ nicolaka/netshoot — это «швейцарский нож» для сетевой отладки в Kubernetes и Docker.

Внутри — десятки предустановленных инструментов, которые покрывают почти любую задачу: от простого ping до трассировки gRPC-запросов.

✅ Основной функционал:

— Базовые утилиты: ping, traceroute, mtr, dig, nslookup, host, whois.
— Продвинутая диагностика: tcpdump, tshark, netstat, ss, lsof.
— Тестирование производительности: iperf, iperf3, httping.
— Работа с HTTP/HTTPS: curl, wget, httpie, grpcurl, wrk, vegeta.
— Сетевые сканеры: nmap, masscan, hping3.
— Крипто/сертификаты: openssl, cfssl, ssh-client.
— Дополнительно: jq, drill, socat, netcat, socat, vim, git.

✅ Ключевые особенности:

— Всё в одном: не нужно подбирать отдельные образы под каждую задачу.
— Актуальность: образ регулярно обновляется, включаются новые версии утилит.
— Минимальный вес: базируется на Alpine, что позволяет быстро запускать контейнер даже на медленных соединениях.
— Идеален для Kubernetes: легко использовать с kubectl debug для создания эффемерных контейнеров прямо в поде.
— Гибкость: можно запускать как отдельный под для диагностики сети между сервисами.

👉 Git
#полезное
  • 🔥 7
  • 👍 4
  • 👏 2
Post #2683 1.2K
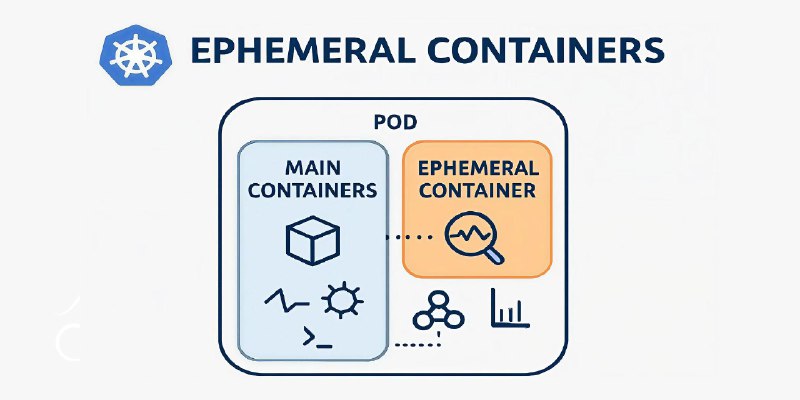
💻 Дебаг подов без боли: эффемерные контейнеры в Kubernetes

В версии Kubernetes 1.25 стала стабильной функция эффемерных контейнеров (ephemeral containers).

Она позволяет добавлять временные контейнеры прямо в уже работающий под для целей отладки — без его перезапуска и изменения оригинальной спецификации.
Это решает проблему дебага пода, когда в контейнере отсутствует даже базовый shell, а запуск отладочного пода рядом не даёт доступа к пространствам имён проблемного контейнера.

🤔 Как это работает?

Эффемерный контейнер добавляется через специальный ресурс EphemeralContainers или командой kubectl debug. Kubelet создаёт новый контейнер в том же поде, не перезапуская уже работающие контейнеры. Он разделяет с подом:

— Сеть (network namespace)
— Пространство имён PID (чтобы видеть процессы)
— Межпроцессное взаимодействие
— Тома

После завершения отладки контейнер остаётся в статусе Completed (или удаляется при использовании --rm), но не перезапускается.

🤔 Пример использования


kubectl debug my-app -it --image=nicolaka/netshoot -- bash


Эта команда запускает временный контейнер с образом nicolaka/netshoot (набор сетевых утилит) внутри работающего пода my-app. Благодаря общим namespace'ам контейнер получает доступ к процессам, файловой системе и сетевым интерфейсам оригинального пода — даже если его собственный образ собран на scratch. После завершения отладки контейнер останавливается, не влияя на работу приложения.

🤔 Когда это особенно полезно?

— Приложения на distroless/scratch — нет shell.
— Диагностика сети из контекста пода (curl, ping, tcpdump).
— Проверка состояния томов (например, emptyDir или ConfigMap).
— Анализ потребления ресурсов процессами (через / proc).

#заметкиИнженера
  • 🔥 5
  • ❤ 2
  • 👍 2
  • 👏 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →