TGViewer
Channel Public Channel
CORTEL

CORTEL

@cortel_cloud

Помогаем ИТ-директорам, DevOps и системным инженерам снижать TCO и поднимать SLA. Кейсы, инструменты и гайды.

Сайт:
https://cortel.cloud

Cотрудничество:
@ivan_cmo
Subscribers
4.07K
Photos
2K
Videos
165
Links
1.7K

Showing posts older than #2683 · Back to latest

Older Posts 20 shown
Post #2682 1.25K
🕵️‍♀️ Shadow IT — ресурсы вне контроля ИТ-службы: несанкционированные, неучтённые или забытые системы, сервисы и инфраструктура.

🎭 Как они появляются

Причины могут быть разными и зависят от компании. Где-то команды подключают сервисы без согласования, где-то остаются пилоты и временные решения, про которые забыли, где-то ресурсы теряются при смене сотрудников или подрядчиков.

В облаках это происходит особенно часто — создать ресурс просто, а процессы учёта и контроля не всегда за этим успевают.

🎭 Какие риски несут

❌ Расходы: появляются неучтённые платежи, дублируются сервисы, сложно понять, за что платит компания
❌ Безопасность: данные могут храниться вне контролируемого контура, доступы не отслеживаются
❌ Устойчивость: такие системы не входят в резервирование и планы восстановления
❌ Дополнительно: сложности с аудитом, поддержкой и зависимость от отдельных сотрудников

🙂 Как найти теневые ресурсы

✅Проверить расходы: счета, подписки, облачные биллинги, корпоративные карты — по ним видно сервисы, которые не проходят через ИТ

✅ Посмотреть трафик: DNS-запросы, прокси, CASB или SWG — показывают, какими внешними сервисами реально пользуются

✅ Проверить облака: аудит аккаунтов, проектов и ресурсов — часто находятся забытые VM, хранилища и тестовые среды

✅ Проверить доступы: какие учётные записи существуют, у кого есть права, какие сервисы привязаны к личным почтам — так выявляются «сиротские» ресурсы

✅ Поговорить с командами: часть инструментов не видна технически — о них можно узнать только от пользователей

#полезное #гайды
  • 👍 7
  • 🔥 3
  • 👏 3
Post #2681 1.3K
⚖️ Законы для ИТ и связи

👀 Правительство утвердило новые правила определения критичности ИТ-систем в банках и финсекторе. Теперь учитываются отраслевые особенности — влияние на операции, клиентов и устойчивость сервисов, — и от этого зависят не только требования к защите, но и к самой инфраструктуре.

👀 Подписан закон, по которому операторов связи обязали приостанавливать услуги по требованию ФСБ (вступает в силу в марте 2026). Важно заранее продумать резервирование и альтернативные каналы связи.

👀 Специальные энергетические зоны для размещения ЦОД под задачи ИИ обсуждают в России — с приоритетным доступом к мощности и упрощённым подключением к сетям.

#ИТиЗАКОН
  • 👍 6
Post #2680 1.61K
🧘 Nafas
— CLI-утилита с готовыми программами дыхательных упражнений.

Запускается прямо из терминала.

😤 Внутри:
— несколько режимов (Relax, Anti-Stress, Power и др.)
— заданный ритм: вдох / задержка / выдох
— короткие сессии на 2–5 минут

Можно использовать в середине дня, чтобы восстановить концентрацию, после напряжённой задачи или перед важным созвоном.

✈️ Установка и запуск


pip install nafas
nafas


P.S. хороших праздничных выходных 🎉

#rootoffun
  • 👏 6
  • 👍 5
  • 🔥 4
Post #2679 1.75K
🖥 Что такое ЦОД по 152-ФЗ в понимании РКН?

Ошибки в трактовке статуса ЦОДа напрямую влияют на уведомление об обработке ПДн, уровень защищённости ИСПДн и распределение ответственности между оператором и провайдером.

Выложили эпизод из вебинара про инфраструктуру для ПДн.

В видео:
— нормативное определение ЦОДа;
— разница между обычным и аттестованным ЦОДом;
— ограничения по уровням защищённости;
— где находится ЦОД при использовании 1С, Bitrix и облаков;
— как корректно определить границу ответственности.

🤓 Смотрите на наших площадках:
▶️ Rutube
▶️ YouTube
▶️ VK Видео

#полезное
  • 👍 7
  • ❤ 6
  • 🔥 5
Post #2678 1.45K
Post #2677 1.24K
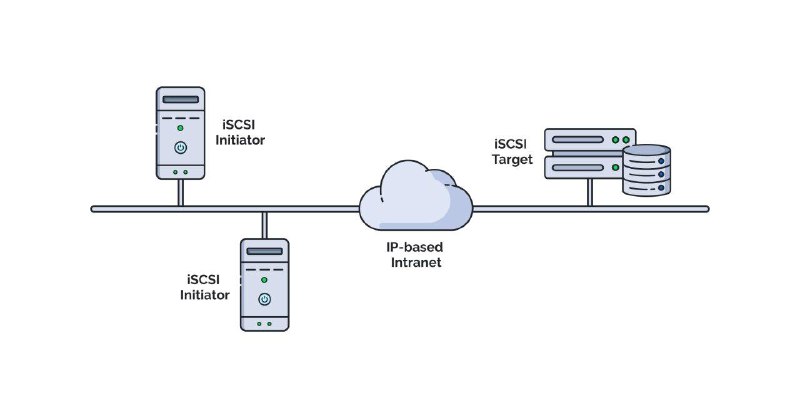
🚪 iSCSI (Internet Small Computer System Interface)— протокол блочного доступа, инкапсулирующий команды SCSI в TCP/IP.

Позволяет подключать удалённые блочные устройства по IP-сети так, будто это локальный диск.

➡️ Архитектурная модель iSCSI:
— Target — сервер, предоставляющий блочные устройства (LUN).
— Initiator — клиент, подключающийся к таргету и получающий доступ к этим устройствам.

➡️ Установка и настройка iSCSI Target


# Установка (Debian/Ubuntu):
sudo apt install tgt


Конфигурация — файл /etc/tgt/conf.d/debian.conf. Пример создания LUN:


debian.conf
<target iqn.2026-02.example:storage.lun1>
backing-store /dev/sdb # или путь к файлу-образу
initiator-address 192.168.1.0/24 # разрешённые инициаторы
</target>

После изменения конфигурации перезапустите службу:


sudo systemctl restart tgt


➡️ Установка и основные команды для iSCSI Initiator


# Установка (Debian/Ubuntu)
sudo apt install open-iscsi

#Обнаружение таргетов
sudo iscsiadm -m discovery -t sendtargets -p <IP_таргета>

#Подключение к таргету
sudo iscsiadm -m node -T <IQN> -p <IP> --login

#Просмотр активных сессий
sudo iscsiadm -m session

#Отключение
sudo iscsiadm -m node -T <IQN> -p <IP> --logout


ISCSI превращает IP-сеть в гибкое хранилище уровня SAN — бесплатная альтернатива Fibre Channel для виртуализации, кластеров и бэкапов. open-iscsi (инициатор) и tgt (таргет)/

#линуксятина
  • 👏 6
  • ❤ 4
  • 🔥 2
Post #2676 1.19K
🔄 HAProxy — высокопроизводительный балансировщик нагрузки и прокси-сервер для TCP/HTTP-приложений.

Он де-факто стал стандартом для распределения трафика в высоконагруженных системах. Используется для обеспечения отказоустойчивости, масштабирования и маршрутизации запросов между бэкенд-серверами.

💬 Основной функционал

— L4/L7 балансировка:
Работает на транспортном (TCP) и прикладном (HTTP/HTTPS) уровнях, поддерживает различные алгоритмы распределения (roundrobin, leastconn, source и др.).
— Проверки доступность (health checks):
Регулярно опрашивает бэкенды, автоматически исключает отказавшие узлы и возвращает их при восстановлении.
— Терминирование SSL:
Может расшифровывать HTTPS-трафик, снимая нагрузку с серверов приложений.
— Поддержка Keep-Alive и HTTP/2: Оптимизирует соединения для уменьшения задержек.
— Подробная статистика:
Встроенная страница статистики в реальном времени (метрики запросов, состояние серверов, ошибки).
— Гибкая маршрутизация:
Правила на основе заголовков, cookies, URL-путей (для HTTP) или IP/портов (для TCP).

💬 Ключевые особенности

— Производительность:
Работает в одном потоке с событийной моделью, минимальное потребление памяти, способен обрабатывать миллионы запросов в секунду на обычном оборудовании.
— Безопасность:
Защита от DDoS (ограничение соединений, таймауты), поддержка ACL для фильтрации трафика.
— Конфигурация без перезагрузки:
Поддержка плавной перезагрузки (graceful reload) без потери соединений.
— Надёжность:
Используется в самых критичных средах (крупные банки, CDN, облачные провайдеры), доказанная стабильность.

✅ HAProxy остаётся стандартом индустрии благодаря сочетанию невероятной производительности, гибкости настройки и проверенной годами надёжности. Используется как краеугольный камень инфраструктуры в проектах любого масштаба.

👉 Git
#полезное
  • 👍 10
  • 👏 3
  • 🔥 2
  • ❤ 1
Post #2675 1.02K
✅ Node Readiness Controller: расширение логики готовности узлов в Kubernetes

Стандартные условия (Conditions) узла Kubernetes (Ready, DiskPressure, PIDPressure и др.) определяют возможность запуска подов. Однако в ряде сценариев этой информации недостаточно для корректной оценки состояния узла.

✅ Node Readiness Controller — компонент, появившейся в 2026 году, который расширяет механизм оценки готовности узлов. Он позволяет добавлять пользовательские условия готовности, влияющие на планирование подов, без модификации kubelet.

🔫 Область применения

— Ограниченность стандартных метрик: Kubelet маркирует узел как Ready при успешном ответе на запросы. При отказе CNI-плагина или container runtime узел может оставаться Ready, несмотря на неработоспособность подов.
— Выявление скрытых сбоев: Некоторые отказы оборудования или ОС не изменяют статус kubelet, но делают узел непригодным для выполнения рабочих нагрузок.
— Изоляция неисправных узлов: Контроллер централизованно переводит проблемные узлы в состояние NotReady или накладывает taints, предотвращая планирование подов.

🔫 Основные преимущества

✅ Гибкие условия готовности — Определение собственного набора проверок, которые узел должен пройти, чтобы считаться готовым к запуску подов. Например, верификация драйверов GPU, доступность CNI или корректная работа агентов observability.

✅ Автоматическое управление taints — Контроллер автоматически накладывает или снимает taints на узлы в зависимости от состояния заданных условий. Это предотвращает попадание подов на узлы, не прошедшие проверку, и освобождает их сразу после восстановления.

✅ Декларативная инициализация узлов — Многоэтапная подготовка узлов описывается в виде правил и выполняется предсказуемо. Ход инициализации отслеживается через статус ресурсов, что упрощает отладку и аудит.

🔫Основные концепции и особенности

➡️ Два режима работы
Непрерывный контроль — проверки выполняются постоянно на протяжении всего жизненного цикла узла. При отказе критического компонента (например, драйвера устройства) узел немедленно изолируется.
Одноразовая инициализация — проверки запускаются только при вводе узла в эксплуатацию. После успешного прохождения правила мониторинг прекращается.

➡️Интеграция через Node Conditions
Контроллер не выполняет проверки самостоятельно, а реагирует на условия узла (Node Conditions). Это позволяет использовать:
• Node Problem Detector (NPD) — кастомные скрипты диагностики;
• Readiness Condition Reporter — легковесный агент для проверки локальных HTTP-эндпоинтов и обновления условий.

➡️ Безопасное внедрение — Режим dry run имитирует применение правил без фактического воздействия на кластер. Контроллер логирует планируемые действия и отображает список затронутых узлов, позволяя проверить корректность конфигурации до включения защиты.

Node Readiness Controller дополняет стандартную логику kubelet, позволяя учитывать реальное состояние инфраструктурных компонентов и автоматически управлять доступностью узлов./

👉 Подробнее в официальном блоге k8s и в git репозитории Node Readiness Controller

#заметкиИнженера
  • 👍 8
  • ❤ 3
  • 🔥 2
Post #2674 1.1K
💻 Кейс: Виртуальные рабочие станции для металлургического холдинга на базе VDI

Цель — обеспечить быстрое подключение и масштабирование инженерных рабочих мест на отечественной платформе без закупки дорогостоящего оборудования.

📞 Задача

— Сократить время ввода новых инженеров в работу.
— Исключить зависимость от поставок высокопроизводительных рабочих станций.
— Обеспечить стабильную работу CAD/CAE-систем и ресурсоёмкого ПО.
— Централизовать управление рабочими местами и повысить уровень ИБ.
— Обеспечить масштабирование без длительных инфраструктурных проектов.

⭐️ Этапы реализации

— Провели аудит инженерных профилей нагрузки и требований к графике и вычислениям.
— Спроектировали архитектуру VDI на отечественной платформе с учётом GPU-профилей и отказоустойчивости.
— Развернули пилот и протестировали сценарии: 3D-моделирование, расчёты, совместная работа.
— Настроили единые образы рабочих мест и централизованное обновление ПО.
— Организовали регламент быстрого подключения новых сотрудников без закупки локального «железа».
— Внедрили мониторинг и поддержку 24×7.

🚩 Результат

— Сокращение сроков интеграции новых инженеров: рабочее место предоставляется в течение одного рабочего дня.
— Отказ от массовых закупок мощных ПК и снижение затрат на инженерную инфраструктуру.
— Централизованное управление версиями ПО и контроль доступа без выезда в регионы.
— Масштабирование ресурсов «по запросу» (CPU, RAM, GPU); CAPEX трансформирован в OPEX.
— Данные остаются в защищённом контуре дата-центра.

«Проект позволил ускорить подключение новых инженеров и сделать инфраструктуру предсказуемой с точки зрения затрат и управления», — представитель ИТ-блока ЕВРАЗа.


➡️ Подробнее о проекте читайте здесь
➡️ Все про VDI — здесь

#изПрактик
  • 🔥 5
  • 👍 4
  • 👏 3
  • ❤ 1
Post #2673 1.13K
🖥 Docker Hardened Images (DHI) стали бесплатными.

Это официально поддерживаемые базовые контейнерные образы (Alpine, Debian и популярные рантаймы), которые:
— регулярно пересобираются и получают обновления безопасности;
— сопровождаются VEX-аттестациями (указание, какие CVE неприменимы);
— снижают количество уязвимостей в базовых слоях.

➡️ Теперь ответственность делится по слоям контейнерного образа:

➡️ Базовые слои DHI — поддерживаются и обновляются Docker.
➡️ Слои приложения (код, зависимости, пакеты, добавленные в Dockerfile) — зона ответственности команды разработки.

Чем более высокоуровневый образ используется (например, сразу hardened Python вместо чистого Debian), тем меньше инфраструктурных уязвимостей остаётся в зоне контроля команды.

➡️ Что меняется в работе

1. Более предсказуемые результаты сканирования

Количество CVE в системных пакетах базового образа сокращается. Проще проводить триаж и приоритизацию.

2. Обязательные обновления

Образ не обновляется автоматически.
Необходимо:
• отслеживать выход новых версий DHI;
• обновлять digest базового образа;
• пересобирать и повторно деплоить сервис.


3. Более предсказуемая цепочка поставки

Используется поддерживаемый образ вместо community-вариантов, что снижает риски компрометации исходного источника.

4. Поддержка VEX

Часть CVE может быть помечена как неприменимая. Это позволяет корректнее настраивать политики сканирования и снижать количество ложных тревог.

👀 DHI — это более контролируемая и поддерживаемая база контейнеров, которая снижает количество уязвимостей в инфраструктурном слое, но не снимает ответственности за безопасность самого приложения.

#полезное
  • 👍 8
  • 👏 3
  • 🔥 2
  • ❤ 1
Post #2672 1.22K
💻 Ультимативная шпаргалка по командам Kubernetes

От управления кластером до эксплуатации.

➡️ Команды для управления кластером
— kubectl cluster-info , kubectl config get-contexts , kubectl get nodes , kubectl describe node.
Информация о кластере, работа с контекстами, список узлов, состояние нод.

➡️ Общие команды
— kubectl get , kubectl describe , kubectl apply , kubectl delete , kubectl edit.
Просмотр ресурсов, детализация, применение манифестов, удаление, редактирование объектов.

➡️ Команды для управления деплойментами
— kubectl create deployment , kubectl scale deployment , kubectl rollout status , kubectl rollout history , kubectl rollout undo.
Создание, масштабирование, контроль обновлений, история релизов, откат версии.

➡️ Команды для работы с подами
— kubectl get pods , kubectl logs , kubectl exec -it , kubectl port-forward.
Проверка статуса, просмотр логов, подключение внутрь контейнера, локальная отладка.

➡️ Команды для сервисов и сети
— kubectl get svc, kubectl expose, kubectl get ingress.
Публикация сервисов, настройка доступа, маршрутизация трафика.

➡️ Команды для эксплуатации кластера
— kubectl get events , kubectl top pods , kubectl top nodes , kubectl describe.
События, потребление ресурсов, диагностика проблем в рантайме.

#полезное
  • 👍 8
  • 🔥 2
  • 👏 2
Post #2671 1.36K
🎙️ За неделю

📃 Госдума приняла в I чтении второй пакет мер по противодействию мошенничеству.
Расширяется обмен данными через ГИС «Антифрод» между операторами, банками и госорганами, предусматривается оперативное ограничение трафика по подозрительным номерам и внесудебная блокировка фишинговых ресурсов.

📃 Доля российских ИТ-продуктов превысила 50%.
Российские ИТ-решения в среднем на 55–60% состоят из отечественных компонентов. У программного обеспечения локализация выше — около 77%, а у оборудования — примерно 40%. Это отражает прогресс в импортозамещении софта, тогда как в аппаратной части остаются ограничения из-за нехватки своих компонентов.

📃 В 2026 бюджеты компаний смещаются в сторону ИТ и ИИ.
По данным Gartner, большинство компаний увеличивают технологические расходы, а почти половина закладывает рост более чем на 10%. При этом бюджеты на HR и расширение штата пересматриваются в сторону сдерживания.
  • ❤ 4
  • 👍 1
  • 😱 1
Post #2670 1.69K
💎 400 Гбит/с между ЦОДами на отечественном оборудовании

В Новосибирске мы построили кольцо связности между ЦОДами с пропускной способностью 400 Гбит/с — полностью на российском железе.

✅ Проект решает сразу несколько задач: отказоустойчивость без единой точки отказа, масштабируемость по пропускной способности и технологическую независимость от зарубежных вендоров.

👉 Зачем потребовалось кольцо, какие ограничения учитывали при проектировании и что это дает заказчикам — разобрали в новом материале.

#статья #изПрактики
  • 🔥 10
  • ❤ 5
  • 👏 5
Post #2669 1.68K
🤓 Ansible. Введение и практическое применение

Практическое руководство по автоматизации инфраструктуры и управлению конфигурациями: от базовых принципов до построения масштабируемых инфраструктурных решений.

Книга объясняет, как применять декларативный подход к управлению системами и выстраивать воспроизводимые процессы развёртывания, конфигурирования и оркестрации сервисов.

🔍 Рассматривается:

— архитектура Ansible: инвентарь (перечень хостов), модули, плагины, сценарии и роли;
— управление конфигурациями и автоматизация операционных задач;
— создание и структурирование сценариев и ролей;
— работа с переменными, шаблонами Jinja2 и динамическим инвентарём;
— оркестрация сложных инфраструктурных сценариев;
— автоматизация развёртывания приложений и конвейеров CI/CD;
— управление сетевыми устройствами, облачной и контейнерной инфраструктурой;
— тестирование, отладка и лучшие практики масштабирования Ansible-проектов.

📎 Акцент сделан на практическом использовании в корпоративной инфраструктуре и построении поддерживаемых IaC-решений.

Авторы:
Бас Мейер,
Лорин Хохштейн,
Рене Мозер.

Издательство:
O’Reilly Media, 2022 г.

#книги
  • 👍 8
  • 🔥 3
  • 👏 2
Post #2668 1.25K
🖥 DRBD (Distributed Replicated Block Device) — модуль ядра Linux для синхронной или асинхронной репликации данных между серверами на уровне блоков. Превращает локальные блочные устройства в распределённые, обеспечивая высокую доступность данных. Работает как сетевой RAID-1 между серверами.

📍 Как работает?

— Блочная репликация: Работает ниже файловой системы, реплицируя сырые блоки данных
— Три роли узлов: Primary (чтение/запись), Secondary (только чтение), Unknown (не определено)
— Протоколы репликации:
— Protocol A: Асинхронная запись — подтверждение после локальной записи
— Protocol B: Полусинхронная — подтверждение после записи на удалённый диск
— Protocol C: Синхронная — подтверждение после записи на оба диска (рекомендуется для HA)
— Сетевые соединения: TCP/IP для передачи данных, специальный протокол DRBD для метаданных
— Консистентность: Гарантирует, что данные на Secondary идентичны Primary

📍 Пример настройки

1. Установка (Ubuntu/Debian):


# Установка DRBD и утилит
sudo apt update
sudo apt install drbd-dkms drbd-utils

# Загрузка модуля ядра
sudo modprobe drbd

# Проверка загрузки
lsmod | grep drbd


2. Подготовка дисков (на обеих нодах):


# Предположим, что у нас есть дополнительный диск /dev/sdb
sudo parted /dev/sdb mklabel gpt
sudo parted /dev/sdb mkpart primary 0% 100%
sudo mkfs.ext4 /dev/sdb1


3. Базовая конфигурация (/etc/drbd.d/drbd0.res):


resource drbd0 {
protocol C; # Синхронная репликация

# Конфигурация первого узла (node1)
on node1 {
device /dev/drbd0; # Виртуальное устройство DRBD
disk /dev/sdb1; # Физический диск
address 192.168.1.10:7788; # IP и порт для соединения
meta-disk internal; # Метаданные хранятся на том же диске
}

# Конфигурация второго узла (node2)
on node2 {
device /dev/drbd0;
disk /dev/sdb1;
address 192.168.1.20:7788;
meta-disk internal;
}
}


4. Инициализация и запуск:


# На обоих узлах создаём метаданные
sudo drbdadm create-md drbd0

# Запускаем ресурс
sudo drbdadm up drbd0

# На node1 делаем первичным и форматируем
sudo drbdadm primary drbd0 --force
sudo mkfs.ext4 /dev/drbd0

# На node2 проверяем статус
sudo drbdadm status drbd0


5. Проверка работы:


# Статус репликации
sudo drbd-overview

# Детальный статус
sudo cat /proc/drbd

# Переключение ролей (с node1 на node2):
# На node1:
sudo drbdadm secondary drbd0

# На node2:
sudo drbdadm primary drbd0


📍 Ограничения и особенности

— Требует стабильной сети с низкой задержкой для синхронной репликации
— Поддерживает до 32 узлов (рекомендуется 2-3 для производительности)
— Может работать поверх LVM, RAID, SSD
— Совместим с большинством файловых систем (ext4, XFS, btrfs)

📎 DRBD — проверенное решение для построения отказоустойчивых кластеров на базе Linux, оно остаётся простым и эффективным выбором для двухузловых кластеров, где важна минимальная задержка и максимальная предсказуемость.

#линуксятина
  • 👍 13
  • 🔥 2
  • 👏 2
Post #2667 1.28K
📊 KRR (Kubernetes Resource Recommender) — утилита для Kubernetes, которая по реальным метрикам подсказывает, какие CPU/Memory requests и limits лучше выставить подам.

Внутри:

💬 Забирает историю потребления из Prometheus-совместимых систем (Prometheus/Thanos/VictoriaMetrics/Mimir и др.) и считает рекомендации по ресурсам.
💬 Показывает рекомендации по workload’ам и объясняет расчёт .
💬 Может работать как CLI или запускаться регулярно и отдавать отчёты .

Полезно:

💬 Платформенным и DevOps-инженерам — быстро навести порядок в requests/limits без ручного перебора.
💬 SRE/эксплуатации — меньше инцидентов из-за памяти/CPU и проще держать стабильность под 💬 Тимлидам и FinOps — понятный рычаг для оптимизации ёмкости кластера и затрат.

👍 Хороший инструмент, когда нужно опереться на данные и привести настройки к адекватным значениям.

#полезное
  • 👍 8
  • 🔥 2
  • 👏 2
Post #2666 1.18K
➡️ MetalLB — система балансировки нагрузки для Kubernetes-кластеров, работающих в bare-metal окружениях.

Она реализует сервисы типа LoadBalancer без облачных провайдеров, назначая внешние IP-адреса и управляя трафиком на уровне L2 (ARP/NDP) или L3 (BGP).

⚫️ Зачем это нужно?

— Bare-metal кластеры
Предоставляет функционал LoadBalancer в локальных дата-центрах или на оборудовании без поддержки облачных провайдеров

— Простота использования
Автоматически назначает внешние IP-адреса из указанного пула

— Два режима работы
Поддержка L2 (для простых сетей) и L3 (для интеграции с корпоративной инфраструктурой)

— Прозрачная интеграция
Работает как стандартный Kubernetes-контроллер, не требуя изменений в приложениях

⚫️ Как работает?

Режим L2 (Уровень 2 — канальный):

— Назначает виртуальный IP (VIP) сервису типа LoadBalancer
— Отвечает на ARP-запросы (IPv4) или NDP-запросы (IPv6) для этого IP
— Трафик направляется на одну из нод кластера, которая затем распределяет его между подами
— Автоматический аварийное переключение при выходе ноды из строя

Режим L3 (Уровень 3 — сетевой):

— Устанавливает BGP-сессии с маршрутизаторами сети
— Анонсирует маршруты к виртуальным IP-адресам
— Трафик направляется напрямую на ноды с подами сервиса
— Поддерживает балансировку через ECMP (Equal-Cost Multi-Path)

⚫️ Конфигурация для режима L2:


apiVersion: metallb.io/v1beta1
kind: IPAddressPool
metadata:
name: default-pool
namespace: metallb-system
spec:
addresses:
- 87.30.40.30-87.30.40.130

---
apiVersion: metallb.io/v1beta1
kind: L2Advertisement
metadata:
name: default
namespace: metallb-system
spec:
ipAddressPools:
- default-pool


⚫️ Конфигурация для режима L3 (BGP):


apiVersion: metallb.io/v1beta1
kind: IPAddressPool
metadata:
name: production-pool
namespace: metallb-system
spec:
addresses:
- 97.54.23.100/32
- 97.54.23.101/32

---
apiVersion: metallb.io/v1beta1
kind: BGPPeer
metadata:
name: router1
namespace: metallb-system
spec:
myASN: 64500
peerASN: 64501
peerAddress: 97.54.23.1
peerPort: 179

---
apiVersion: metallb.io/v1beta1
kind: BGPAdvertisement
metadata:
name: production
namespace: metallb-system
spec:
ipAddressPools:
- production-pool


⚫️ Пример использования


apiVersion: v1
kind: Service
metadata:
name: nginx-service
spec:
selector:
app: nginx
ports:
- port: 80
targetPort: 80
type: LoadBalancer


После применения MetalLB автоматически назначит IP из пула:

kubectl get svc nginx-service -o jsonpath='{.status.loadBalancer.ingress[0].ip}'

# 87.30.40.30


🤓 MetalLB закрывает критический пробел в bare-metal Kubernetes, предоставляя полноценную поддержку LoadBalancer-сервисов.

Он превращает локальный кластер в производственную платформу, сопоставимую по возможностям с облачными предложениями, сохраняя при этом контроль над инфраструктурой.

#заметкиИнженера
  • 🔥 6
  • 👏 2
  • ❤ 1
  • 👍 1
Post #2665 1.3K
🍅 Техника Pomodoro

Способ организации работы через короткие, фиксированные интервалы фокуса на работе и отдыха.

Метод помогает снизить утомляемость, убрать прокрастинацию и вернуть управляемость рабочему времени.

Цель — удерживать концентрацию и ограничивать когнитивную нагрузку за счёт понятных временных рамок.

🕔 Суть:

🔵 25 минут — сфокусированная работа над одной задачей;
🔵 5 минут — короткий перерыв;
🔵 после 4 циклов — длинный перерыв 15–30 минут.

👩‍💻 Пример:

Задача: подготовить аналитический отчёт. Объём большой, начать сложно.

С техникой рomodoro работа строится как серия коротких отрезков с понятным итогом:

✅ Первый отрезок — набросать структуру и понять, каких данных не хватает;
✅ Второй — собрать данные и источники;
✅ Третий — сформулировать основные выводы;
✅ Четвёртый — оформить графики и подписи.

После четырёх циклов обязательно длинный перерыв.
Затем ещё один pomodoro, чтобы продолжить работу.

В итоге задача движется шаг за шагом, без ощущения перегруза и залипания в процессе.

#MentalDebug
  • 👍 10
  • 🔥 5
  • ❤ 4
Post #2664 1.29K
⚙️ Инструменты для управления конфигурацией и секретами в Kubernetes

➡️ External Secrets Operator - Kubernetes-оператор для автоматической синхронизации секретов из внешних систем (HashiCorp Vault, AWS Secrets Manager, GCP Secret Manager, Azure Key Vault) в нативные Kubernetes Secrets. Работает по принципу GitOps — отслеживает изменения во внешних источниках и обновляет секреты в кластере.

➡️ Vals - Инструмент для безопасного извлечения значений из различных источников (Vault, AWS Secrets Manager, GCP Secret Manager, SOPS, Age) прямо в конфигурационных файлах Helm, Kustomize и других. Позволяет использовать секреты без их явного хранения в репозитории.

➡️ SOPS - Редактор зашифрованных файлов, который позволяет хранить конфиденциальные данные (YAML, JSON, ENV) в Git. Поддерживает шифрование с помощью AWS KMS, GCP KMS, HashiCorp Vault, PGP и Age. Интегрируется с популярными инструментами GitOps.

➡️ Sealed Secrets - Решение от Bitnami для безопасного хранения секретов в Git. Состоит из двух частей: клиентского инструмента для шифрования секретов (только на локальной машине) и контроллера в кластере для их расшифровки. Секреты можно хранить в публичных репозиториях.

#полезное
  • 👍 6
  • 🔥 3
  • 👏 2
  • ❤ 1
Post #2663 1.21K
🚪 5 стратегий кэширования

Шпаргалка от Bytebytego показывает, как распределяется работа с данными между приложением, кэшем и базой данных, и как это влияет на скорость работы системы и актуальность информации.

💬 Application
— сервис, который обслуживает запросы.

Именно он решает: читать из кэша или БД, и как синхронизировать данные (в зависимости от выбранной стратегии).

💬 Cache
— быстрый слой (например, Redis/Memcached).

Держит «горячие» данные рядом с приложением, чтобы снижать задержку на чтении и разгружать БД.

💬 Database
— источник истины для данных.

Хранит полные и долговечные данные, но доступ к ней обычно медленнее и дороже по нагрузке, чем к кэшу.

💬 Cache Aside (Lazy Loading)
— приложение читает кэш, если нужных данных там нет, оно идёт в БД, забирает результат и само кладёт его в кэш.

Кэш заполняется по факту запросов. Просто внедрять, но при отсутствии данных в кэше получается цепочка запросов и возможна устаревшая информация, если БД обновили в обход приложения.

💬 Read Through
— если кэш не содержит запрошенных данных, то он сам, используя встроенный механизм, обращается к БД, заполняется и возвращает результат приложению.

Логика приложения упрощается, но усложняется кэш (нужен механизм/плагин, чтобы кэш умел получать данные из БД).

💬 Write Around
— запись сразу в БД, кэш не обновляется; кэш наполнится позже через чтения.

Подходит для данных, которые после записи редко читают. Минус — кэш может долго не содержать актуальных значений, и первые чтения будут уходить в БД.

💬 Write Through
— запись идёт в кэш, а кэш сразу синхронно пишет в БД.

Кэш и БД остаются согласованными, но запись становится медленнее: операция считается успешной после фиксации в БД.

💬 Write Back (Write Behind)
— запись идёт в кэш, а в БД — асинхронно и «пачками».

Даёт очень быструю запись и разгружает БД, но повышает риск потерь при сбое кэша и усложняет восстановление/контроль доставки в БД.

#полезное
  • 👍 8
  • 🔥 3
  • 👏 2
  • 👎 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →