TGViewer
Channel Public Channel
Complete AI

Complete AI

@complete_ai

Меня зовут Андрей Кузнецов

Руковожу управлением в Sber AI, построил успешную лабораторию FusionBrain в AIRI, один из основателей Kandinsky, к.т.н., 15+ лет опыта в Computer Vision, выступаю с лекциями и пишу о событиях в AI и ML
Subscribers
7.86K
Photos
517
Videos
38
Links
288

Showing posts older than #500 · Back to latest

Older Posts 13 shown
Post #498 2.42K
⚡️Второй день воркшопов на ECCV’24 также оставил у меня в памяти несколько интересных инсайтов. Я постарался уделить время воркшопам по GenAI для видео, а также внутренним знаниям о визуальных концептах в генеративных моделях.

Из первого был интересный доклад профессора из University of Massachusetts Chuang Gan (H-index=69), который рассказывал о комбинации видео и дифференцируемой физики как способе построения моделей мира. Видео сами по себе не способны быть достоверным предсказанием каких-либо событий, но добавляя обуславливание на законы физики можно научить модель «прогнозировать будущее». Также он показал модель 3D-VLA, у которой помимо понимания видео на входе есть промежуточный блок с диффузией, который генерирует «воображение», то есть несколько шагов вперед относительно текущего состояния, чтобы лучше прогнозировать следующее действие.

Во втором воркшопе доклад бесспорного классика для многих специалистов в компьютерном зрении David Forsyth (H-index=88) был коротким, но максимально полезным. Он посвятил выступление открытым вопросам в части интерпретируемости моделей генерации изображений и как внутри моделей «располагаются» разные концепты, а также какими «знаниями» располагают модели синтеза изображений. А также почему с генерацией одних типов объектов модели справляются, а с другими нет. Ответами на эти вопросы сейчас занимаются многие ученые, поэтому это скорее был визионерский доклад о вызовах в области понимания «внутрянки» архитектур. Подсветил некоторые работы в этом направлении и исследовательские задачи на ближайшее время💪

В комментариях выложу фото избранных слайдов по обоим докладам👇

@complete_ai
  • 👍 21
  • 🔥 15
  • 💯 2
  • 😁 1
Post #492 2.78K
Из того, что запомнилось особенно за сегодня на ECCV’24 — доклад лидера команды Wayve (которые в том году выпускали статью про свою модель Gaia-1 для генерации видео в стиле видеорегистратора — эдакая модель мира).

Сначала он рассказал про модели описания сцены Lingo, а также датасет LingoQA. Вторая версия (выпустили в апреле этого года) Lingo-2 умеет также решать задачу определения 3D положения объектов (граундинг), что добавляет к качеству текстовых описаний и ответам на вопросы.

И далее перешел к довольно свежей модели CarLLaVA, выпущенной в июне. Входные кадры с фронтальной камеры делятся на 2 части, кодируются визуальным энкодером LLaVA-Next, фичи объединяются и далее через проектор по классике добавляются в LLM. В итоге получается супер SoTA на CARLA челлендже (отрыв от прошлогодней соты — 458%). Видео демка тут

@complete_ai
  • 🔥 19
  • ❤ 5
  • 💯 3
  • 👎 1
  • 😁 1
Post #491 2.55K
ECCV 2024. Day 1. Workshops and Tutorials
  • 🔥 30
  • 👍 10
  • 💯 4
  • 👎 2
  • ❤ 1
Post #490 2.48K

Forwarded from Институт AIRI

Новый рекорд исследователей AIRI в этом году — сразу 17 статей принято на NeurIPS🔥

Поздравляем всех авторов!
  • 👏 68
  • 🔥 22
  • 👍 4
Post #487 3.25K
👨‍🏫 Век живи — век учись

Сегодня на конференции Practical ML Conf мы провели мастер класс по методам файнтюнинга диффузионных моделей — это чтобы за небольшое время и на малом объёме данных и вычислительных ресурсов сделать из генеративной модели кастомную конфетку😏

Рассказали и показали какими способами можно файнтюнить модели (LoRA, IP Adapter и др.), какие плюсы и минусы у каждого подхода. Всё это проходило в live режиме, и участники могли сами попробовать разные сценарии работы.

📆На следующей неделе мы отдельно проведём запись мастер класса, и я им сразу поделюсь с вами: там будет и про SD, и про Kandinsky😉
  • ❤ 43
  • 🔥 14
  • 👏 11
  • 👍 2
  • 🏆 1
Post #483 3.84K
⚡️Новый релиз лаборатории FusionBrain в конце рабочей недели

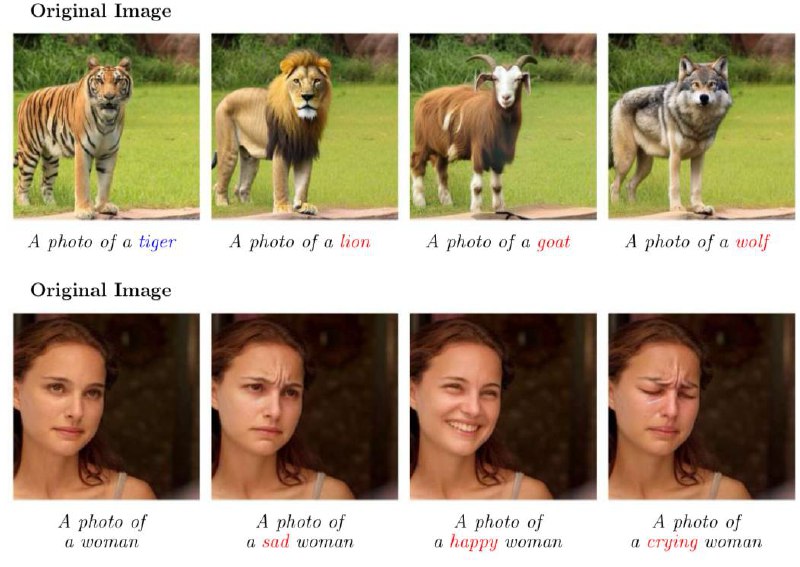
Представляем вам Guide-and-Rescale — новый способ редактирования изображений с помощью диффузионных моделей, принятый на Core A* конференцию ECCV 2024! Наш метод позволяет менять объекты на картинке, стиль изображения или эмоции на лице по текстовому описанию, сохраняя структуру и детали, которые не должны меняться.

По ссылкам ниже можно найти демо и код👇
🟢GitHub
🟢Google Colab
🟢Hugging Face
Также мы закинули статью на Daily Papers и надеемся на вашу поддержку🤝

Будем рады вашим отзывам, звёздам и апвоутам! ⭐️

Саму работу читайте на arXiv и на хабре.

За деталями можно залетать в канал Айбека, который как раз руководит научной группой Controllable GenAI в лабе, разработавшей этот подход
  • 🎉 25
  • ❤ 13
  • 🔥 7
  • 🏆 2
  • 🆒 1
Post #482 3.63K
🎉Торжественно завершили Летнюю школу AIRI 2024

Ребята прошли очень напряженный интенсив в части лекционной нагрузки, параллельно прокачивали проекты и сегодня их защищали. Это был крутой путь, выбирать среди представленных 25+ проектов всего 3 лучших было сложно, но мы справились💪

Всем участникам желаю удачи, ПИШ ИТМО большое спасибо за площадку и помощь в организации, ну а мы немного выдохнем, соберём обратную связь, порефлексируем и начнём продумывать Школу в 2025 году!

В следующих постах расскажу про тройку лидеров😉
  • 🔥 47
  • ❤‍🔥 9
  • 👍 8
  • ❤ 1
  • 👏 1
Post #481 3.51K
Complete AI Qwen сегодня на ACL подробно рассказывали про свою новую мультимодальную архитектуру Qwen2-VL. Работает с картинками, видео. Умеет работать с разными разрешениями, добавили специальные позиционные эмбеддинги, чтобы процессить видео.
⚡⚡⚡Вот и пожаловал релиз Qwen2-VL

https://qwenlm.github.io/blog/qwen2-vl/

Две ключевых фишки подсветили, как и на выступлении на ACL:
1) работа с динамическим разрешением входных изображений (без даунсэмплинга картинок по умолчанию), а энкодер ViT-600M работает как для картинок, так и для видео на входе
2) мультимодальные ROPE, чтобы можно было работать с пространсовенно-временной информацией

We opensource Qwen2-VL-2B and Qwen2-VL-7B with Apache 2.0 license, and we release the API of Qwen2-VL-72B

UPD:
Статью с деталями обещают скоро
Qwen Qwen2-VL: To See the World More Clearly DEMO GITHUB HUGGING FACE MODELSCOPE API DISCORD After a year’s relentless efforts, today we are thrilled to release Qwen2-VL! Qwen2-VL is the latest version of the vision language models based on Qwen2 in the Qwen model familities. Compared with Qwen-VL,…
  • ❤‍🔥 10
  • 🔥 5
  • ❤ 1
  • 🏆 1
Post #479 3.79K
👋Всем привет!

В моей команде работает много талантливых молодых учёных и скрывать их — настоящее преступление. Я горжусь ребятами и буду знакомить вас с ними ❤️

В этом году к лаборатории FusionBrain AIRI присоединилась крутая команда Controllable Generative AI под началом Айбека Аланова, которая нацелена усилить генеративное направление 💪 (между прочим он руководит ещё и Центром глубинного обучения и байесовских методов в НИУ ВШЭ). Айбек занимается исследованиями в области генеративных моделей и публикуется вместе с командой на топовых международных конференциях:
🟢все статьи можно почитать тут
🟢избранные свежие работы: StyleDomain на ICCV 2023 и StyleFeatureEditor на CVPR 2024

Разные подходы по персонализированной генерации изображений, стилизация картинок различными способами, объяснение сложных вещей простыми словами и многое другое — это всё к нему😉

👉Недавно он создал свой тг-канал AI Brain, где будет делиться мыслями и материалами для погружения в Gen AI, разбирать научные статьи, а заодно рассказывать о команде и последних исследованиях! Очень рекомендую подписаться 💯
  • 🔥 43
  • ❤ 9
  • 💯 4
  • ❤‍🔥 2
Post #478 3.71K

Forwarded from Уставший техдир

Разгоняют новость, что во Франции Дурова приняли, с формулировкой "создатель сервиса зашифрованных сообщений", чтож запасаемся попкорном)

UPD: Его там серьезно набутыливают на 20 лет 😞
  • 😱 36
  • 🤨 7
  • 🌚 3
  • 🤓 2
  • 👎 1
Post #475 4.2K
ℹ️Делюсь интересным мероприятием на тему RAG, где будет участвовать мой хороший знакомый и отличный специалист в области NLP — Валентин Малых.

Кому интересно послушать про RAG, и с чем его едят — советую сходить послушать Валю и других спикеров.

Информация о событии👇
https://t.me/valuableai/53
Telegram Valuable AI небольшой анонс мероприятия с моим участием, приходите, кому интересно послушать про RAG детали мероприятия можно посмотреть здесь (нужна регистрация): https://t.me/compressaai/6
  • 👍 23
  • ❤ 4
  • 🔥 2
Post #474 4.35K
⚡⚡⚡Свежайший крутой апдейт от OpenAI

Теперь файнтюнинг GPT-4o доступен всем
https://openai.com/index/gpt-4o-fine-tuning/
Today, we’re launching fine-tuning for GPT-4o, one of the most requested features from developers. We are also offering 1M training tokens per day for free for every organization through September 23.


Файнтюнинг GPT-4o обойдётся в 25$ за 1М токенов, а инференс — в 3.75$ за 1М входных токенов и 15$ за 1М выходных токенов. Как сказано выше, файнтюн GPT-4o-mini будет бесплатным до 23 сентября.

Конечно же, обещают безопасность ваших данных😉
Fine-tuned models remain entirely under your control, with full ownership of your business data, including all inputs and outputs. This ensures your data is never shared or used to train other models


Побежали скорее что-нибудь тюнить 🏃
  • 🔥 16
  • ❤ 9
  • 👍 4
  • ⚡ 1
Post #471 2.92K
На просторах интернета нашел забавный тест, который позволяет посоревноваться с современными языковыми моделями в навыке предсказывания следующего слова в тексте💪

Если знаете инглиш, то можете посоревноваться 🥊

👉В бой

Я набрал 4/15 баллов. Пишите свои результаты в комментариях😏
  • 🔥 15
  • 👍 5
  • 💯 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →