
⚡️Вчера ByteDance выпустил новую супер модель Bagel, которая базируется да трансформере декодере и решает широкий спектр задач понимания и генерации мультимодальных данных (картинки, видео). Модель умеет как понимать разные модальности, так и генерировать их и вносить изменения (например, редактировать картинку по текстовой инструкции)
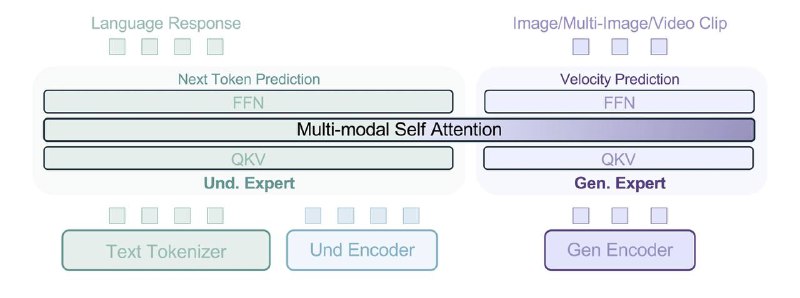
Архитектурно это MoE архитектура с двумя типами экспертов: Understanding и Generation. В опен сурс выложена 7B модель (7 млрд. активных параметров, всего их — 14 млрд.)
Модель обучена на нескольких триллионах токенов (отдельная часть исследования посвящена росту качества от увеличения числа токенов на обучении для визуальных генеративных задач), которые включают очень разнообразные задачи: от описания изображений до видеороликов, сопровождаемых траекториями движения. Также проработан механизм подробной фильтрации данных (UI removal, контроль разрешения и др.) Обучение проходит в 3 этапа: 2 фазы претрейна и 1 файнтюнинг. Что интересно, у модели прокачаны и способности к рассуждениям (thinking mode inside💪).
📍Интересная фишка — Next Group of Token Prediction подход, при котором модель учат предсказывать группу текстовых или визуальных токенов в целях повышения скорости и компрессии.
👉Статья
👉Hugging Face
P.S. Обязательно изучаем и дружим с Cursor😉
Post #665
4.62K


- 👍 6
- 🔥 5
- ❤ 1
- 🏆 1