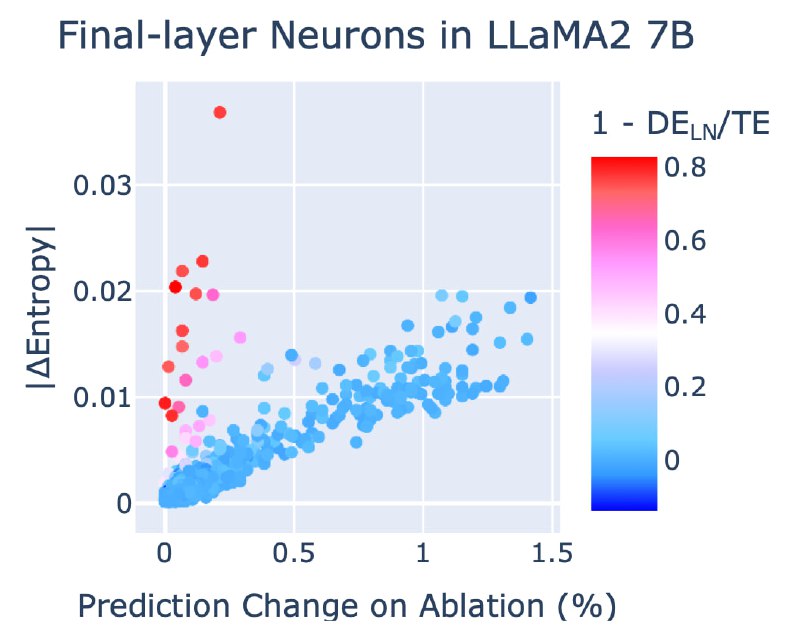
В языковых моделях есть различные типы нейронов, например, нейроны знаний. Такого рода исследования позволяют двигаться в сторону интерпретируемости LLM, что на мой взгляд является одним из интереснейших направлений в исследованиях в настоящее время.
Помимо нейронов знаний, ещё например, существуют нейроны «уверенности», которые не влияют на предсказание следующего токена, но отвечают исключительно за степень уверенности модели в своих ответах☝️
В посте Антона есть подробности
Post #430
3.17K