


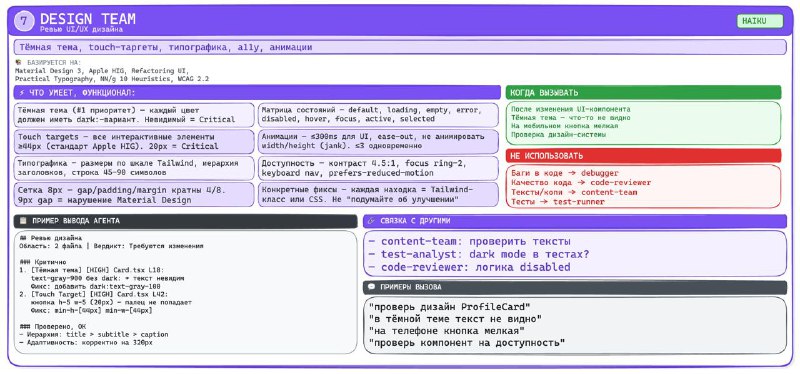


У Claude Code есть суперсила - субагенты. Это специализированные помощники, каждый из которых натренирован на одну конкретную задачу.
Представь команду из 9 экспертов, каждый из которых мастер в своём деле:
• один ревьюит код
• другой ищет баги
• третий анализирует производительность
• четвёртый следит за текстами в интерфейсе
Все 9 агентов, которыми я делюсь - это готовые .md-файлы. Ты просто кладёшь их в папку проекта, и они начинают работать. Никаких дополнительных настроек, плагинов или зависимостей.
Как установить:
Шаг 1: Скачай все 9 файлов:
code-reviewer.md
test-runner.md
test-analyst.md
debugger.md
performance-profiler.md
software-architect.md
design-team.md
content-team.md
text-polisher.md
Шаг 2: Создай папку в проекте
В корне проекта, там, где лежит package.json или другие главные файлы, создай папку:
.claude/agents/
Claude Code автоматически подхватывает агентов из папки .claude/agents/. Никаких дополнительных настроек не нужно.
Как вызывать агентов
Просто напиши в Claude Code, что тебе нужно, и упомяни агента. Claude сам поймёт, какого агента запустить по контексту запроса.
Используй test-runner субагент чтобы прогнать тесты
Можно и без явного упоминания агента - Claude Code сам матчит запрос по описанию каждого агента и запускает нужного. Например, если ты напишешь "проверь код перед пушем", он сам вызовет code-reviewer.
P.S. Я так же добавил тригеры для вызова от житейского текста:"звучит как чатгпт, перепиши" или "на телефоне кнопка мелкая".
Потрать 10 минут и изучи каждого агента: тригеры и функционал, чтобы точно не упустить лишнее.
Важные принципы работы агентов
1. Агенты - ревьюеры, не редакторы. Каждый агент находит проблемы и пишет структурированный отчёт. Код правит основной Claude Code, он называется "оркестратор".
Это сделано специально для безопасности - агент анализирует, а решение о правках принимаешь ты.
P.S. не забудь проверить на возможность корректной оркестрации!
2. Агенты работают в связке. В отчёте каждого агента есть секция "Next Steps", где он рекомендует, каких ещё агентов вызвать. Например, performance-profiler после анализа скажет: "запустите test-runner для проверки" и "вызовите code-reviewer для ревью кэширования". Это создаёт цепочку проверок.
3. Memory - память между сессиями. Все 9 агентов используют persistent memory - память, которая сохраняется между вызовами. Чем больше ты используешь агента на проекте, тем умнее он становится:
• code-reviewer запоминает конвенции команды
• test-runner запоминает нестабильные тесты
• debugger запоминает типичные баги проекта
• content-team накапливает глоссарий терминов
Память хранится в папке .claude/ и переживает сессии.
4. Быстрые и мощные - выбирай по ситуации. Агенты используют разные модели Claude в зависимости от сложности задачи:
• Haiku: test-runner, design-team, content-team. Их можно гонять часто, не переживая за бюджет.
• Sonnet: code-reviewer, debugger, test-analyst, performance-profiler, software-architect, text-polisher. Более глубокий анализ, но чуть дороже.
В зависимости от своих возможностей и предполагаемых расходов токенов ты можешь поменять, всё по своим нуждам.
5. CLAUDE.md усиливает агентов. Если в корне проекта есть файл CLAUDE.md с конвенциями и правилами проекта, агенты будут его учитывать.
Это стандартный файл Claude Code, где описываются стандарты кодирования, архитектурные решения, стек технологий. Без него агенты тоже работают, просто без проектного контекста.
Советую прочитать / скормить своей LLM эту статейку для реализации CLAUDE.md
Так же учел переполнение контекстного окна и другие угловые моменты, чтобы агенты вели себя корректно. На своём приложении использовал похожие давно - но этих прямо таки улучшал последнюю неделю и тренировал на самых разных ситуациях.
——
Я буду дополнять этот пост по мере времени и улучшения агентов.
Вопросы? Пожелания? Уточнения? Буду рад прочитать в комментариях.
Всех агентов прикрепил в первом комментарии к этому посту
—-
UPD 11.02: Обновил code-review агента