Сотрудник говорит, что с нейросетью работает медленнее. Решение по этой фразе обычно принимают за минуту и на глаз, либо он саботирует, либо инструмент не годится. Прежде чем выбирать из двух, посмотрите, чем это закончилось у тех, кто пробовал измерить это всерьёз.
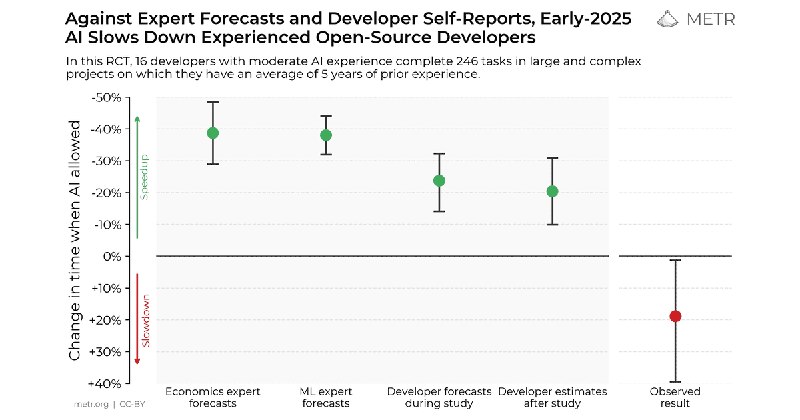
В 2025 году исследовательская группа METR взяла 16 опытных разработчиков open source и 246 реальных задач из их собственных репозиториев. С ИИ они решали задачи на 19% дольше, и это центральная оценка. До начала они ждали ускорения на 24%, а после, уже поработав, считали, что ускорились на 20%. То есть в среднем замедления на себе они не заметили. Это одна работа на одном типе людей и задач, а не отраслевой замер.
В феврале 2026 года та же группа отчиталась о попытке повторить замер на нынешних инструментах. Надёжной оценки не получилось. У прежних участников вышла оценка ускорения минус 18%, то есть снова замедление, но доверительный интервал растянулся от минус 38% до плюс 9%. У набранных заново минус 4% при интервале от минус 15% до плюс 9%. Оба интервала накрывают и замедление, и ускорение, то есть на вопрос "быстрее или медленнее" не отвечают. Цифру 2025 года повторить не удалось, и это вопрос к ней самой, а не только к спору про вашего сотрудника.
Помешали не инструменты, а то, кто согласился участвовать. Часть разработчиков отказалась работать без ИИ, тем более что оплату к этой волне снизили со 150 долларов в час до 50. Часть обходила стороной ровно те задачи, где ИИ помог бы сильнее всего. Сами исследователи пишут, что их оценка смещена вниз, но доказать это своими данными не могут и переделывают эксперимент.
Вот что здесь важно для вас. Люди, у которых на это есть годы, деньги и живые участники, со второй попытки написали честно: числа, на которое можно опереться, у них нет. А решение по вашему сотруднику принимают на одном человеке и за один разговор.
Один человек, это не данные. У него могла быть другая задача, он мог не спать ночь, мог не разобраться в инструменте и постесняться в этом признаться.
Прежде чем решать про человека и про инструмент, я бы посмотрел на три вещи. Замера уровня METR у вас не будет, и он не нужен: вам не надо доказывать эффект по отрасли, вам надо понять, что происходит на ваших задачах.
1) замер до. Если вы не знаете, сколько та же работа занимала месяц назад, любое число после внедрения будет ощущением, а не результатом
2) две группы на одинаковых задачах, одни работают с инструментом, другие как работали. Срок задаёт объём работы, а не календарь, сравнивать надо одинаковые куски
3) мерить время до готового результата и число переделок, а не количество обращений к модели и не объём написанного ей текста
И честное "но". Может выясниться, что человек прав, и на его задачах инструмент действительно замедляет, потому что за ним нужно перечитывать. Это не повод его убирать, это повод знать, на каких задачах он не нужен.
Пока нет замера до, спор про скорость, это спор двух мнений, и выигрывает его тот, кто громче.
Откуда числа: METR, исследование от 10.07.2025 (
metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/) и отчёт о попытке повторить его от 24.02.2026 (
metr.org/blog/2026-02-24-uplift-update/).
А у вас есть цифра, с которой можно сравнить?