ИИ умеет спорить. Но кто выносит суждение?
На уровне анализа проблема меняется. Генеративный ИИ уже не просто находит информацию или объясняет метод. Он способен предложить структуру данных, обнаружить закономерности, построить сценарии, сформировать аргументы и тут же сгенерировать контраргументы.
Для экономиста звучит почти идеально.
В нашем исследовании на уровне Analyse генеративный ИИ рассматривается как инструмент помощи в анализе данных и сценариев. Он может ускорять работу с большими массивами числовой и текстовой информации, помогать искать связи и расширять аналитическую перспективу. Но вместе со скоростью появляется другой риск: человек может принять не только вывод модели, но и предложенный ею способ разложить проблему на части, не заметив пропущенный контекст, спорное допущение или смещение в исходной рамке.
На следующем уровне, Evaluate, граница становится ещё тоньше.
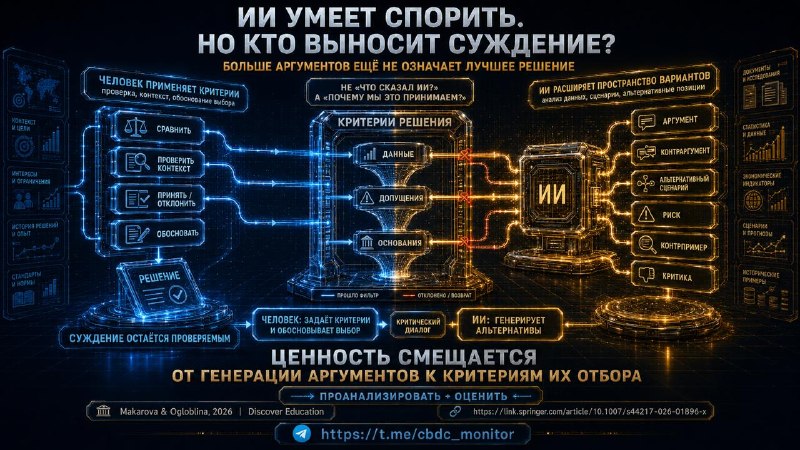
ИИ способен за секунды собрать аргументы «за» и «против», найти контрпример, раскритиковать текст и предложить альтернативную позицию. В статье мы поэтому рассматриваем одну из наиболее интересных функций модели как критического собеседника: не источника правильного решения, а оппонента, который заставляет человека объяснить собственное.
Разница принципиальная.
В слабой конструкции человек спрашивает: «Какой вариант лучше?» и получает готовое суждение.
В сильной конструкции он сначала задаёт критерии, затем просит ИИ атаковать его позицию, рассматривает альтернативы и фиксирует, какие аргументы принимает, какие отвергает и почему.
Модель в обоих случаях может написать одинаково убедительный текст. Но только во втором случае окончательное суждение остаётся проверяемой человеческой операцией.
Именно поэтому для Evaluate в нашей модели зона контроля широкая: недостаточно показать результат. Нужны явные основания принятия или отклонения предложений ИИ. В примере из статьи студент, оценивающий внешнеторговые данные UNCTAD, должен отдельно зафиксировать, какие контраргументы модели он принимает или отвергает и по каким критериям.
Здесь нужна важная оговорка. Доказательная база по Evaluate слабее, чем по Apply: выводы об оценочном диалоге опираются на исследования из маркетингового образования и высшей школы в целом, а не на прямую эмпирическую проверку в экономических аудиториях. В статье мы поэтому называем выводы для верхних уровней предварительными и требующими дальнейшей проверки.
Если перенести эту логику в профессиональную среду, появляется неудобная гипотеза. Чем лучше ИИ генерирует аргументы, тем ценнее становится не способность придумать ещё один аргумент, а способность задать критерий, по которому аргументы вообще будут приняты или отвергнуты.
Скорость анализа можно делегировать. Право на суждение уже сложнее.
Следующий шаг ещё чувствительнее: что происходит, когда ИИ перестаёт быть собеседником и становится соавтором результата?
Исследование:
Makarova, V., Ogloblina, E. (2026). Human–GenAI Interaction Across Bloom’s Levels in University Economics Education. Discover Education.
#АрхДенег_Интеллект
Читайте в MAX
😀 Архитектура денег
Post #2162
29