
Разбираем нашу статью, принятую на UAI 2026!
Markovian Compression: Looking to the Past Helps Accelerate the Future
[статья]
Обучаешь модель на куче устройств — и упираешься не в вычисления, а в коммуникации: узлы без конца шлют на сервер градиенты, канал захлебывается. Лечат это компрессией: отправляешь не весь вектор, а кусочек. Самый простой вариант — RandK: берём случайные K% координат, отправляем только их.
Но почти все компрессоры живут без памяти. Каждую итерацию заново тянут случайные координаты, как будто прошлых шагов не было. Одни улетают раз за разом, другие простаивают, а история отправок никак не учитывается. Жалко.
💡 Идея
Завязать выбор координат на прошлые итерации. Формально это марковская цепь — отсюда и название. Под описание попадает целый класс операторов, мы разбираем два:
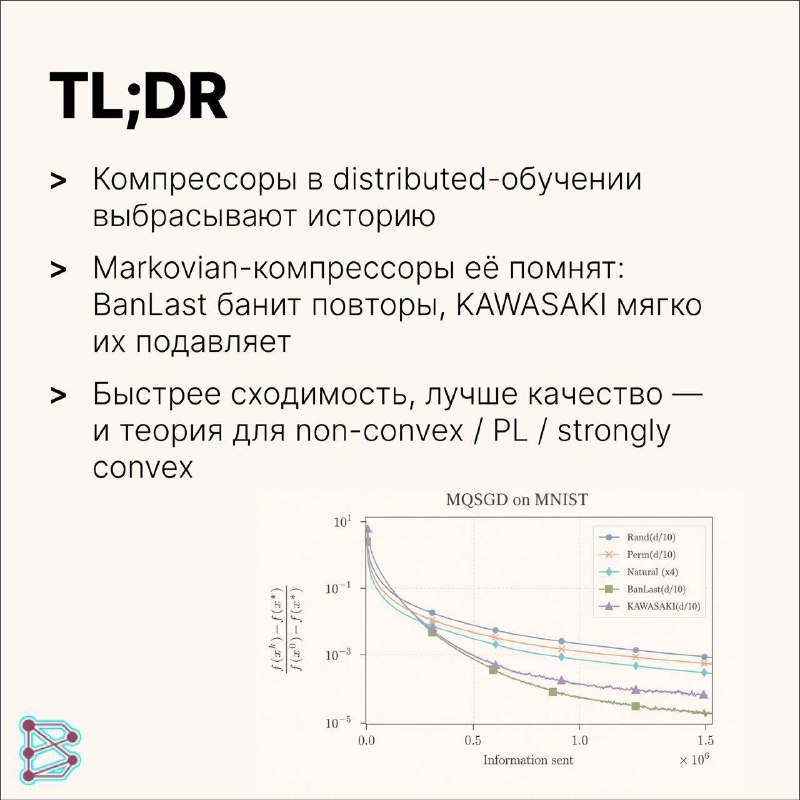
🔵BanLast(K) — обычная разреженная отправка, но координаты из последних $K$ шагов под временным запретом.
🔵KAWASAKI — то же мягче: недавним координатам не запрещаем выпасть, а просто снижаем вероятность.
Координаты перестают залипать, вектор покрывается ровнее.
⚙️ Куда вставлять
В обычный QSGD — получаем Markovian QSGD, с моментумом — Accelerated MQSGD. Те же операторы живут поверх DIANA и SGD. Своей архитектуры метод не требует: это просто компрессор, который докручивается к тому, что уже есть, и комбинируется с классическими вроде Natural.
📐 Теория
Сходимость доказана сразу для всего класса: оценки выписаны для произвольного марковского компрессора при эргодических условиях. Конкретный оператор подставляется в них со своими константами, теорема одна на всех. Покрыты non-convex, PL и сильно выпуклый случай, ускоренная версия обгоняет базовую.
📊 Цифры:
🔵Логрегрессия (MNIST, LibSVM): обе схемы быстрее RandK, PermK и Natural
🔵ResNet-18 / CIFAR-10: у KAWASAKI train loss 0.0305 против 0.0743, точность 89.05% против 87.9%
🔵DeBERTaV3 / GLUE: та же картина
На простых задачах BanLast и KAWASAKI идут вровень, но чем задача невыпуклее, тем заметнее: мягкое накопление истории бьет жесткий бан. Помнить прошлое полезно, копить память надо аккуратно.
Post #240
1.34K


- 🔥 9
- ❤ 5